SEO técnico

El capítulo completo, para imprimir

Las 13 entradas de SEO técnico en una sola página: 52 minutos de lectura. El botón abre el diálogo de impresión de tu navegador, donde podés elegir «Guardar como PDF».

Volver al capítulo

NichoSEO · Manual de SEO y GEO

SEO técnico

La capa que nadie ve y que, cuando falla, deja el resto del trabajo sin efecto. Las cuatro condiciones que tiene que cumplir una página para competir, y qué hacer cuando alguna no se cumple.

13 entradas · 52 minutos de lectura · última revisión del capítulo: 26 de sept de 2026

nichoseo.com/manual/seo-tecnico/

1 de 13

Qué es el SEO técnico: guía para principiantes con ejemplos

Tu página tiene que pasar cuatro filtros antes de competir por una posición. Cuáles son, qué los rompe y cómo revisarlos vos mismo en diez minutos.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 25 de sept de 2026

No trata sobre qué dice tu página. Tampoco sobre cuántos sitios la enlazan.

Trata sobre una sola cosa: si Google logra verla.

Se llama «técnico» porque casi todo vive en la parte del sitio que tus visitantes no ven. Cómo contesta el servidor. Qué hay dentro del código. Qué archivos de configuración tenés en la raíz del dominio.

Vos entrás a tu página y la ves perfecta. Google llega por otro camino y puede encontrarse con una puerta cerrada.

Ese es el problema que resuelve esta guía.

Cómo funciona Google: las 4 condiciones que tiene que cumplir tu página

Publicás una página. Para que aparezca en Google tienen que pasar cuatro cosas, en este orden.
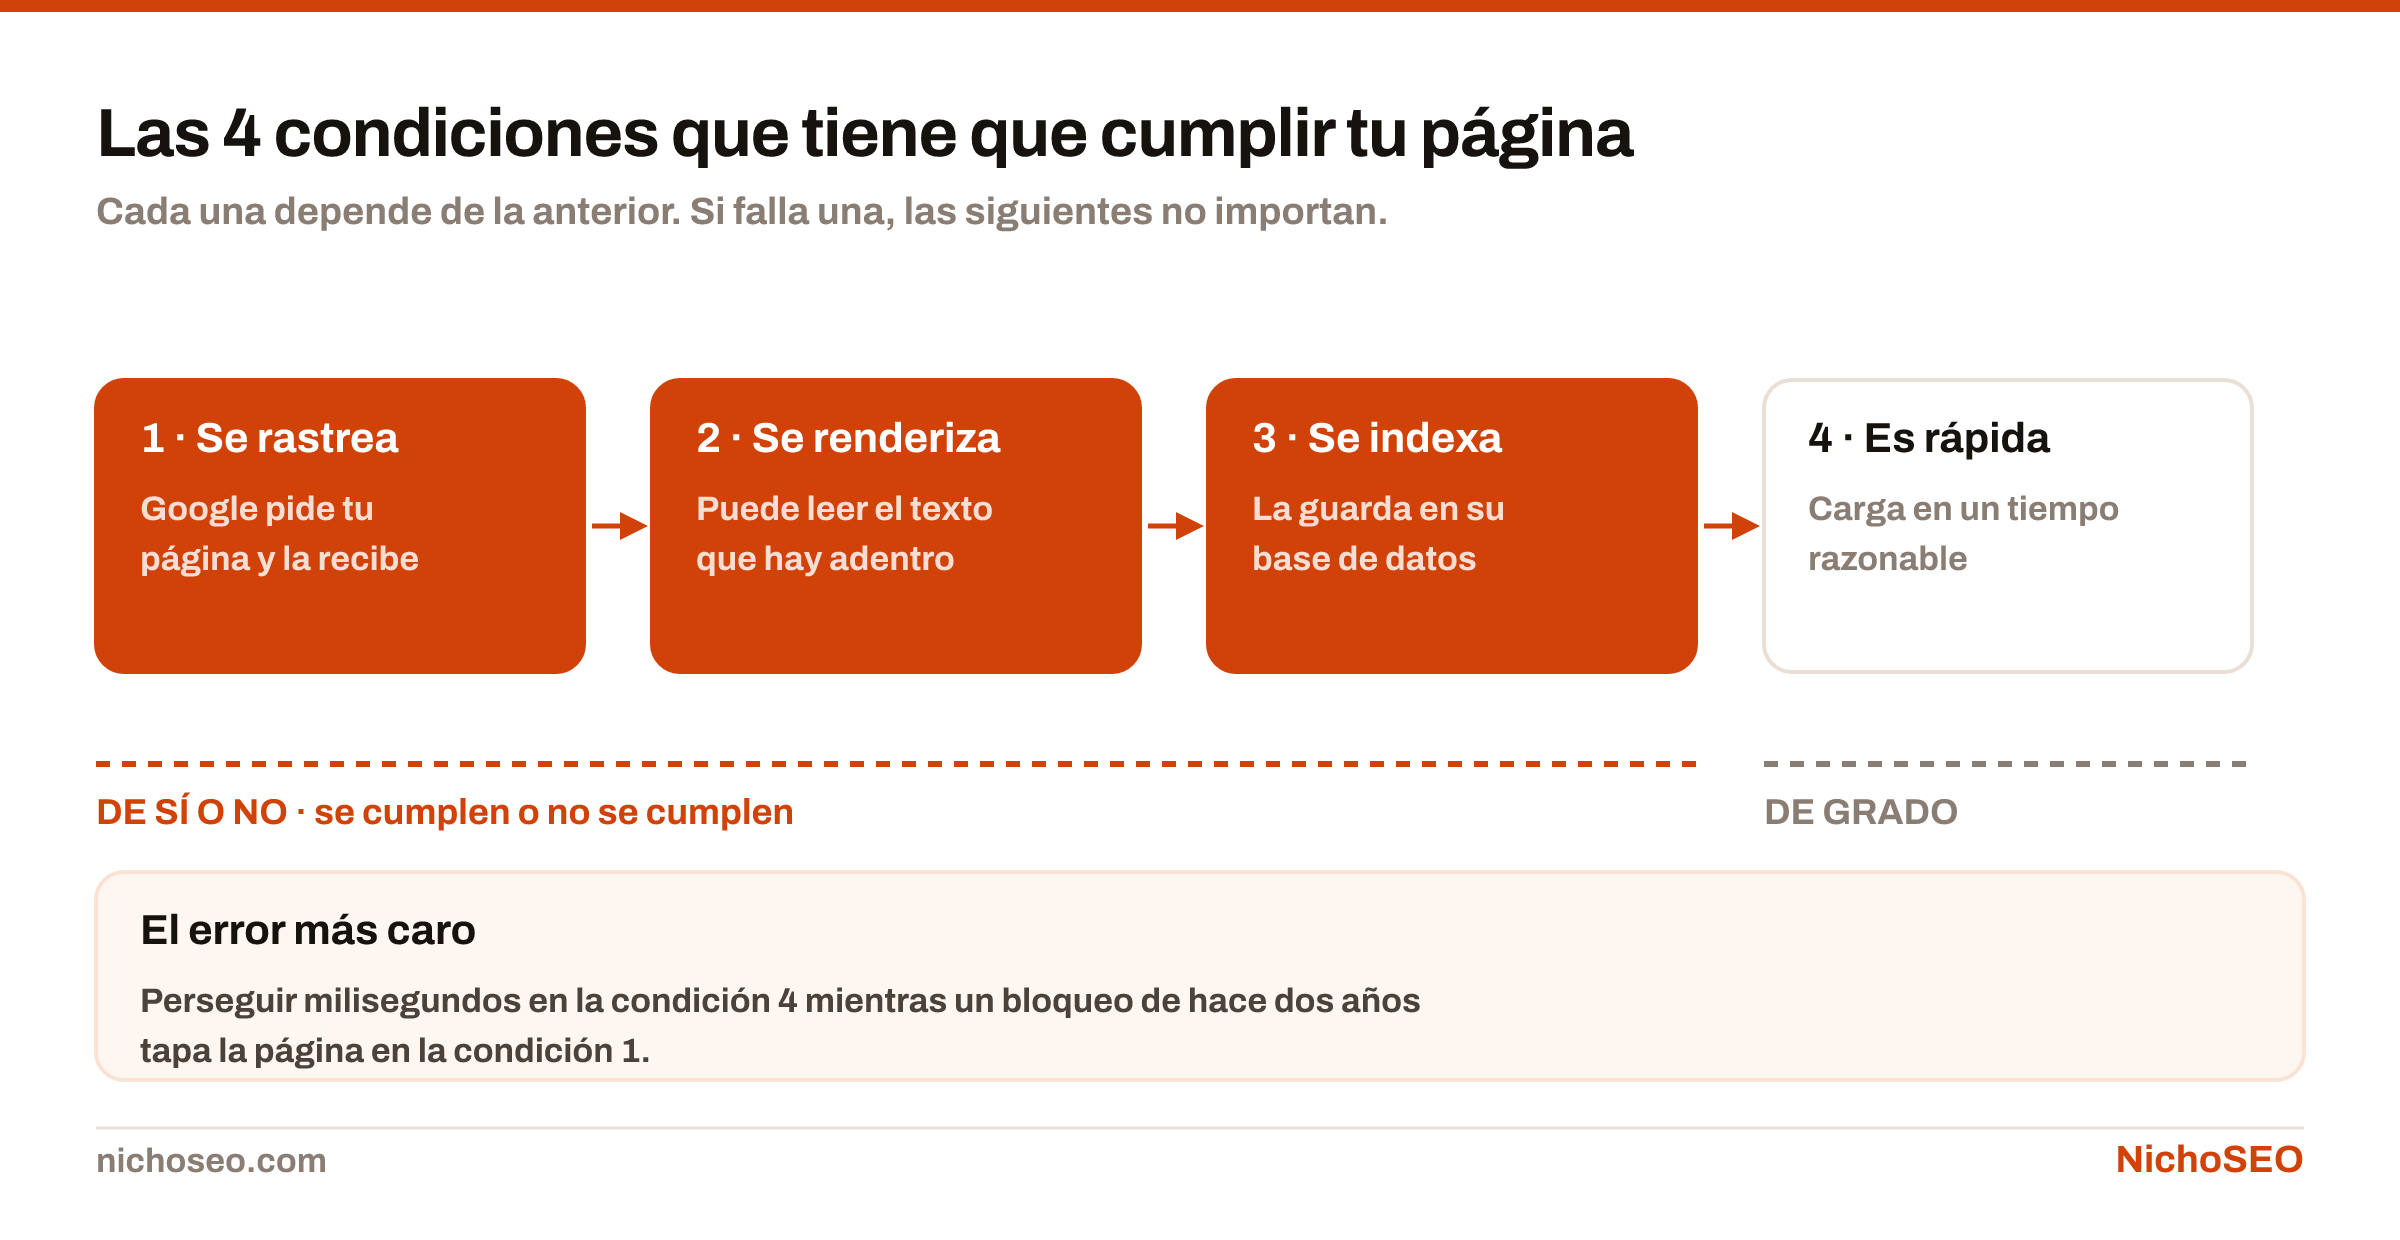
Las cuatro condiciones del SEO técnico en cadena: rastrear, renderizar, indexar y cargar rápido. Las tres primeras son de sí o no; la cuarta es de grado.
Cada una depende de la anterior. Si falla una, las siguientes no importan.Descargar imagen

1. Google tiene que poder pedir tu página y recibirla

Google manda un programa —un rastreador— que hace lo mismo que tu navegador: pide la dirección y espera la respuesta.

Esto se llama rastrear, y falla más seguido de lo que pensás:

  • Un archivo robots.txt que le dice «no entres acá».
  • Un servidor que contesta con un error en vez de con la página.
  • Una pantalla de login delante del contenido.
  • Un sistema de seguridad que confunde al rastreador con un atacante.

2. Google tiene que poder leer el texto

Lo que Google recibe es un archivo de texto: el HTML.

En muchos sitios modernos ese archivo llega casi vacío. El texto que vos ves lo arma el navegador después, ejecutando JavaScript.

Para vos es invisible. Para Google es trabajo extra: tiene que ejecutar ese código, lo hace más tarde y no siempre. Esto se llama renderizar.

Si tu texto solo aparece después de ejecutar JavaScript, estás apostando a que Google vuelva.

3. Google tiene que decidir guardar tu página

Leer tu página no lo obliga a quedársela. La guarda en su base de datos —la indexa— si le parece que vale la pena y si nada le indica lo contrario.

Hay tres formas de decirle «no la guardes» sin querer:

  • Una etiqueta noindex que quedó de cuando el sitio estaba en pruebas.
  • Una etiqueta canonical que apunta a otra página.
  • Veinte páginas tan parecidas que Google se queda con una sola.

4. Recién acá importa la velocidad

Tu página ya está guardada y compite por una posición. La velocidad entra como uno de los factores.

Uno de peso bajo, pero real.

Por qué el orden importa: las tres primeras son de sí o no

Las cuatro condiciones están encadenadas.

La segunda es la que más sorprende cuando el sitio arma el contenido en el navegador: qué ve Google en ese caso, y cuándo, está en JavaScript SEO.

Si Google nunca entró, no hay nada que leer. Si no pudo leer, no hay nada que guardar. Si tu página no está guardada, da igual cuánto tarde en cargar.

Y hay una diferencia entre las tres primeras y la cuarta que te va a ahorrar meses:

Las tres primeras: de sí o no

  • O Google entró o no entró.
  • O pudo leer el texto o no pudo.
  • O guardó la página o no la guardó.
  • Arreglarlo te devuelve a la competencia de golpe.

La cuarta: de grado

  • Una página puede ser más o menos rápida.
  • Mejorarla da un beneficio proporcional.
  • Nunca te saca de la competencia por sí sola.
  • Es la única donde tiene sentido afinar.
Las tres primeras se arreglan una vez y cambian todo. La cuarta se mejora de a poco y cambia un poco.

Revisá siempre en ese orden, aunque el síntoma apunte a otro lado.

La mayor parte del tiempo que se pierde en SEO técnico se va en optimizar la velocidad de una página que Google nunca llegó a pedir.

Por qué el SEO técnico no sube posiciones pero puede hundirlas todas

Vas a escuchar mucho que el SEO técnico no mejora posiciones. Es cierto, y conviene entender por qué.

Arreglar una redirección no hace que tu página suba puestos. Igual que arreglar la cerradura de un local no hace que entren más clientes.

Lo que hace es permitir que entren.

Pero la relación es despareja. Como las tres primeras condiciones son de sí o no, fallar una no te resta un poco: te saca de la competencia entera.

El mejor artículo del mundo en una página que Google no guardó no está en el puesto cincuenta. No está en ningún puesto.

Por eso el SEO técnico es el trabajo con mejor relación entre esfuerzo y resultado, y por eso se hace primero. Casi todos los problemas graves tienen una sola causa, se arreglan una vez y no vuelven.

La documentación de Google cubre cada uno por separado: robots.txt, etiquetas meta para robots y consolidar URLs duplicadas.

Los 6 errores de SEO técnico más frecuentes
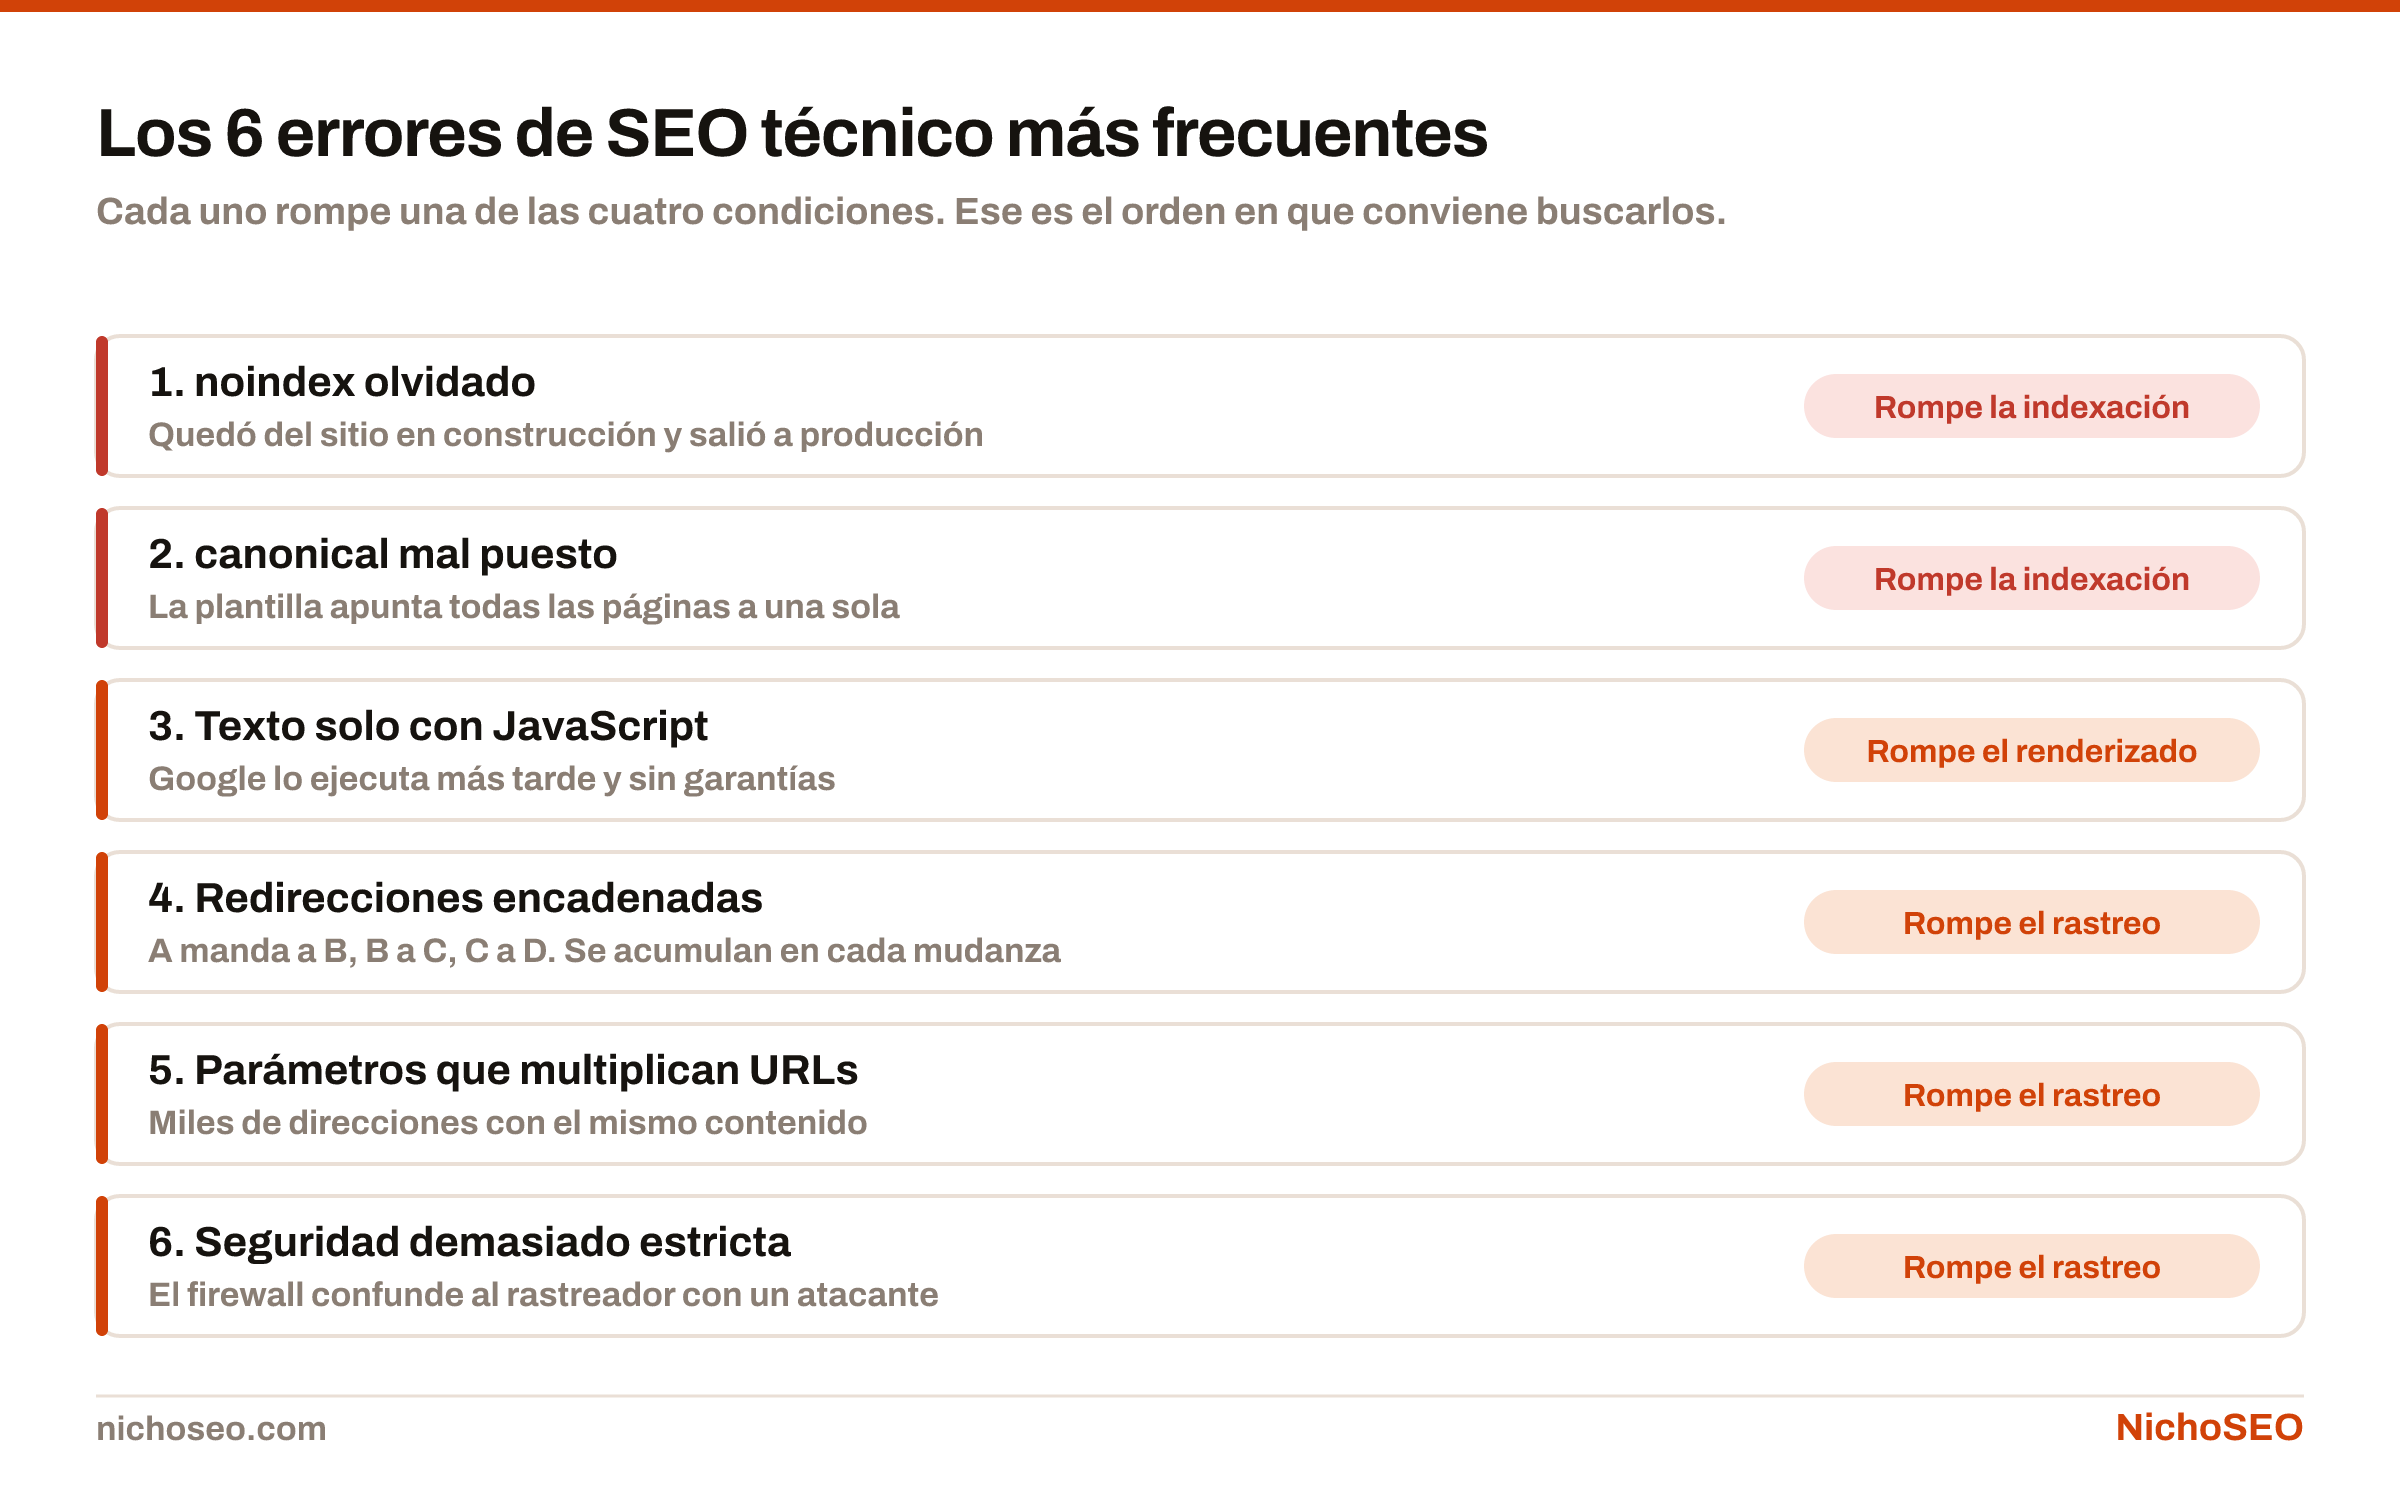
Los seis errores de SEO técnico más frecuentes, agrupados según qué condición rompen: rastreo, renderizado o indexación.
Cada uno rompe una de las cuatro condiciones. Ese es el orden en que conviene buscarlos.Descargar imagen

1. Un noindex olvidado. Rompe la indexación. Casi siempre viene de un sitio en construcción: le pediste a Google que no lo guardara mientras lo armabas, y esa instrucción salió a producción. Es el error más caro y el más fácil de encontrar.

2. Un canonical mal puesto. También rompe la indexación. El canonical le dice a Google cuál es la versión buena de una página cuando hay varias parecidas. Si tu plantilla pone el mismo canonical en todo el sitio, le estás diciendo que todas tus páginas son copias de una.

3. Texto que solo aparece con JavaScript. Rompe el renderizado. No es fatal, pero lo vuelve frágil. Si tu texto principal puede venir en el HTML, que venga.

4. Redirecciones encadenadas. Rompen el rastreo de a poco. A manda a B, B a C, C a D. Se acumulan en cada mudanza del sitio y nadie las revisa.

5. Parámetros que multiplican direcciones. Filtros y ordenamientos que generan miles de URLs con el mismo contenido. Google se pasa el día recorriendo variantes en vez de encontrar tus páginas nuevas.

6. Seguridad demasiado estricta. Rompe el rastreo de la forma más difícil de ver. Tu firewall bloquea al rastreador sin que nadie lo haya pedido. Solo aparece mirando los registros del servidor.

Cómo hacer una auditoría de SEO técnico sin herramientas de pago

No necesitás contratar nada para el primer diagnóstico. Con el navegador y una línea de terminal cubrís casi todo. A partir de cierto tamaño deja de alcanzar, y el umbral es más alto de lo que se cree: cuándo se justifica una herramienta de rastreo está medido en páginas.

Paso 1: comprobá que Google pueda entrar

Abrí una terminal y pedí tu página como la pediría un rastreador:

curl -I https://tusitio.com/una-pagina/

Esto te devuelve solo la respuesta del servidor, sin descargar el contenido.

  • Si ves 200, tu servidor la está entregando bien.
  • Si ves 403 o 500, ahí está tu problema.
  • Si ves X-Robots-Tag: noindex, encontraste un bloqueo en el único lugar donde casi nadie mira: fuera del código de la página.

Paso 2: comprobá que Google pueda leer tu texto

Abrí tu página y hacé clic derecho → «Ver código fuente».

Ojo: tiene que ser «ver código fuente», no el inspector. El inspector te muestra el resultado después de ejecutar todo, así que siempre se ve bien.

Buscá ahí un párrafo de tu artículo con Ctrl+F.

Si no está, tu texto depende de JavaScript.

Paso 3: comprobá que tu página esté guardada

Escribí esto en Google:

site:tusitio.com/una-pagina/

Si no aparece, la página no está indexada. Qué hacer desde ahí lo tenés en cómo indexar una página en Google.

Paso 4: medí la velocidad

Este ya necesita datos reales, y tiene su propia guía: Core Web Vitals.

Estos son los umbrales que hay que pasar:
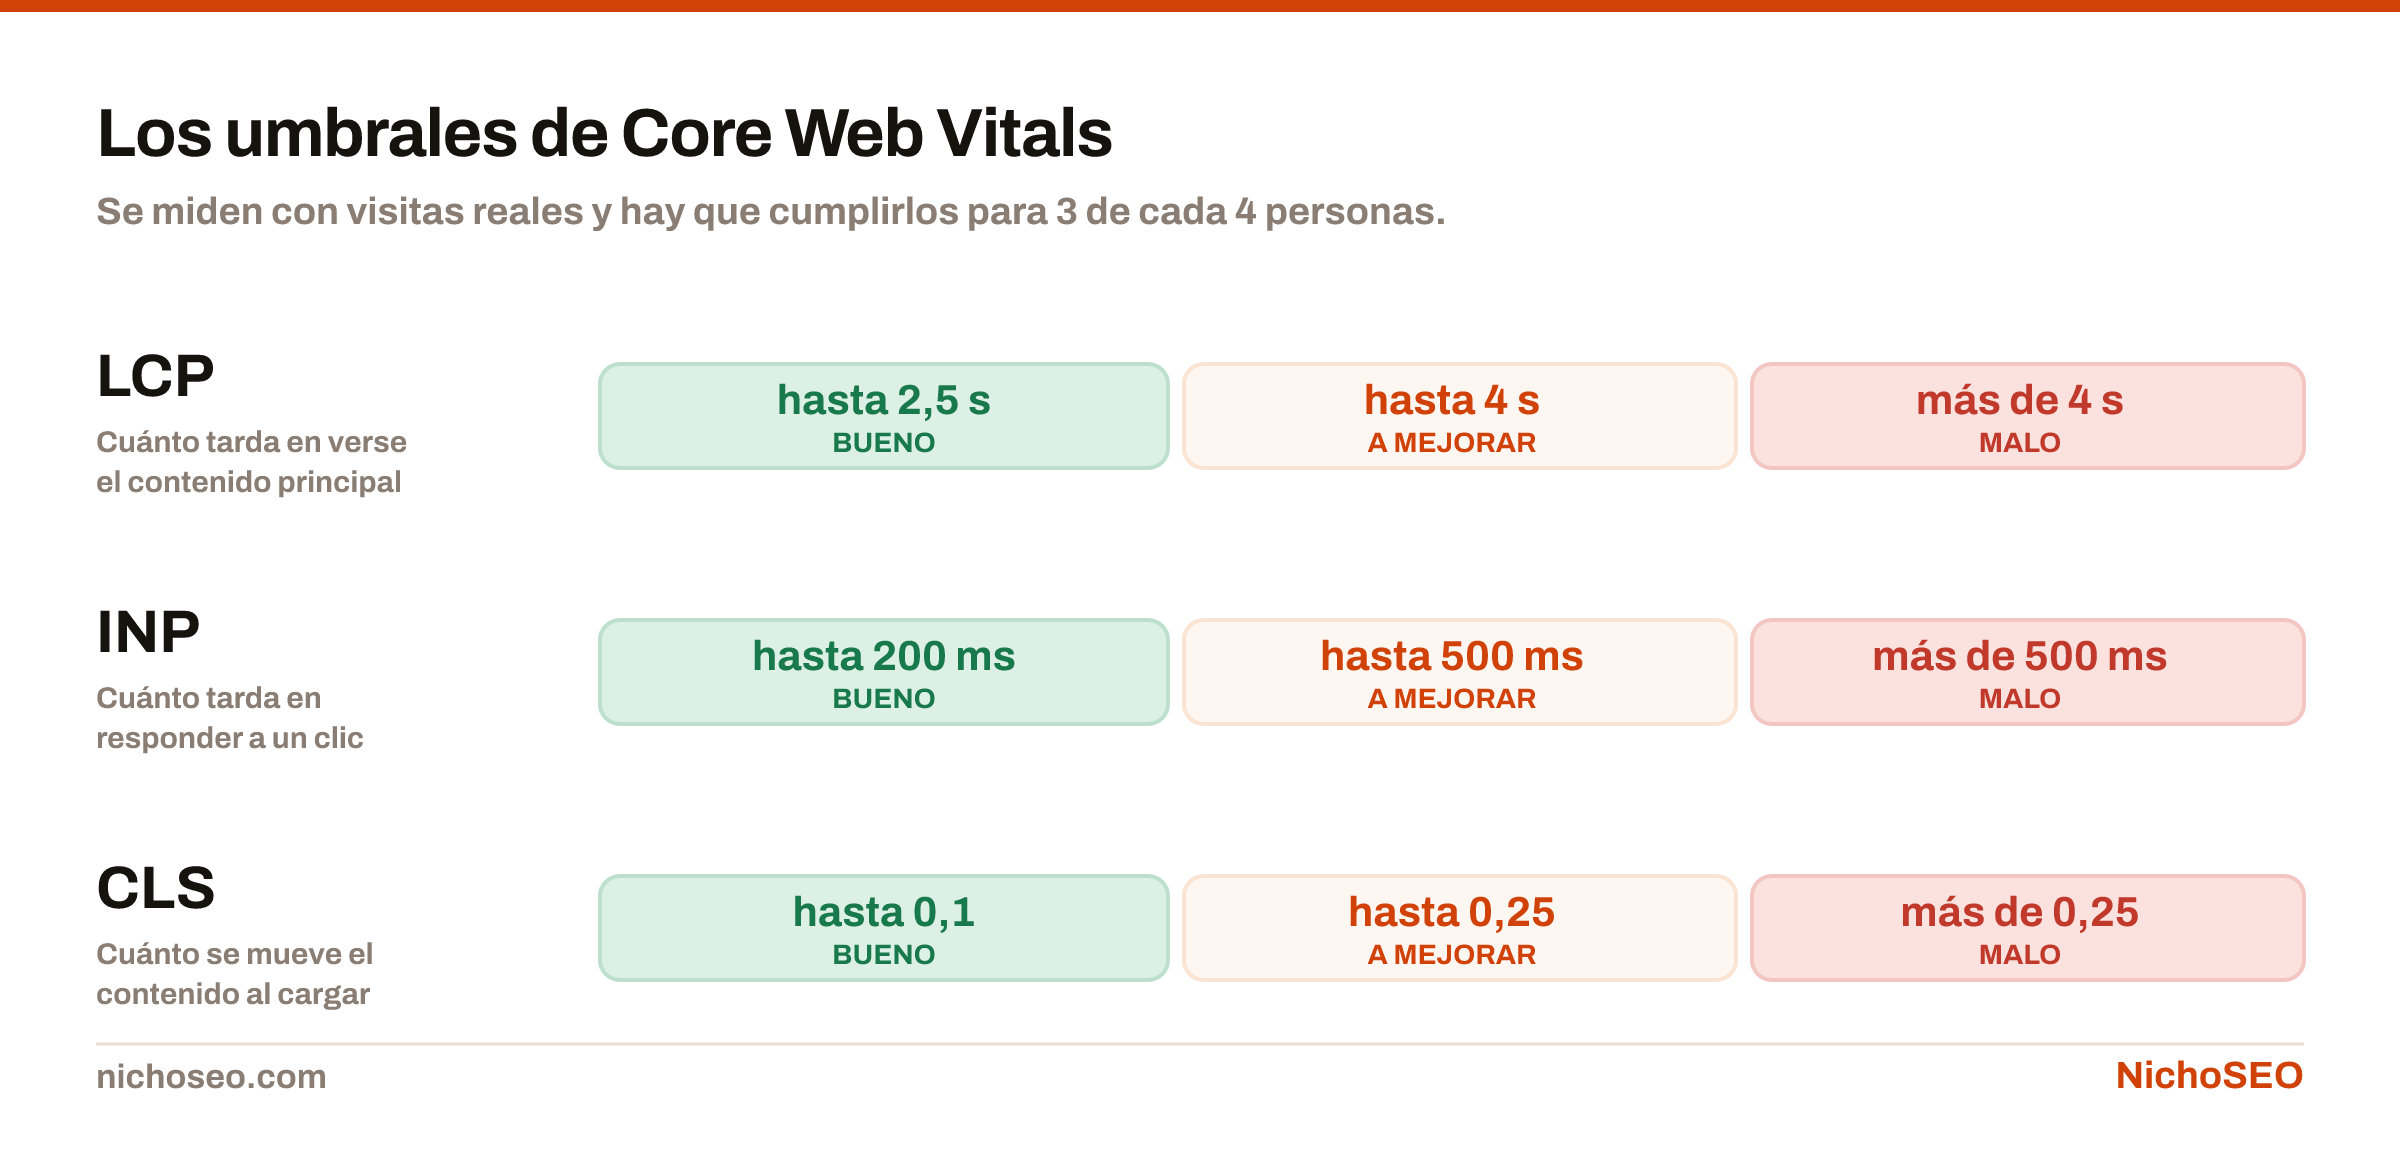
Los tres umbrales de Core Web Vitals: LCP bueno hasta 2,5 segundos, INP bueno hasta 200 milisegundos y CLS bueno hasta 0,1, con sus tramos a mejorar y malo.
Se miden con visitas reales y hay que cumplirlos para 3 de cada 4 personas.Descargar imagen

En casi cualquier sitio, lo más pesado de una página son las imágenes, y es también lo más barato de arreglar: qué decide cuánto pesan.

Dos mitos del SEO técnico: presupuesto de rastreo y Core Web Vitals

Cerramos por el lado contrario, porque hay dos temas que se invocan mucho más de lo que se aplican.

El presupuesto de rastreo. Es la cantidad de páginas que Google está dispuesto a recorrer en tu sitio por día. Es una preocupación real a partir de decenas de miles de direcciones.

En un sitio de doscientas páginas no es un factor. Cuando alguien lo menciona para explicar por qué algo no funciona, casi siempre está tapando una de las cuatro condiciones rotas.

Los Core Web Vitals. Son la cuarta condición, la de grado, y su peso sobre la posición es bajo.

Importan bastante para la conversión y para la experiencia de quien entra. Ese es un argumento mejor y además cierto. Defenderlos como si decidieran el ranking hace que la próxima vez no te crean.
2 de 13

Arquitectura web para SEO: cómo organizar tu sitio

Cómo se agrupan las páginas de un sitio y cómo se enlazan entre sí. Decide a qué llega Google y qué entiende de cada sección.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

No es el menú. El menú es una consecuencia visible de la arquitectura, y se puede tener un menú prolijo sobre una estructura desordenada.

Qué resuelve una buena arquitectura web

Qué se descubre. Un rastreador llega siguiendo enlaces. Lo que no recibe ninguno puede no descubrirse nunca. En un listado largo eso depende de cómo esté paginado, y hay un patrón que corta el camino por completo: paginación SEO.

Qué se considera importante. Lo que recibe más enlaces internos y está más cerca de la home concentra más autoridad. Esa jerarquía la definís vos.

De qué trata el sitio. Diez páginas sobre GEO, enlazadas entre sí y colgando de una principal, dicen «acá se sabe de GEO» mucho más claro que diez páginas sueltas sobre diez temas.

El principio: agrupar por tema, no por formato

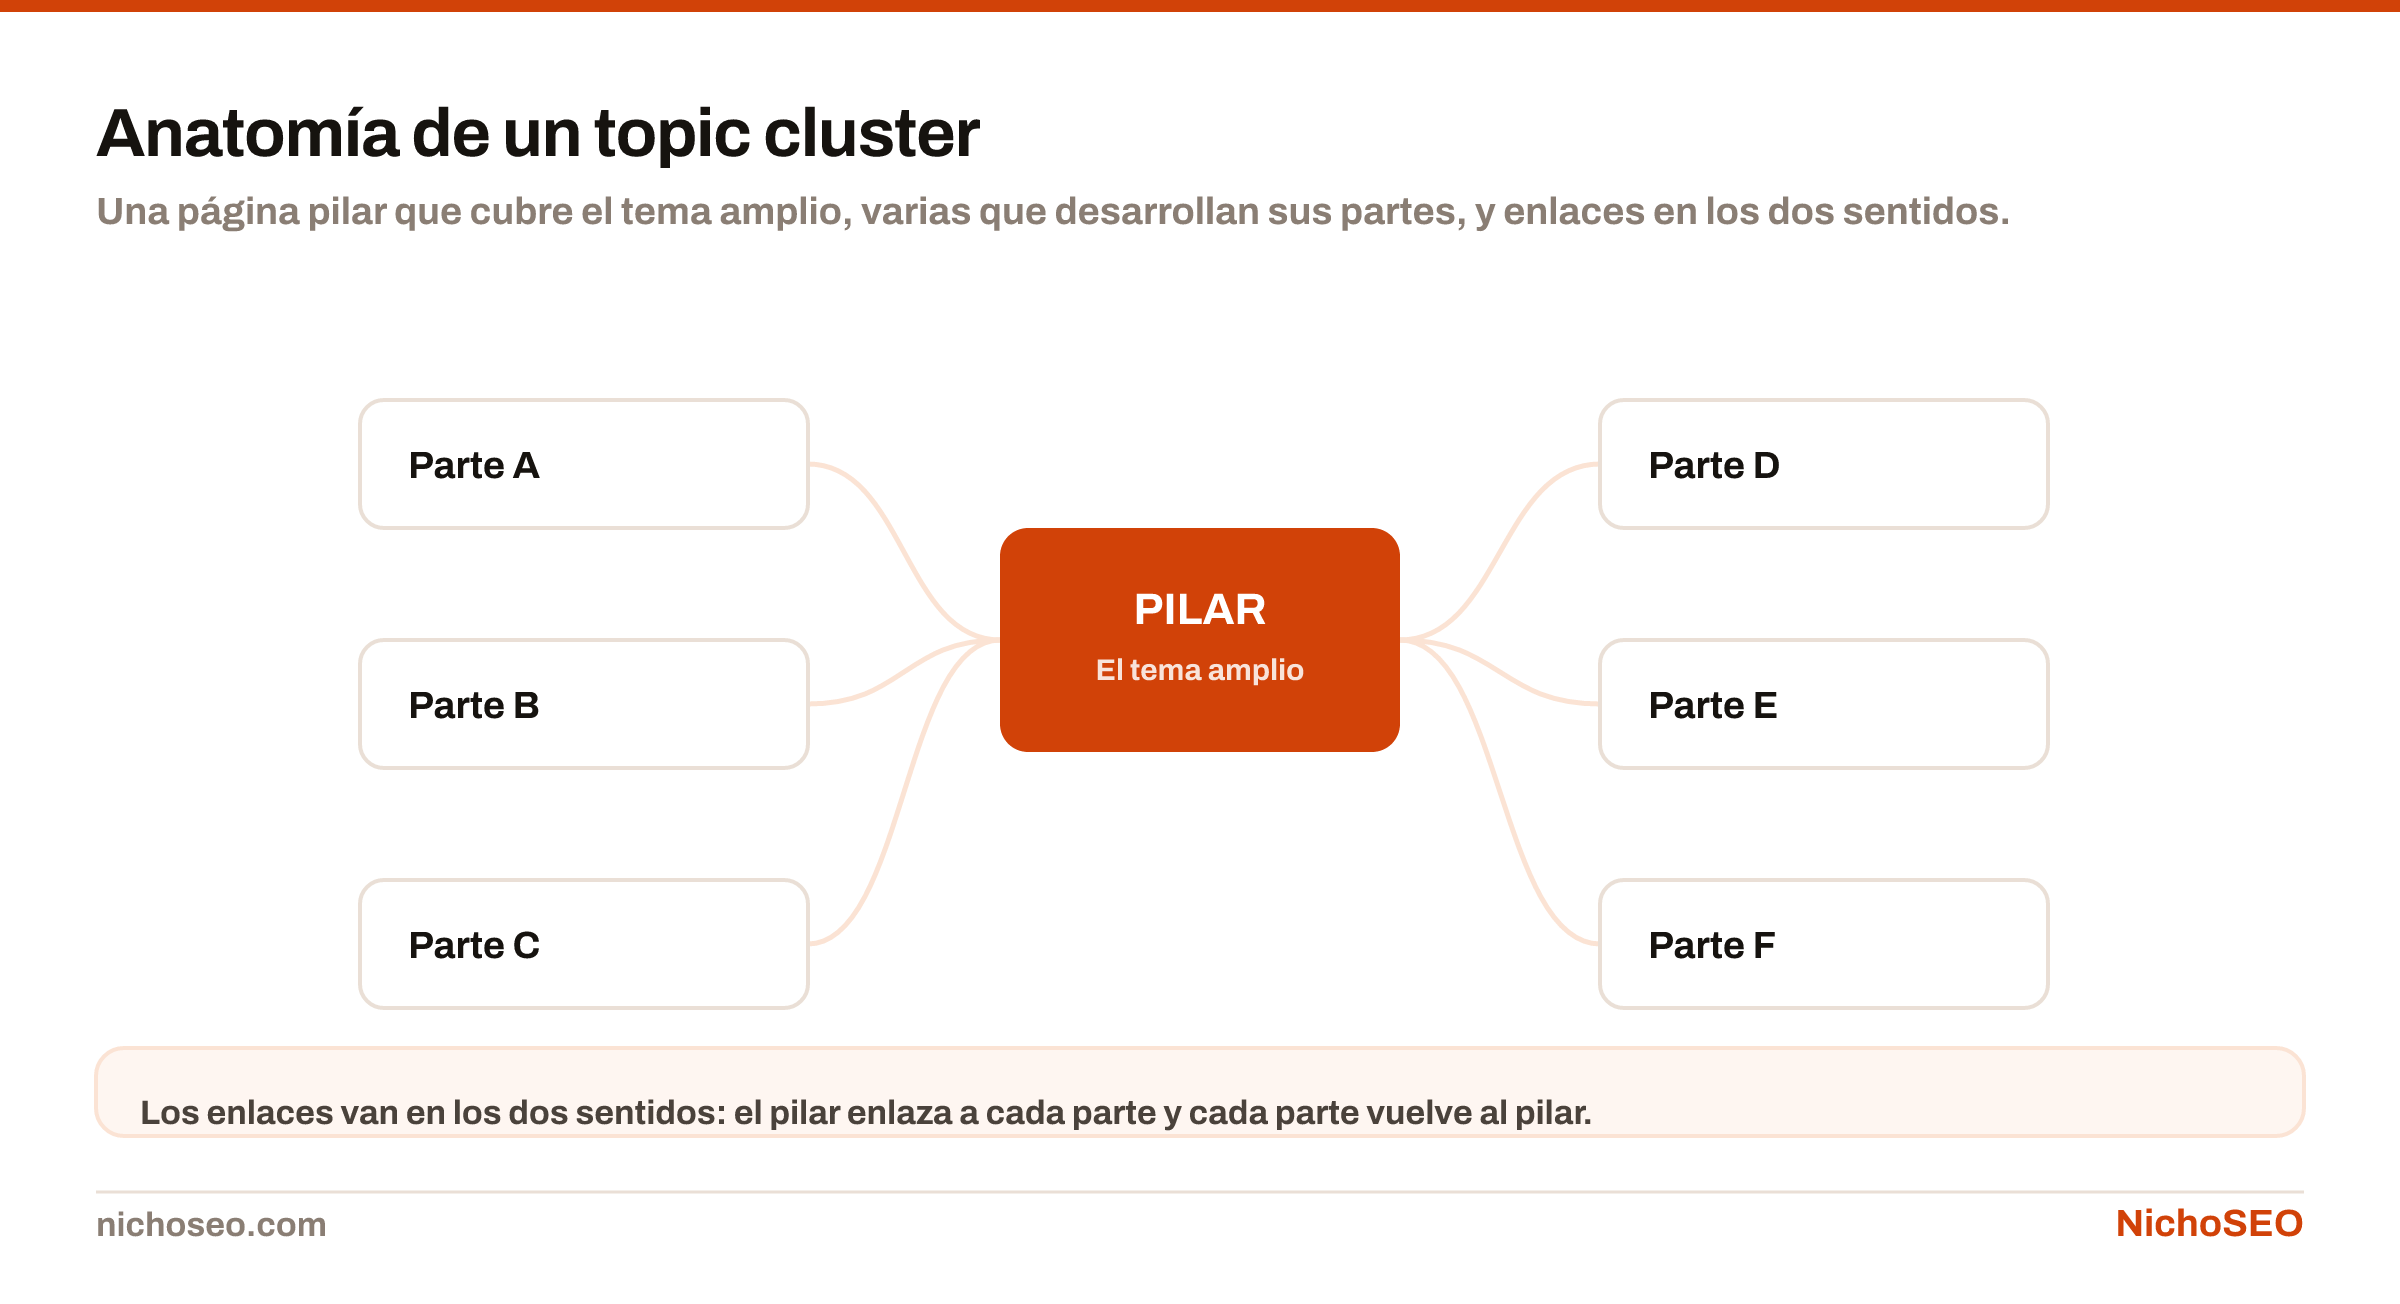
La estructura de un topic cluster: una página pilar en el centro enlazada con varias páginas satélite que desarrollan cada parte del tema.
La forma más simple de agrupar por tema: un pilar por sección y sus partes colgando de él.Descargar imagen
El error de organizar por formato

«Guías», «Artículos», «Recursos» son categorías sobre el tipo de página, no sobre el tema. A un lector no le sirven —nadie busca «una guía», busca cómo resolver algo— y a un buscador tampoco: no le dicen nada sobre de qué sabe el sitio.

Lo que funciona es agrupar por asunto: una sección por tema, con una página que lo cubre en general y varias que lo desarrollan. Eso es un topic cluster. Cada una enlaza a la principal y la principal a todas.

Profundidad de clic: a cuántos saltos está cada página

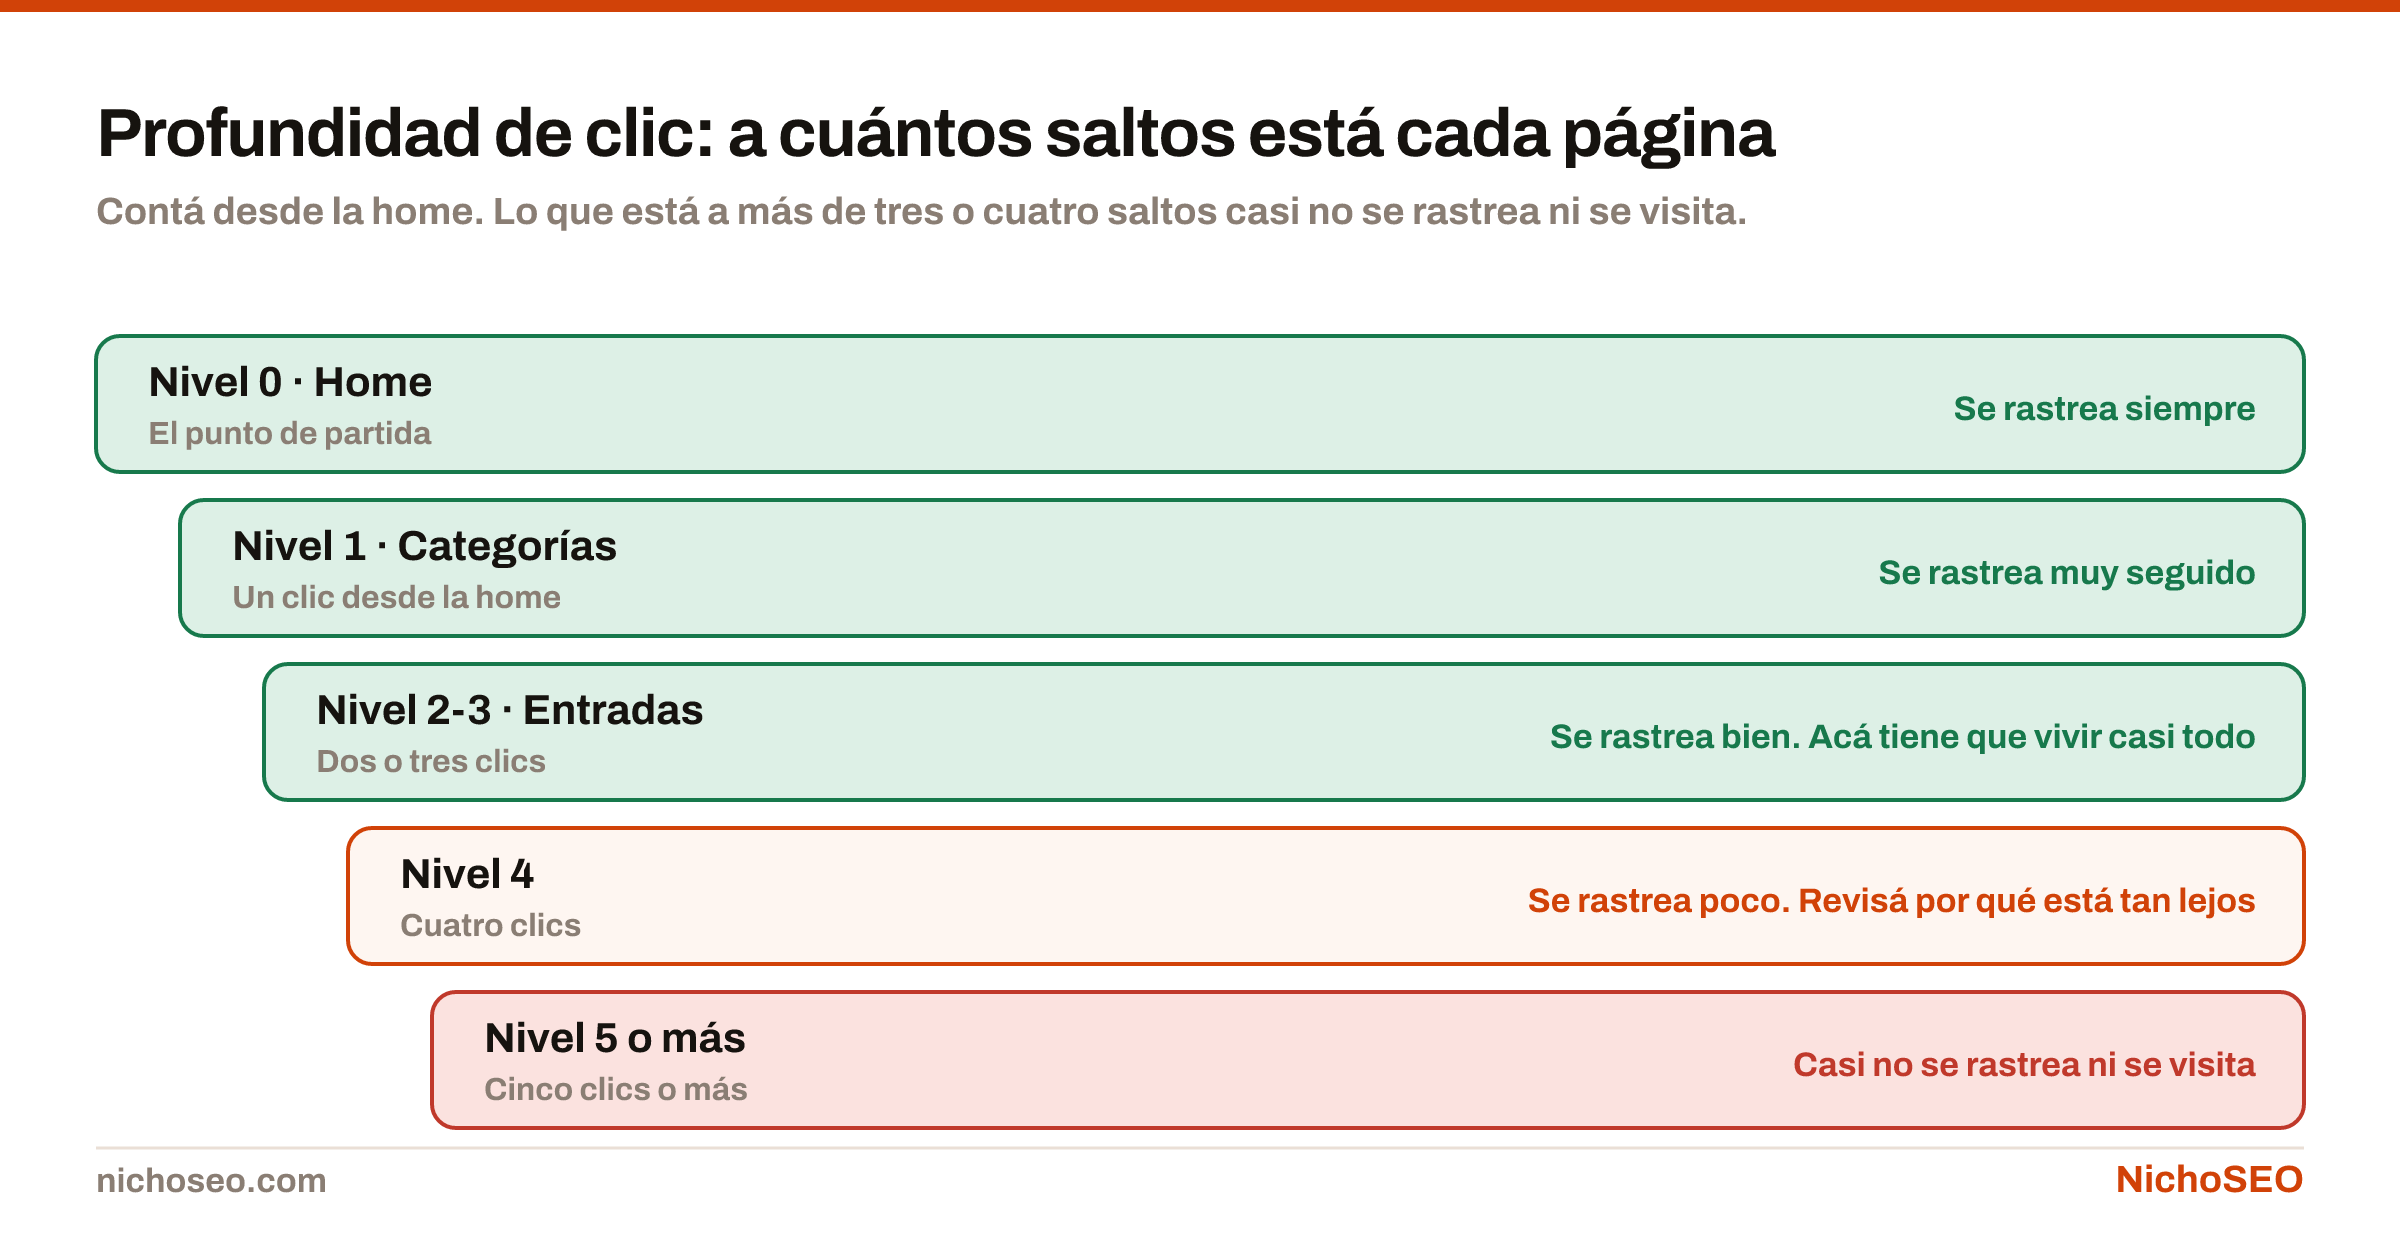
La profundidad de clic de un sitio: las páginas a uno o dos saltos de la home se rastrean bien, las que están a cinco o más casi no se visitan.
Contá desde la home. Lo que está a más de tres o cuatro saltos casi no se rastrea ni se visita.Descargar imagen

Cuántos clics separan una página de la home. Cuanto más profunda:

  • Menos autoridad recibe, porque la que entra al sitio se reparte por los enlaces.
  • Menos se rastrea, porque el buscador llega más tarde y con menos frecuencia.

Medir la profundidad a mano es posible hasta unas cien páginas; más arriba hace falta una herramienta de rastreo, que es justamente el dato que devuelve.

  • Más difícil de encontrar para una persona.

No hay un número mágico, pero si algo importante está a cinco clics, el problema no se arregla agregando un enlace suelto desde la home: se arregla revisando por qué quedó tan lejos.

La referencia es la guía de estructura de URLs de Google.

Cómo escribir las URLs de un sitio

Que la dirección refleje la estructura ayuda a las personas, y a vos cuando mires una analítica dentro de dos años:

/geo/busqueda-de-chatgpt/

Pero no vale la pena migrar URLs solo para que se vean mejor. Cada migración pierde algo. Se decide bien al principio y después se deja quieto.

Lo que sí conviene: en minúsculas, con guiones, sin parámetros innecesarios, cortas, y estables. Una URL que cambia es una URL que hay que redirigir para siempre.

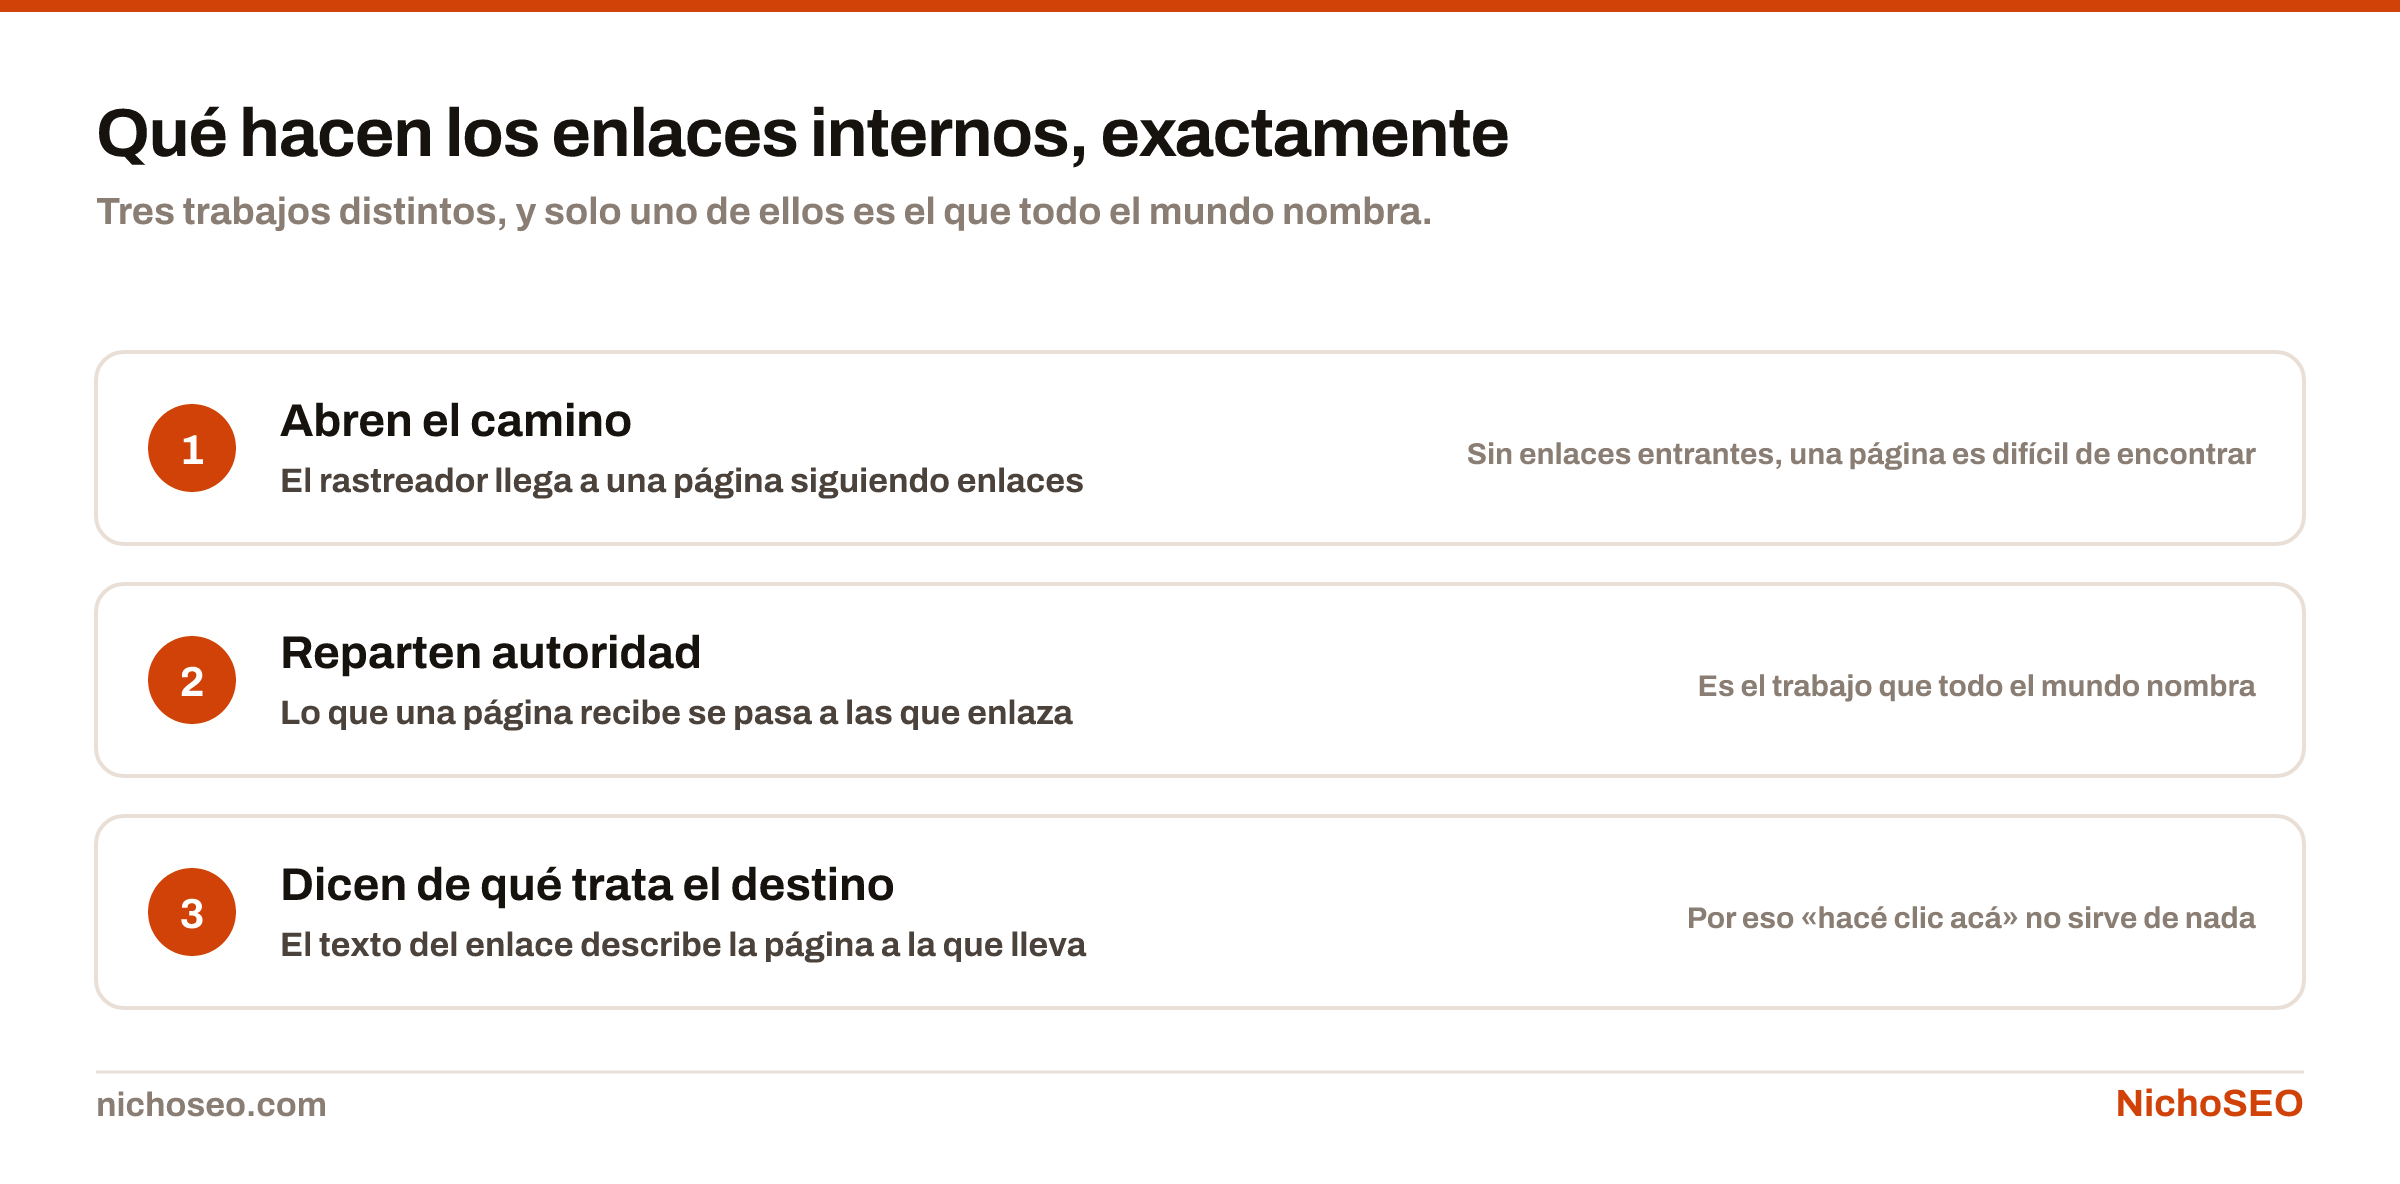
Los tres trabajos de un enlace interno: abrir un camino para que el rastreador llegue, repartir autoridad entre páginas y decir de qué trata el destino mediante el texto del enlace.
La arquitectura se implementa con enlaces internos: son el camino que el rastreador recorre.Descargar imagen

Cuándo conviene rehacer la arquitectura

Antes de escribir. Una arquitectura decidida con veinte páginas se implementa en una tarde; con doscientas publicadas es una migración, con su mapa de redirecciones y su pérdida inevitable.

Si ya estás en el segundo caso: no reorganices todo de golpe. Identificá los dos o tres temas donde tenés más contenido, armá la página principal de cada uno, enlazá desde y hacia ella, y dejá el resto como está hasta que haya un motivo concreto.

Hay un caso donde la decisión no se puede postergar: cuando el sitio va a existir en varios idiomas o países. Ahí la estructura de carpetas y las etiquetas que las relacionan se deciden juntas, y rehacerlo después es una migración: el mínimo para no romper nada está en hreflang y SEO internacional.

3 de 13

Cómo indexar una página en Google y qué hacer si no indexa

No hay forma de obligar a Google a indexar. Lo que hay es un procedimiento para que pueda y un diagnóstico de cinco pasos para cuando puede y no quiere.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Cómo hacer que Google indexe tu página: el procedimiento

Cuatro cosas, en orden:

  1. Que la página se pueda rastrear. Responde 200, no está bloqueada en el robots.txt, no exige autenticación.
  2. Que esté enlazada desde alguna página que ya se indexa. Es como se descubre, y una página huérfana puede no descubrirse nunca.
  3. Que esté en el sitemap, con un lastmod real.
  4. Pedir la revisión con la inspección de URL de Search Console. Eso adelanta la visita; no garantiza el resultado.

Con eso alcanza para la mayoría de los casos. El resto de este texto es para cuando no alcanza.

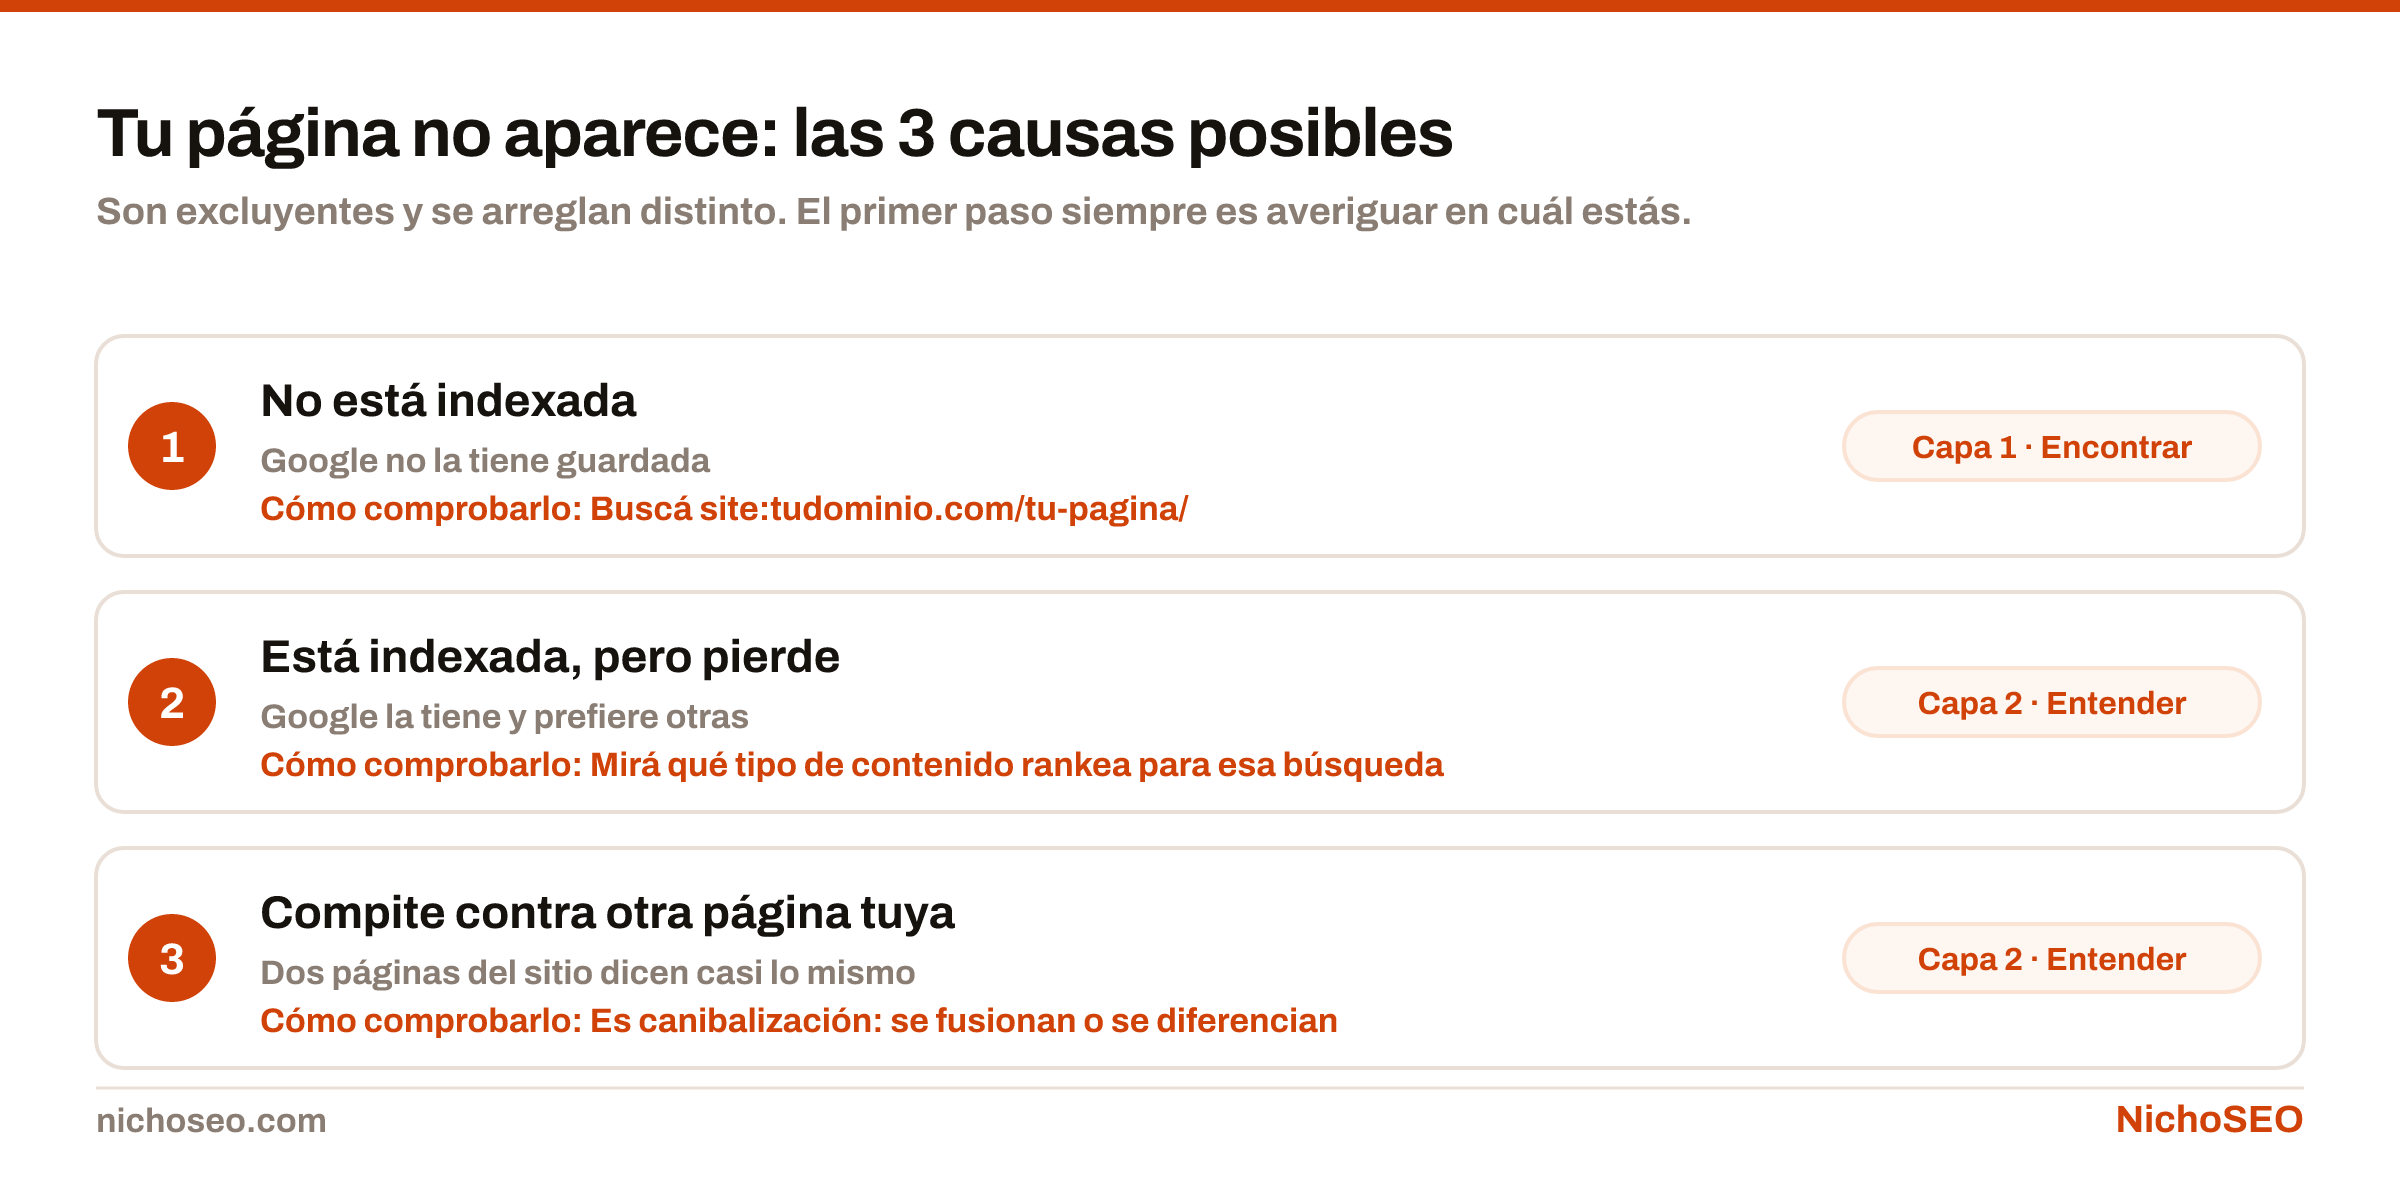
Las tres causas por las que una página no aparece en Google: no está indexada, está indexada pero Google prefiere otras, o compite contra otra página del mismo sitio.
Son excluyentes y se arreglan distinto. El primer paso siempre es averiguar en cuál estás.Descargar imagen

«No puede» y «no quiere»: dos problemas distintos

Descubierta, sin indexar

  • Google conoce la URL pero no la pidió todavía.
  • Suele ser cuestión de prioridad: hay muchas URLs y esta no parece urgente.
  • Se ataca con enlaces internos desde páginas fuertes y con menos URLs compitiendo.

Rastreada, sin indexar

  • La pidió, la leyó y decidió no guardarla.
  • Casi siempre es una señal sobre el contenido, no sobre la técnica.
  • No se arregla insistiendo con la inspección de URL.

Confundirlos hace perder semanas. Para el primero se trabaja descubrimiento; para el segundo, el contenido.

El diagnóstico en 5 pasos, siempre en este orden

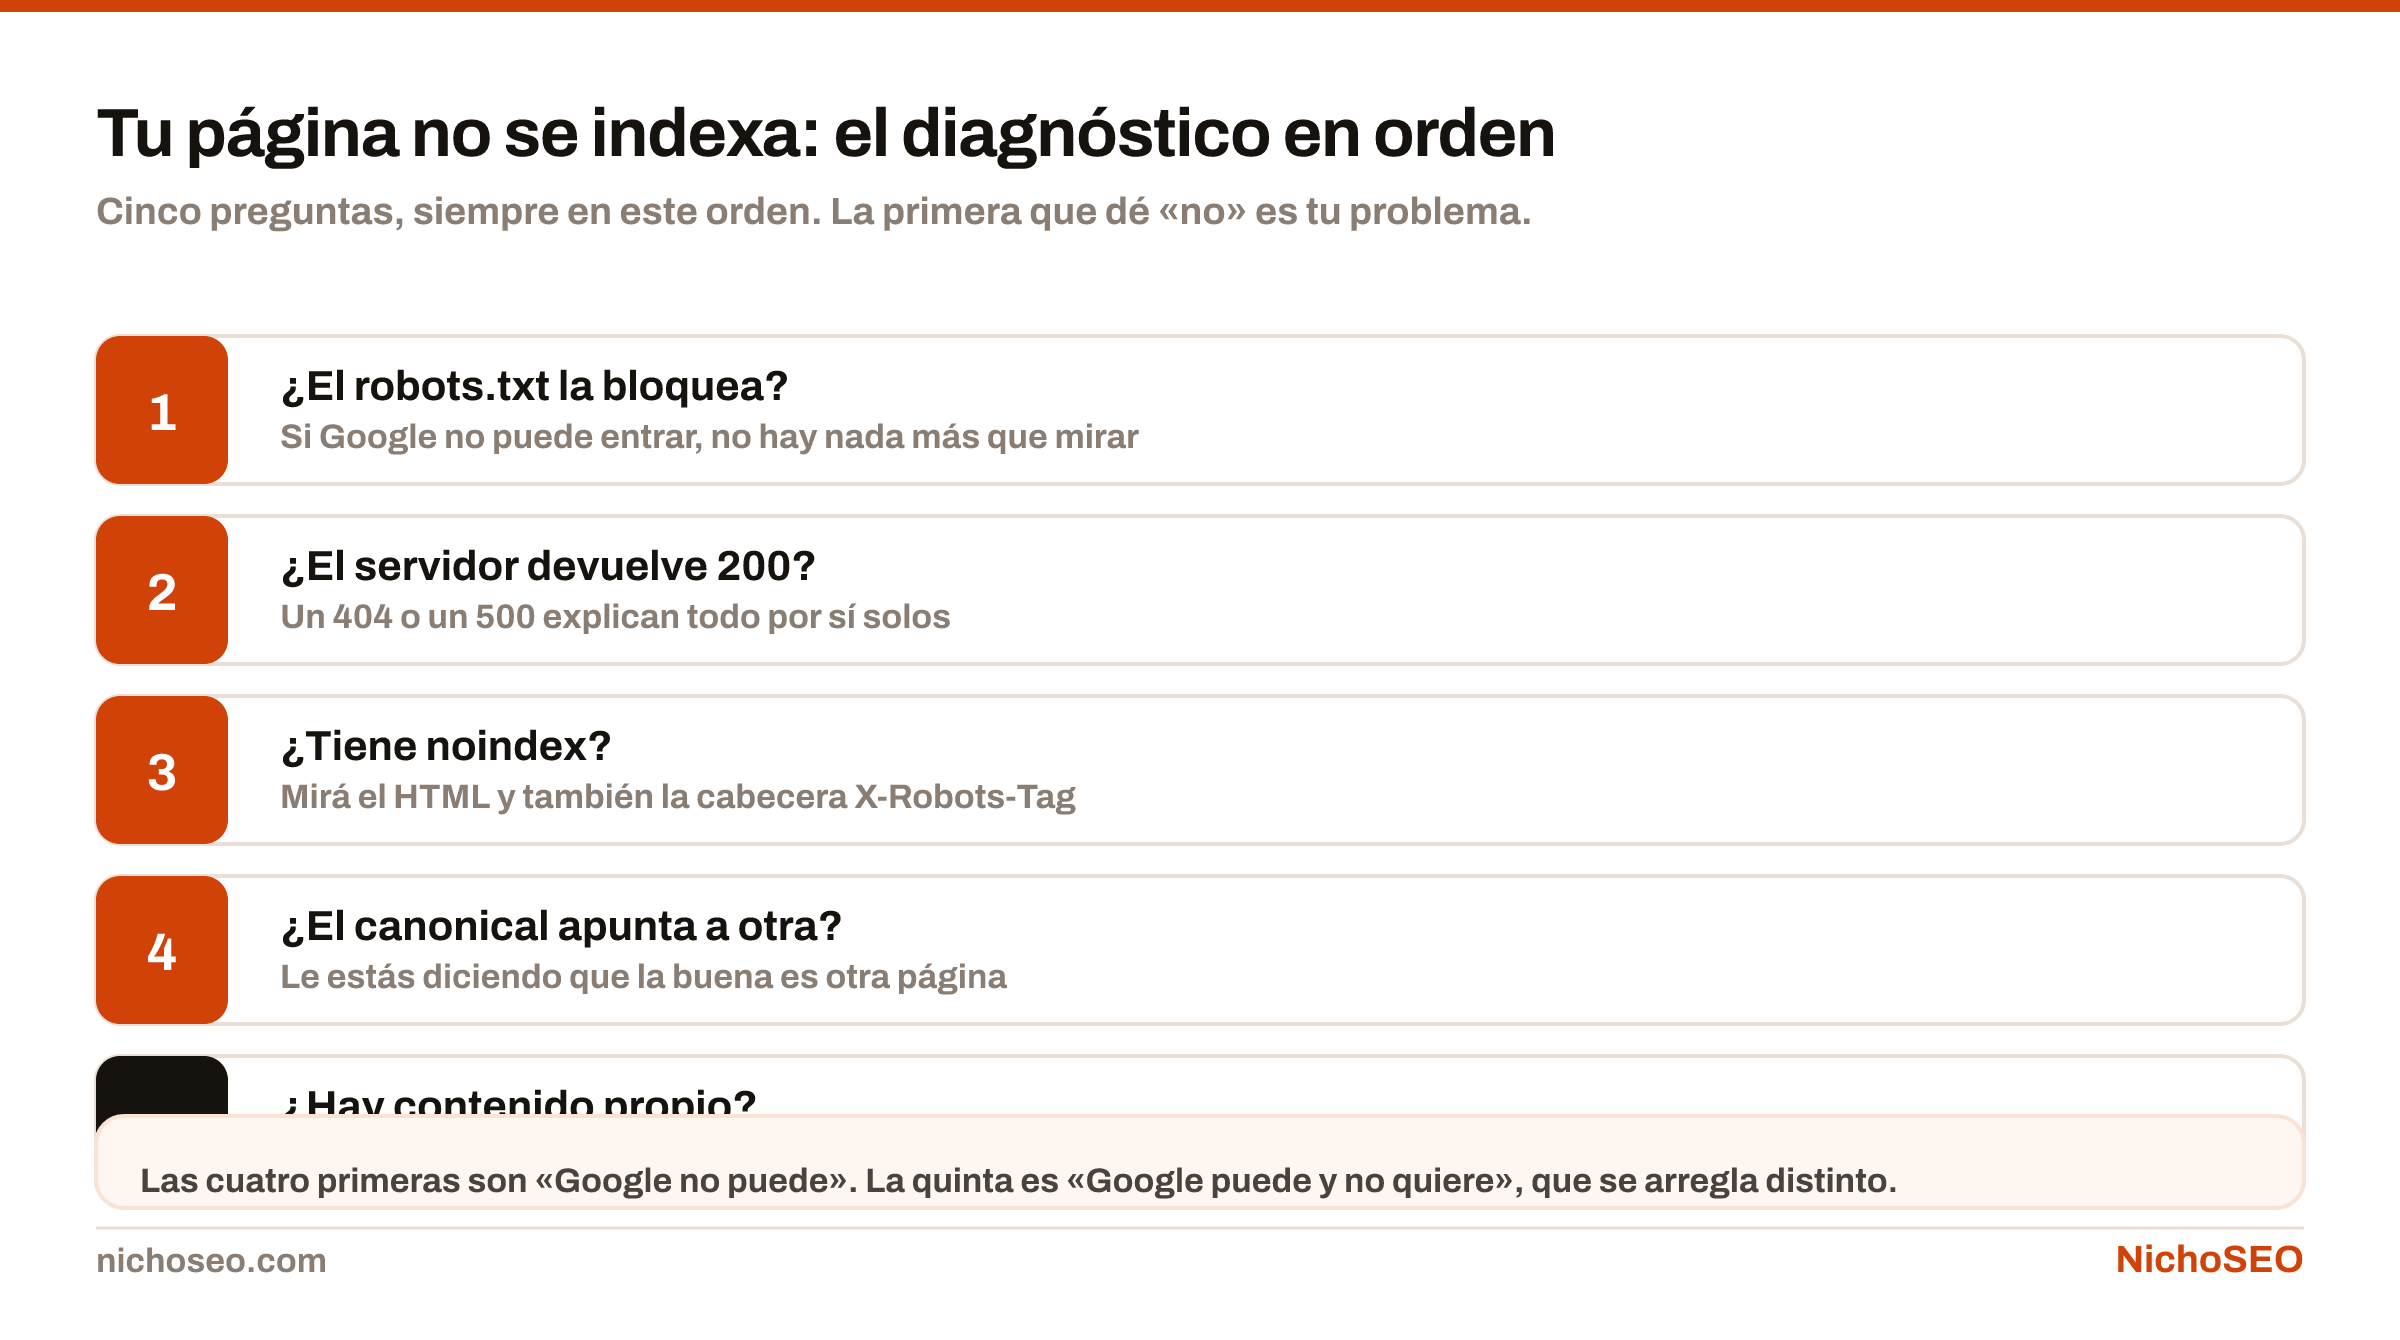
El diagnóstico para una página que no se indexa: comprobar si está bloqueada, si devuelve 200, si tiene noindex, si el canonical apunta a otro lado y si hay contenido propio.
Cinco preguntas, siempre en este orden. La primera que dé «no» es tu problema.Descargar imagen

1. ¿Responde 200? curl -I sobre la URL. Un 301, un 404 o un 403 explican todo por sí solos.

2. ¿Hay un noindex? Buscalo en el HTML y en las cabeceras. Un X-Robots-Tag: noindex no aparece en el código fuente, y es de los que más tiempo hacen perder.

3. ¿El canonical apunta a otra página? Si sí, le estás diciendo a Google que no la indexe. Pasa con plantillas que ponen el mismo canonical en todo el sitio.

4. ¿El contenido existe sin JavaScript? Mirá el código fuente original. Si el artículo no está ahí, depende de un renderizado que agrega demora e incertidumbre.

5. ¿Hay otra página tuya casi igual? Google elige una y descarta las demás. Eso es canibalización, y se resuelve fusionando.

Cuando todo lo anterior está bien

Si la página se rastrea, responde 200, no tiene noindex, el canonical apunta a sí misma y el contenido está en el HTML, y aun así no indexa: el problema es que la página no aporta nada que no esté ya indexado. Es la respuesta que nadie quiere escuchar y la correcta la mayoría de las veces.

Los dos documentos que hacen falta para el diagnóstico son etiquetas meta para robots y los rastreadores de Google.

Qué no hacer cuando una página no indexa

Pedir la indexación todos los días. No acelera nada y no cambia la decisión.

Comprar servicios de indexación. Los que funcionan usan las mismas APIs públicas; los que prometen forzarla, mienten.

Publicar más para compensar. Si el problema es que el contenido no aporta, más contenido igual empeora el diagnóstico del sitio entero.

La profundidad de clic de un sitio: las páginas a uno o dos saltos de la home se rastrean bien, las que están a cinco o más casi no se visitan.
Una página enterrada a cinco clics de la home se descubre tarde. Acercarla es lo que más acelera.Descargar imagen

Qué sí acelera la indexación

Enlaces internos desde páginas que ya se indexan y reciben tráfico. Un enlace desde tu página más fuerte hace más por una URL nueva que cualquier herramienta.

4 de 13

Redirecciones 301: migrar sin perder posiciones

Una 301 traslada a la nueva URL las señales que la vieja había acumulado. Cuándo usarla, en qué se diferencia de una 302 y el procedimiento para una migración.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Es la herramienta central de cualquier migración, y donde más patrimonio se pierde por apuro.

301 o 302: cuál usar en cada caso

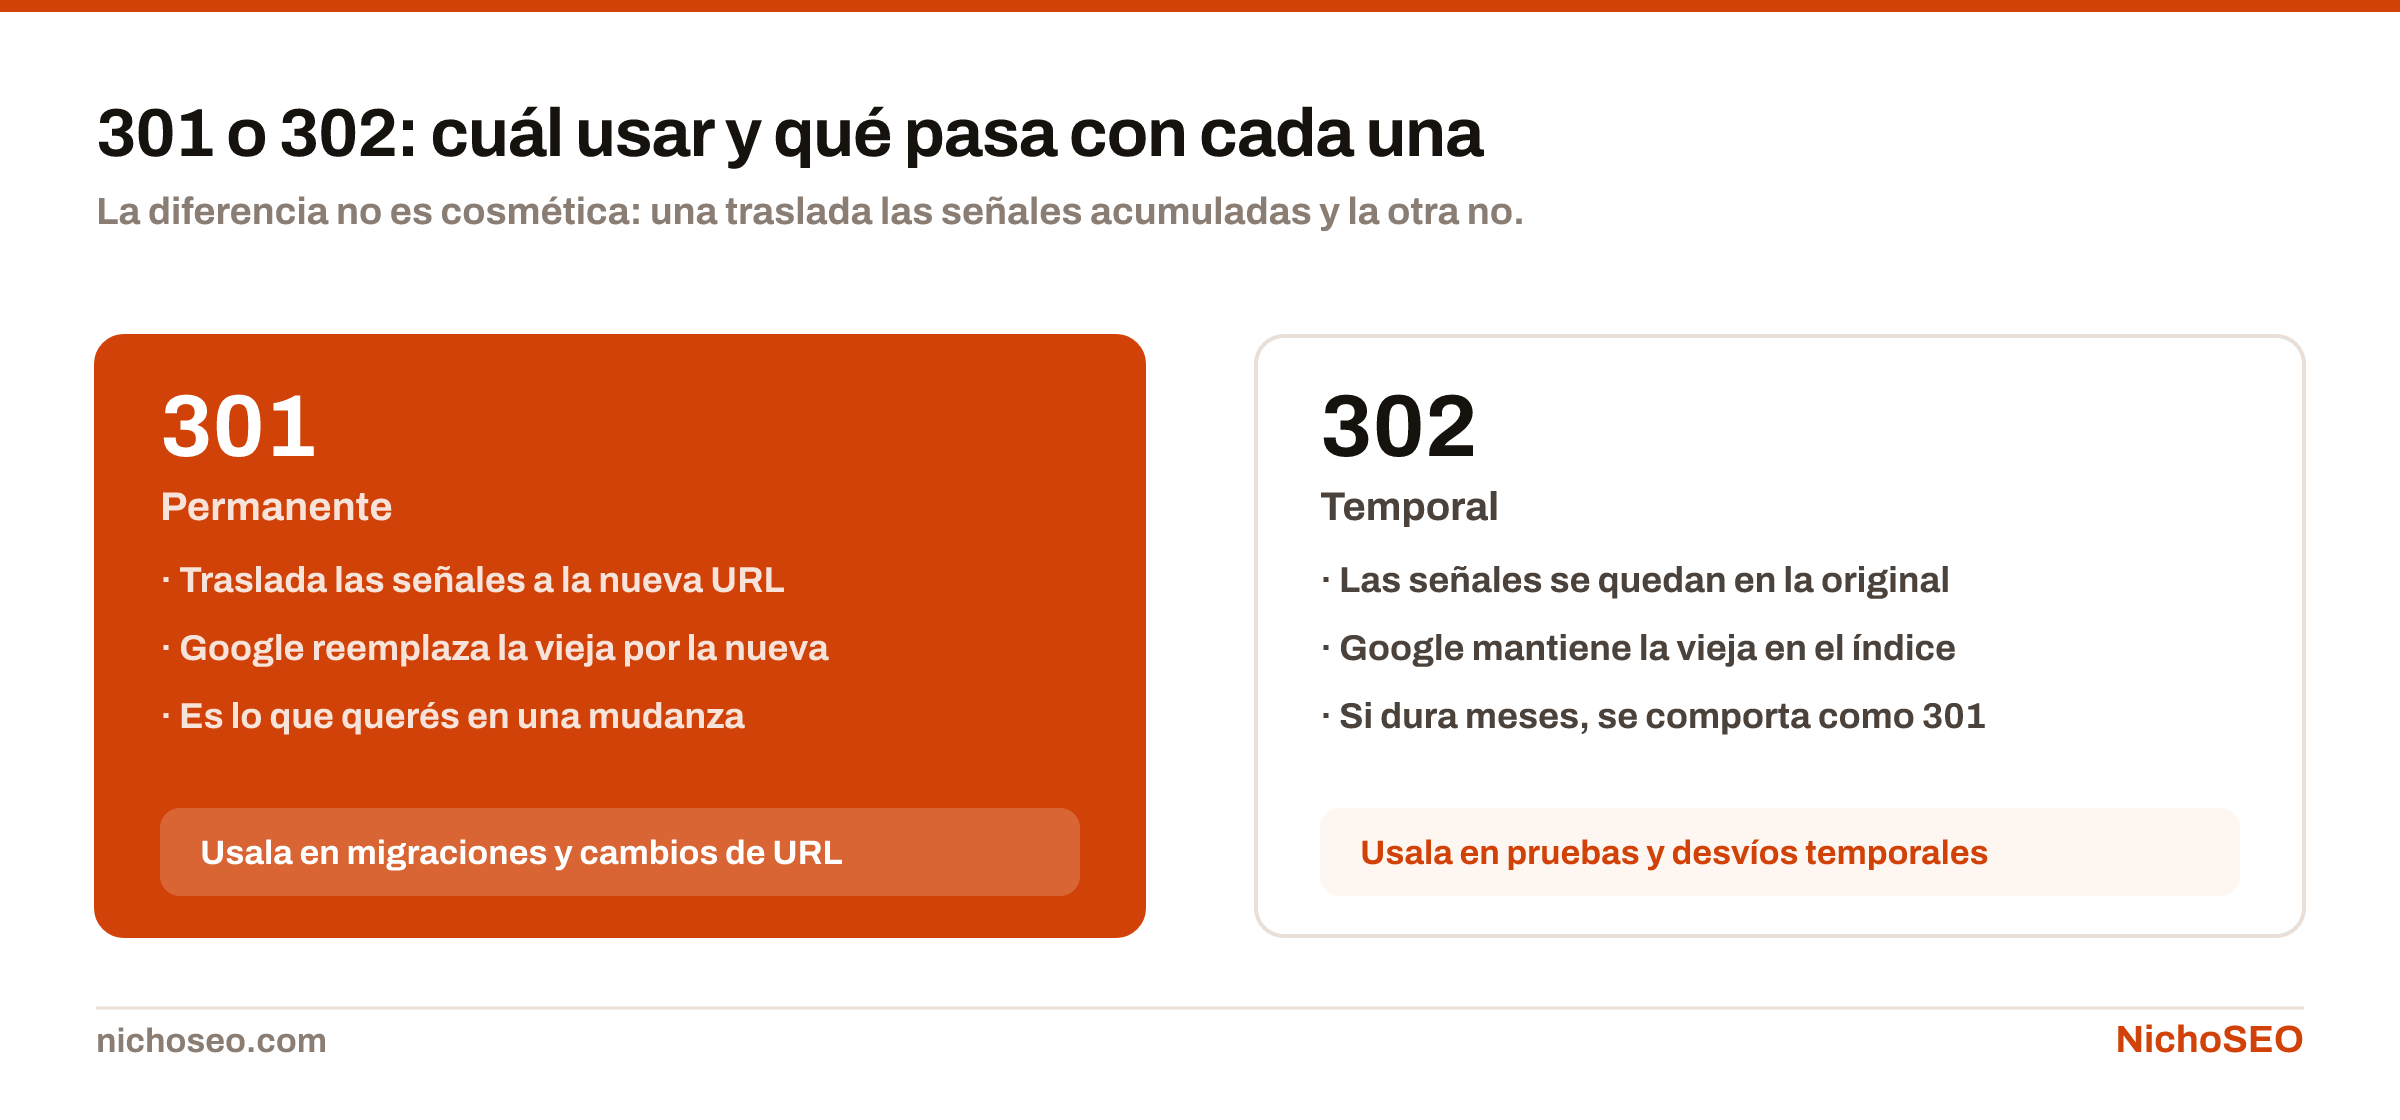
Diferencia entre una redirección 301 permanente, que traslada las señales acumuladas a la nueva URL, y una 302 temporal, que las deja en la original.
La diferencia no es cosmética: una traslada las señales acumuladas y la otra no.Descargar imagen

301, permanente. Lo viejo no vuelve. Traslada autoridad. Es lo que corresponde en una migración, en un cambio de dominio o cuando se fusionan dos páginas que se canibalizan.

302, temporal. Lo viejo vuelve. No traslada señales, justamente porque declara que el cambio es pasajero.

El error clásico es poner 302 en una mudanza definitiva, muchas veces porque es el valor por defecto de la herramienta que se usó. El síntoma es que la URL nueva no termina de posicionar y la vieja sigue apareciendo por meses.

Las 3 decisiones que definen el resultado de una migración

1. Cada URL a su equivalente. Uno a uno, cada página vieja a la nueva que atiende la misma intención. Es trabajo aburrido y es todo el trabajo.

El atajo que arruina migraciones

Redirigir todo el sitio viejo a la home es rápido y destruye el patrimonio. Para el buscador, decenas de redirecciones distintas a un mismo destino que no se parece al original se comportan como páginas que desaparecieron. Es equivalente a no redirigir.

2. Sin cadenas. Si A redirige a B y B a C, hay que reescribir A para que apunte directo a C. Cada salto agrega latencia, y las cadenas largas pueden dejar de seguirse. En migraciones sucesivas se acumulan sin que nadie las mire.

3. Sin bucles. A redirige a B y B a A. La página no carga nunca. Se detecta fácil si se prueba, y por eso hay que probar.

Los seis errores de SEO técnico más frecuentes, agrupados según qué condición rompen: rastreo, renderizado o indexación.
Las redirecciones encadenadas son el cuarto error más frecuente de SEO técnico, y se acumulan justo en las migraciones.Descargar imagen

El procedimiento para migrar sin perder posiciones

  1. Inventariá todo lo que existe hoy. No solo lo que está en el sitemap: también lo que recibe tráfico, lo que tiene enlaces externos y lo que aparece en los registros del servidor.
  2. Armá el mapa uno a uno, en una planilla, antes de tocar nada. Columna URL vieja, columna URL nueva, columna motivo.
  3. Marcá lo que no tiene equivalente y decidí a mano: la categoría más cercana, o un 410 si de verdad desapareció y no va a volver.
  4. Implementá y probá cada regla antes de publicar, en un entorno de pruebas.
  5. Actualizá los enlaces internos para que apunten al destino final. Un enlace interno que pasa por una redirección funciona, pero es deuda que se acumula.
  6. Después de publicar, mirá los errores 404 durante semanas. Ahí aparece lo que el inventario no vio.
El diagnóstico para una página que no se indexa: comprobar si está bloqueada, si devuelve 200, si tiene noindex, si el canonical apunta a otro lado y si hay contenido propio.
Después de una migración, el diagnóstico es el mismo: comprobá en este orden qué pasó con cada URL nueva.Descargar imagen

La referencia oficial está en redirecciones y la búsqueda de Google y en consolidar URLs duplicadas.

Los errores de redirección que cuestan posiciones

Sacar las redirecciones a los tres meses. Mientras alguien siga llegando por una URL vieja —un enlace en un sitio ajeno, un marcador, un PDF— esa redirección sigue haciendo falta. No cuesta nada dejarla.

Redirigir con JavaScript. Funciona para una persona, pero no es lo mismo para un rastreador. Las redirecciones van del lado del servidor.

Cambiar la estructura de URLs sin motivo. Cada migración pierde algo, por bien que se haga. Si el único argumento es que las URLs nuevas se ven mejor, no alcanza.

5 de 13

Sitemap XML: qué incluir, qué dejar afuera y cómo enviarlo

Un archivo que lista las URLs que querés que Google conozca, con la fecha en que cada una cambió. Qué va y qué no, cómo generarlo y qué esperar de él.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Lo que hace es ayudar al descubrimiento. Lo que no hace es obligar a nadie a indexar nada.

Qué incluir en el sitemap y qué dejar afuera

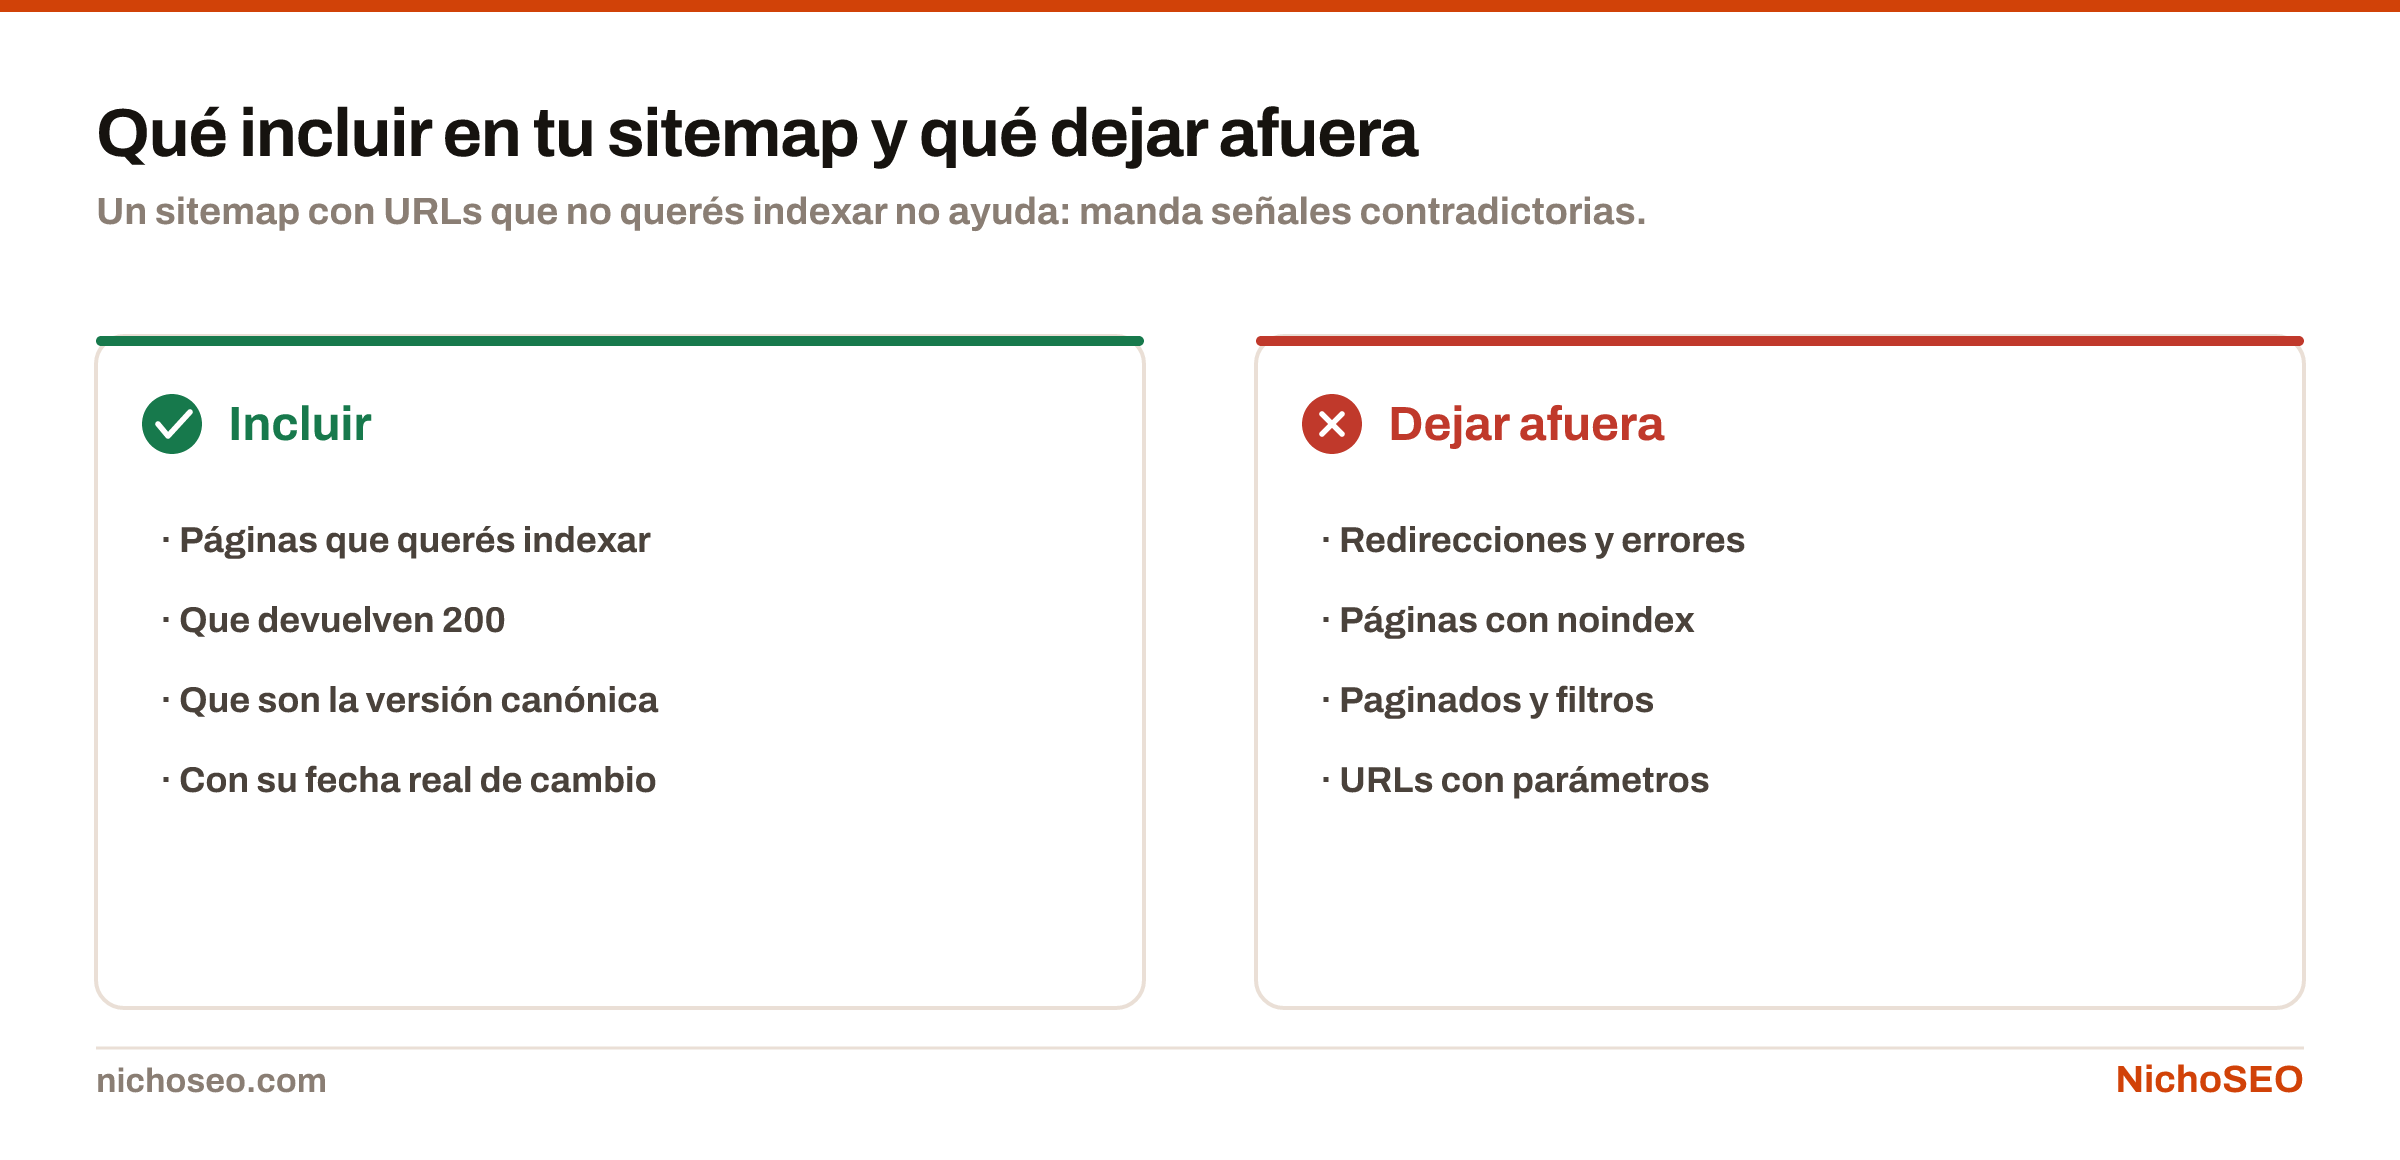
Qué incluir en un sitemap XML —páginas indexables, canónicas y que devuelven 200— y qué dejar afuera: redirecciones, noindex, paginados y URLs con parámetros.
Un sitemap con URLs que no querés indexar no ayuda: manda señales contradictorias.Descargar imagen

Solo URLs que cumplan las cuatro condiciones a la vez:

  1. Devuelven 200. Ni redirecciones ni errores.
  2. Son indexables. Sin noindex.
  3. Son canónicas. La versión que querés que se muestre, no una variante.
  4. Valen por sí mismas. Contenido que tiene sentido como destino de una búsqueda.
La contradicción más común

Un sitemap que incluye páginas con noindex le dice al buscador dos cosas opuestas: «mirá esto» y «no lo indexes». No es grave, pero gasta presupuesto de rastreo y ensucia los informes con avisos que después nadie sabe interpretar.

Qué dejar afuera

  • Páginas con noindex.
  • URLs que redirigen.
  • Versiones con parámetros que duplican una canónica.
  • Páginas de resultados de búsqueda interna.
  • Páginas de utilidad sin valor de búsqueda: gracias, carrito, paginación intermedia.
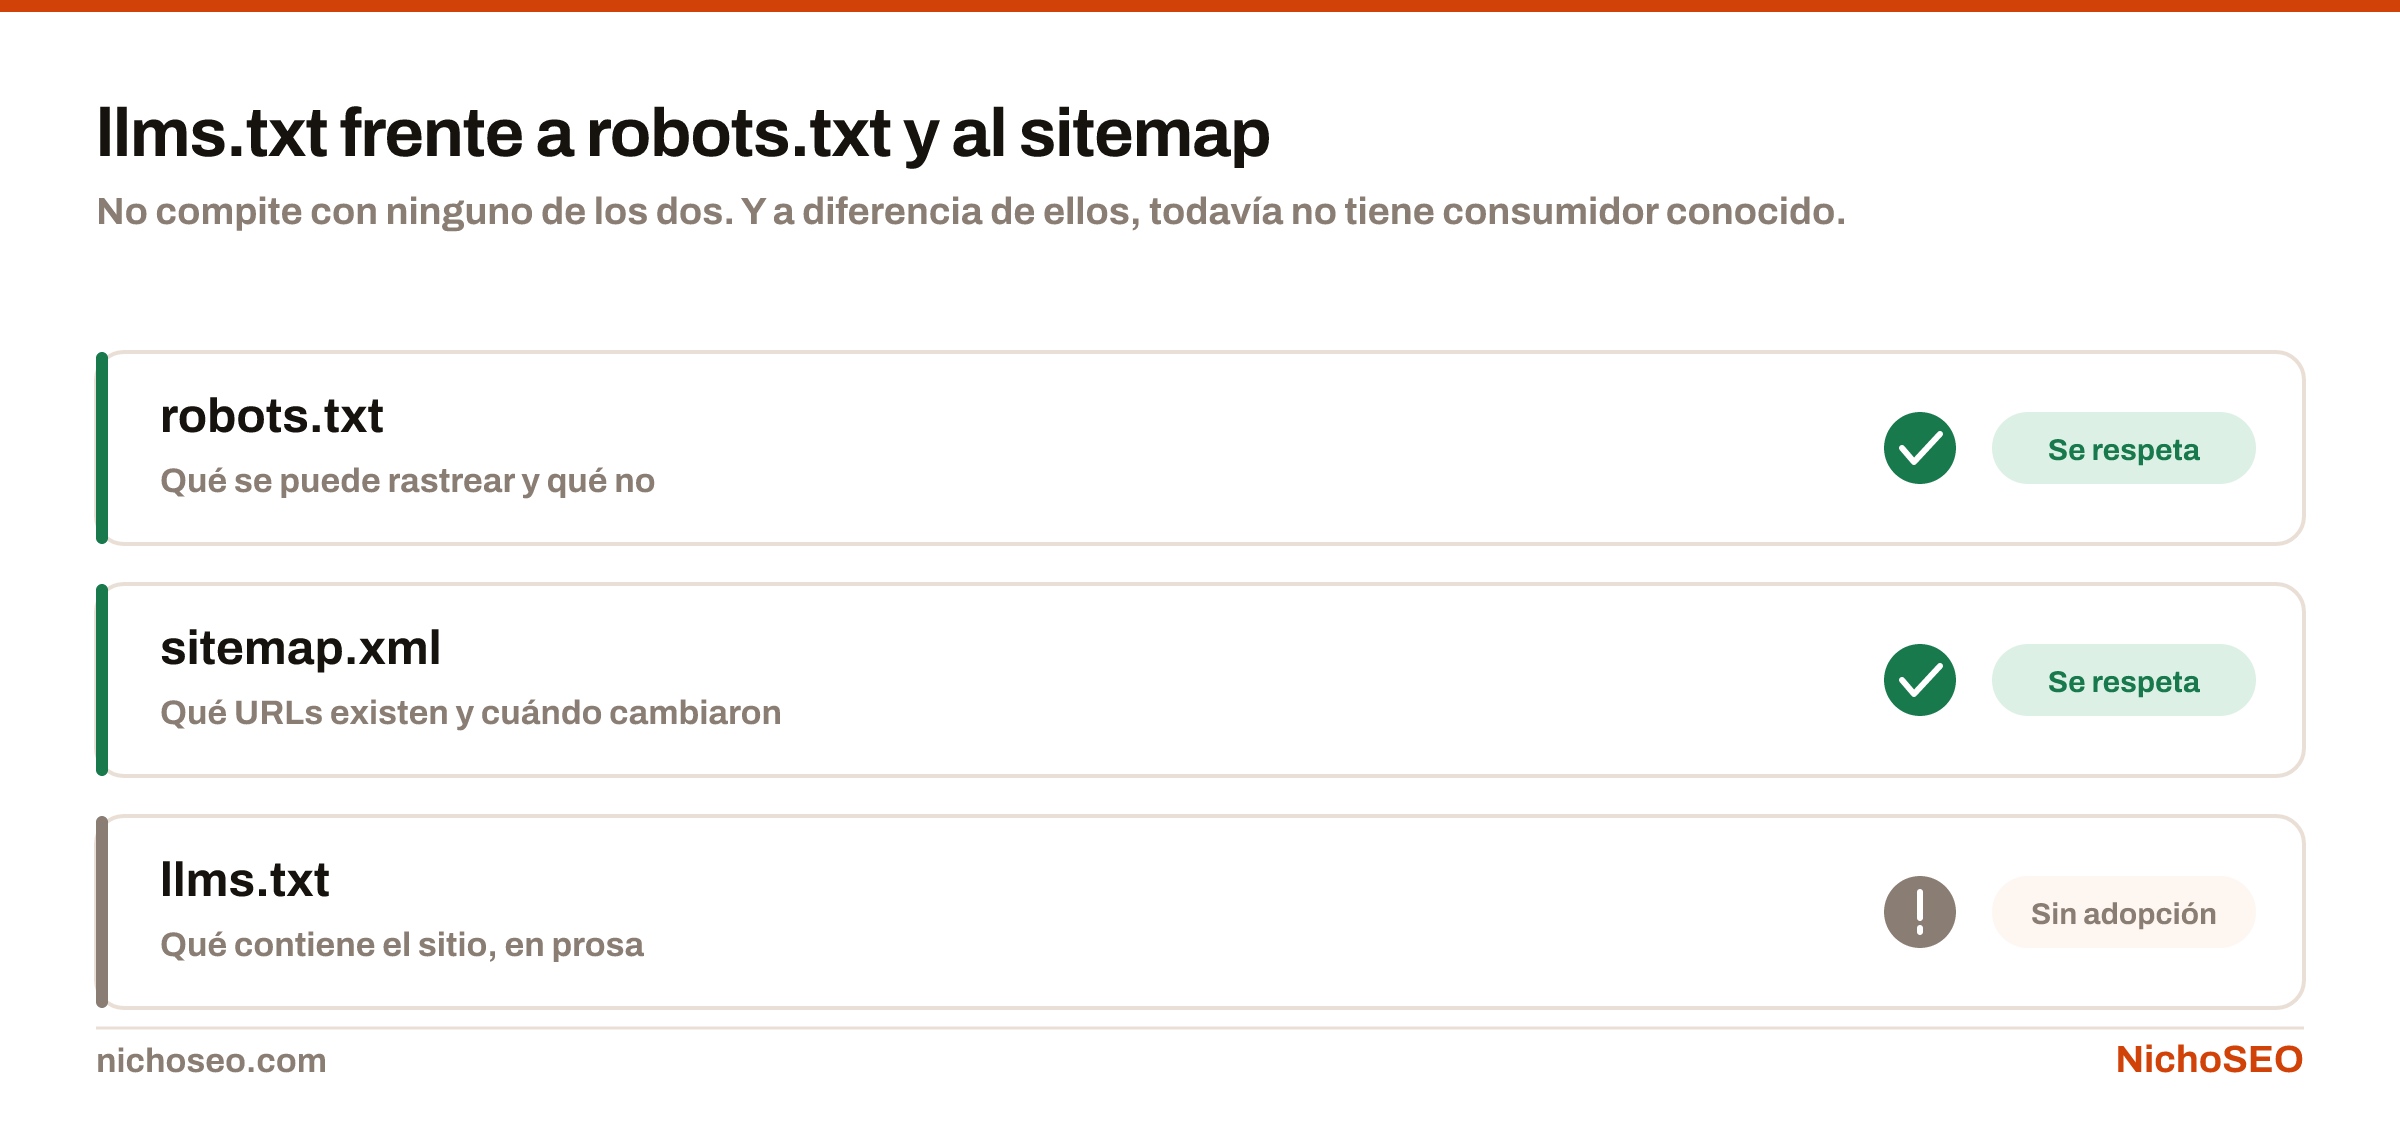
Comparación entre robots.txt, sitemap.xml y llms.txt: qué dice cada uno y si los buscadores lo respetan.
No compite con ninguno de los dos. Y a diferencia de ellos, todavía no tiene consumidor conocido.Descargar imagen

Cómo generar el sitemap: siempre automático

Automáticamente, siempre. Un sitemap escrito a mano está mal desde la segunda publicación. Todos los frameworks y gestores de contenido lo generan; lo que hay que hacer es configurarlo para que excluya lo que no corresponde.

Lo ideal es que la exclusión no sea una lista aparte que alguien tiene que acordarse de mantener, sino que se derive de la propia página: si una página lleva noindex, que el sitemap la saque sola. Así una decisión se toma en un solo lugar.

El lastmod tiene que ser real. Poner la fecha de hoy en todas las URLs en cada build es peor que no poner nada: se vuelve una señal sin información y se ignora. Que refleje cuándo cambió el contenido de verdad.

Los límites: 50.000 URLs o 50 MB sin comprimir por archivo. Pasado eso, se parte en varios y se agrega un índice de sitemaps que apunte a todos.

Cómo enviar el sitemap a Google

Declaralo en el robots.txt:

Sitemap: https://tusitio.com/sitemap-index.xml

Enviálo una vez en Search Console y en Bing Webmaster Tools. No hace falta reenviarlo con cada publicación: se vuelve a leer solo.

El diagnóstico para una página que no se indexa: comprobar si está bloqueada, si devuelve 200, si tiene noindex, si el canonical apunta a otro lado y si hay contenido propio.
El sitemap ayuda a que Google descubra una página. Que la guarde depende de estas cinco cosas.Descargar imagen

La documentación completa está en sitemaps y en cómo crear y enviar uno.

Qué esperar de un sitemap (y qué no)

El sitemap acelera el descubrimiento de páginas nuevas y ayuda en sitios grandes o mal enlazados internamente. En un sitio chico y bien enlazado, el aporte es modesto: las páginas se descubren igual siguiendo enlaces internos.

Lo que no hace nunca es forzar una indexación. Si una página está en el sitemap y no se indexa, el problema está en la página —calidad, duplicación, señales contradictorias— y no en el archivo.

6 de 13

Hreflang: las 3 reglas y cómo implementarlo sin romper nada

La forma de declarar qué versión de una página corresponde a cada idioma o región. Tres reglas que hay que cumplir enteras: si falla una, se descarta todo.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Lo que hace es ayudar a mostrar la versión correcta a cada persona. Lo que no hace: no redirige a nadie, no es un factor de ranking, y no arregla contenido duplicado por sí solo.

Las 3 reglas del hreflang

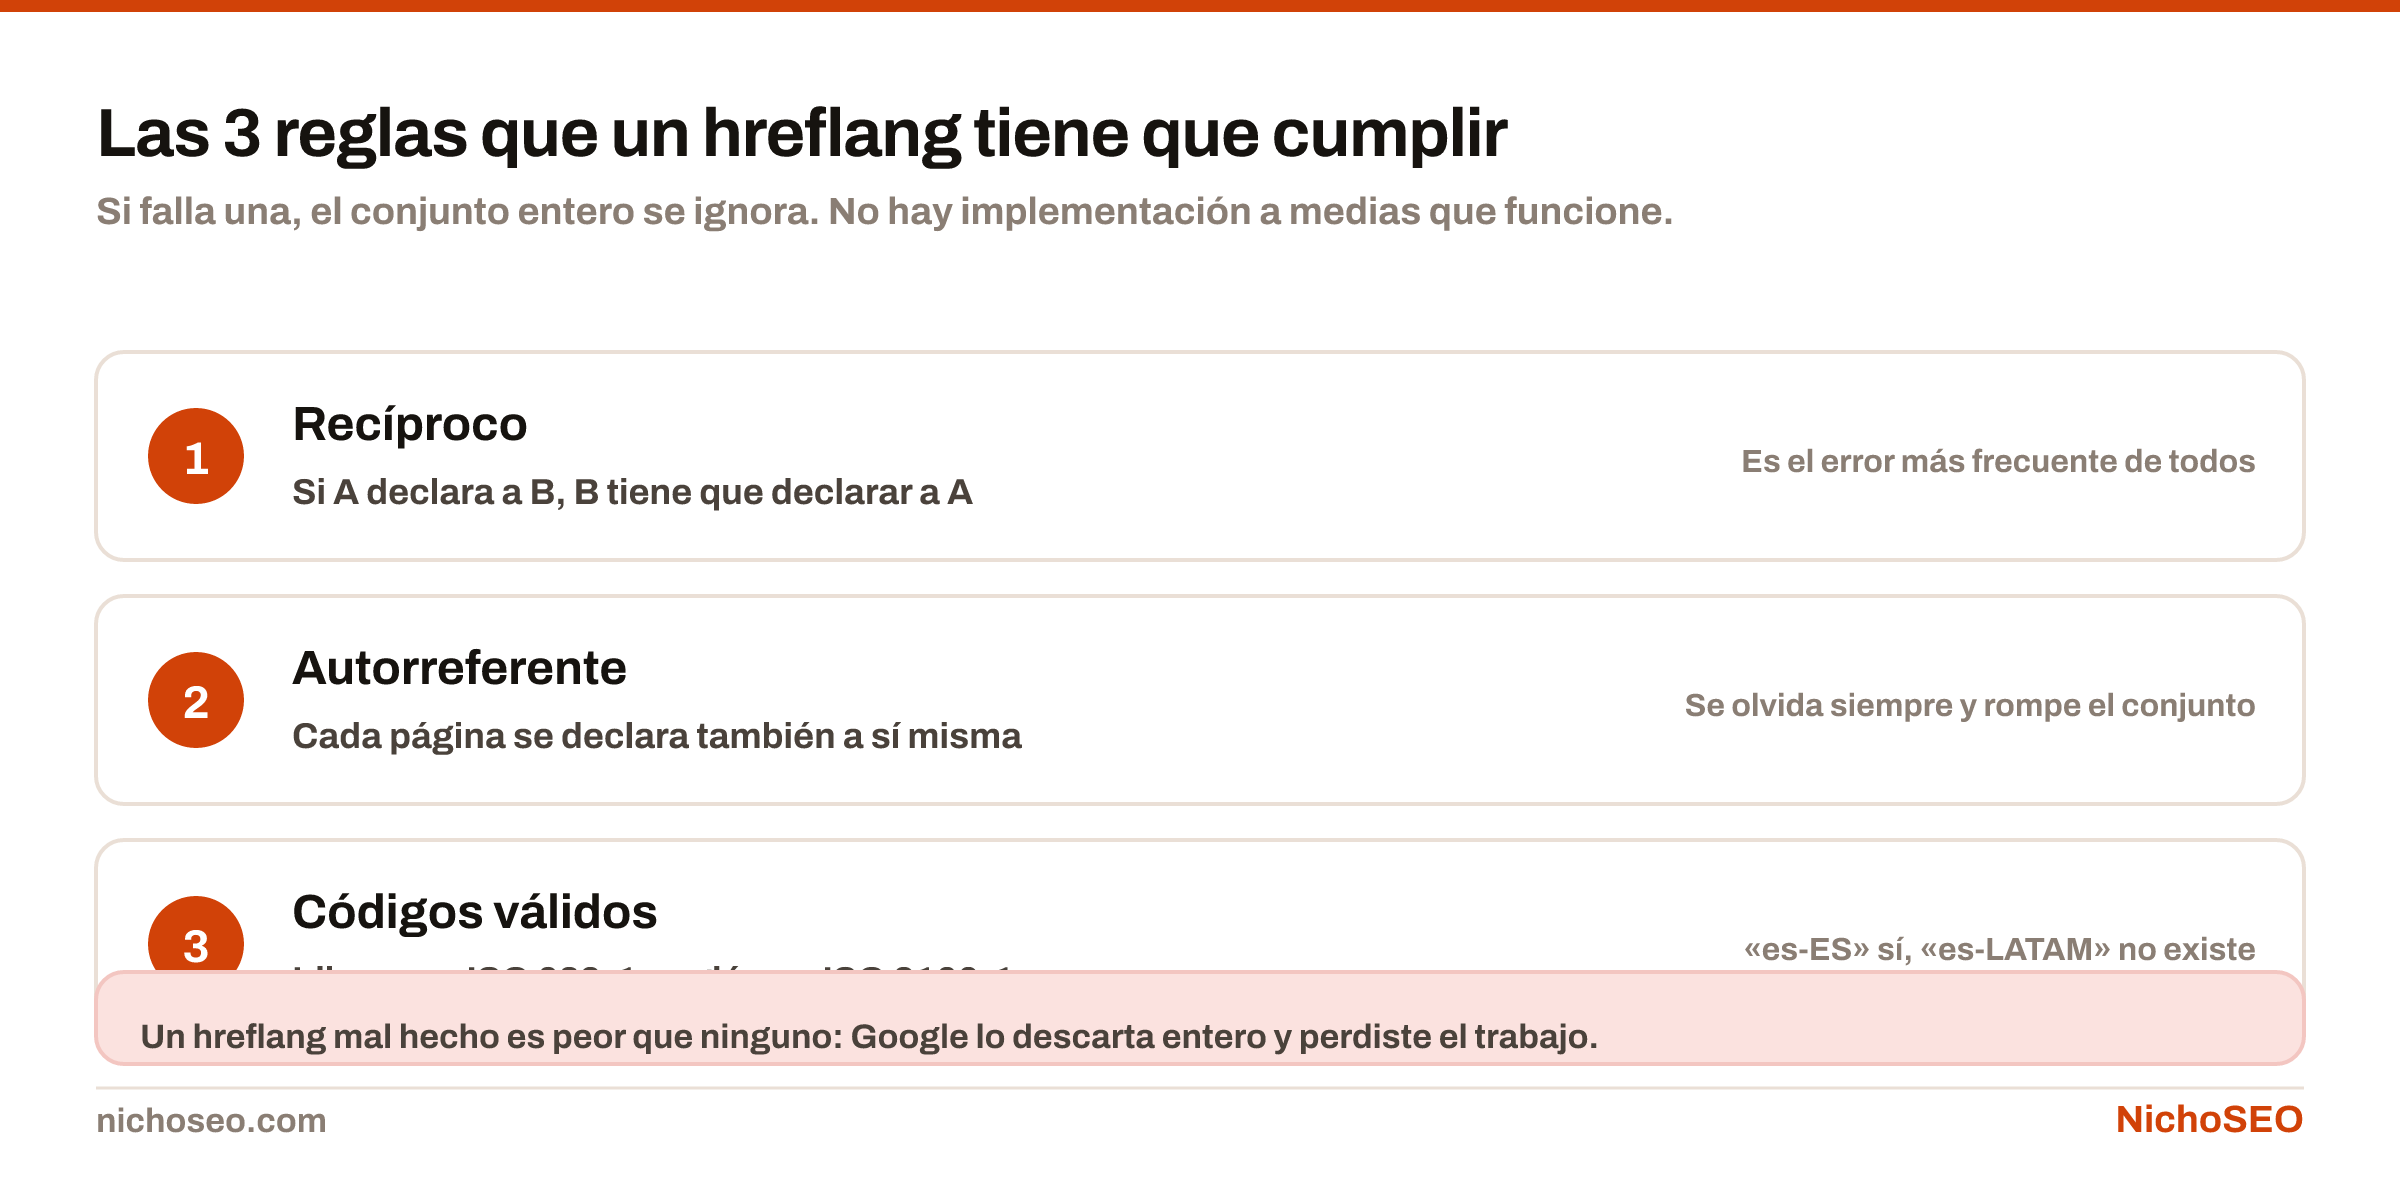
Las tres reglas del hreflang: que sea recíproco, que incluya una etiqueta a sí misma y que use códigos válidos de idioma y región.
Si falla una, el conjunto entero se ignora. No hay implementación a medias que funcione.Descargar imagen

1. Reciprocidad. Si la página en español declara a la inglesa, la inglesa tiene que declarar a la española. Un grupo sin reciprocidad se ignora entero.

2. Cada página se declara a sí misma. La versión en español tiene que incluir una línea apuntando a sí misma. Es lo que más se olvida.

3. URLs absolutas y canónicas. Con dominio completo, y apuntando a la versión canónica de cada una.

Cómo se implementa el hreflang, con ejemplo

En el <head> de cada versión, las mismas líneas en todas:

<link rel="alternate" hreflang="es-AR" href="https://sitio.com/ar/pagina/" />
<link rel="alternate" hreflang="es-MX" href="https://sitio.com/mx/pagina/" />
<link rel="alternate" hreflang="es" href="https://sitio.com/es/pagina/" />
<link rel="alternate" hreflang="x-default" href="https://sitio.com/es/pagina/" />

El código de idioma va en ISO 639-1 y el de país, cuando lo hay, en ISO 3166-1 alfa-2. El idioma es obligatorio, el país es opcional. hreflang="ar" no significa Argentina: significa árabe, y es un error clásico.

x-default no es «inglés» ni «el principal»

Es la versión que se muestra cuando ninguna otra encaja con el usuario. En un sitio en español para varios países, lo razonable es que apunte a la versión neutra, no a la del país más grande.

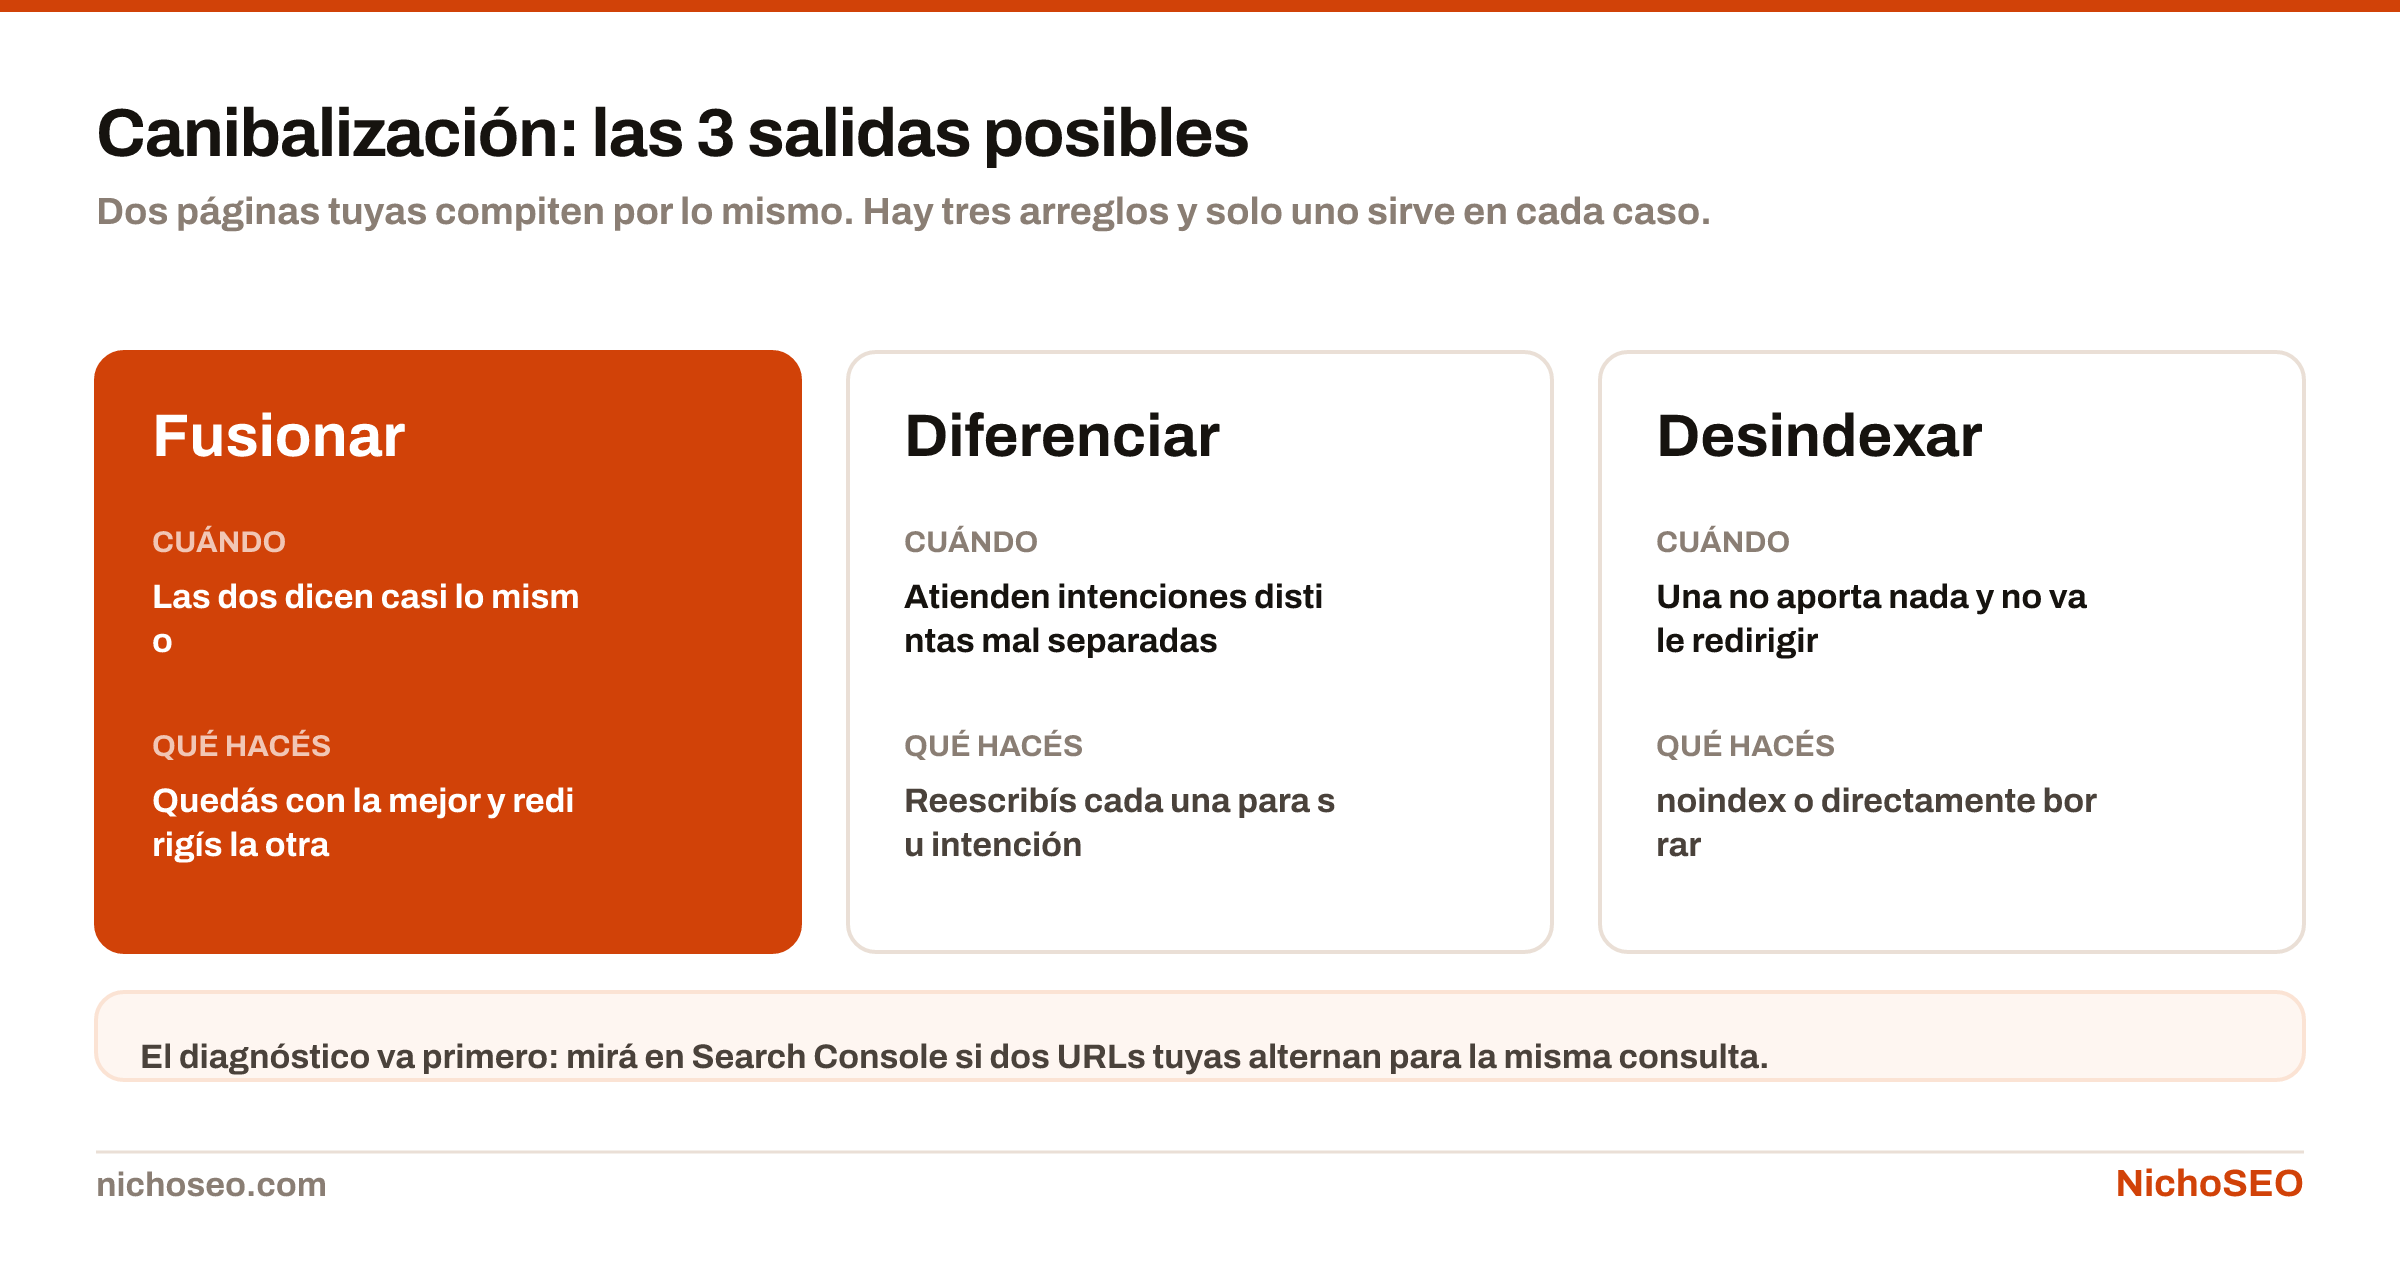
Las tres salidas para resolver una canibalización: fusionar las páginas en una, diferenciarlas por intención, o desindexar la que sobra.
Si tenés dos páginas casi iguales en el mismo idioma, no es hreflang lo que necesitás: es una de estas tres salidas.Descargar imagen

¿Te hace falta hreflang? Casi siempre no

Esta es la pregunta que más plata ahorra.

Hreflang tiene sentido cuando hay contenido realmente distinto por región: precios, disponibilidad, marco legal, modismos que cambian el significado.

No tiene sentido cuando las cinco versiones son el mismo texto en español con tres palabras cambiadas. Ahí lo que se consigue es multiplicar por cinco las páginas a mantener, diluir las señales entre cinco URLs, acercarse peligrosamente al contenido delgado y agregar una fuente de errores, a cambio de casi nada.

Una sola página en español bien hecha suele rendir más que cinco casi iguales. Es una decisión de arquitectura, y conviene tomarla antes de escribir una línea de hreflang.

Los seis errores de SEO técnico más frecuentes, agrupados según qué condición rompen: rastreo, renderizado o indexación.
Un hreflang roto se comporta como un canonical mal puesto: Google se queda con una versión y descarta las demás.Descargar imagen

Cómo comprobar que tu hreflang funciona

El informe de segmentación internacional de Search Console muestra los errores de reciprocidad y los códigos inválidos, que son el 90% de los problemas.

El resto se ve a mano: abrí dos versiones de la misma página y comprobá que las dos listan el grupo completo, con las mismas URLs, y que cada una se incluye a sí misma.

La referencia es versiones localizadas de tus páginas, de Google.

El error de hreflang más caro

Redirigir por IP. Mandar automáticamente a cada visitante a la versión de su país impide que un rastreador vea las demás, y rompe la experiencia de cualquiera que quiera leer otra versión a propósito. Si querés sugerir un cambio de versión, sugerilo con un aviso que se pueda ignorar.

7 de 13

Migración SEO: cambiar de dominio sin perder tráfico

Casi todas las caídas de tráfico tras una mudanza salen del mismo paso salteado. Los cinco pasos en orden, qué se redirige a qué y cuánto es normal caer.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Todo eso viaja por un solo canal: las redirecciones. Si el mapa está bien hecho, se pierde poco; si no, se pierde casi todo.

Qué se mueve y qué se queda

Conviene ser preciso con qué cuenta como migración, porque el riesgo cambia mucho.

Cambiar de dominio, cambiar la estructura de las URLs o pasar de http a https son migraciones: cambia la dirección de las páginas, y hay que decirle a Google a dónde fueron.

Cambiar el diseño sin tocar las direcciones no lo es. Cambiar de servidor tampoco. Son riesgosos por otros motivos, pero no obligan a rehacer el mapa.

La distinción práctica: si después del cambio una URL vieja deja de devolver la página que devolvía, es una migración.

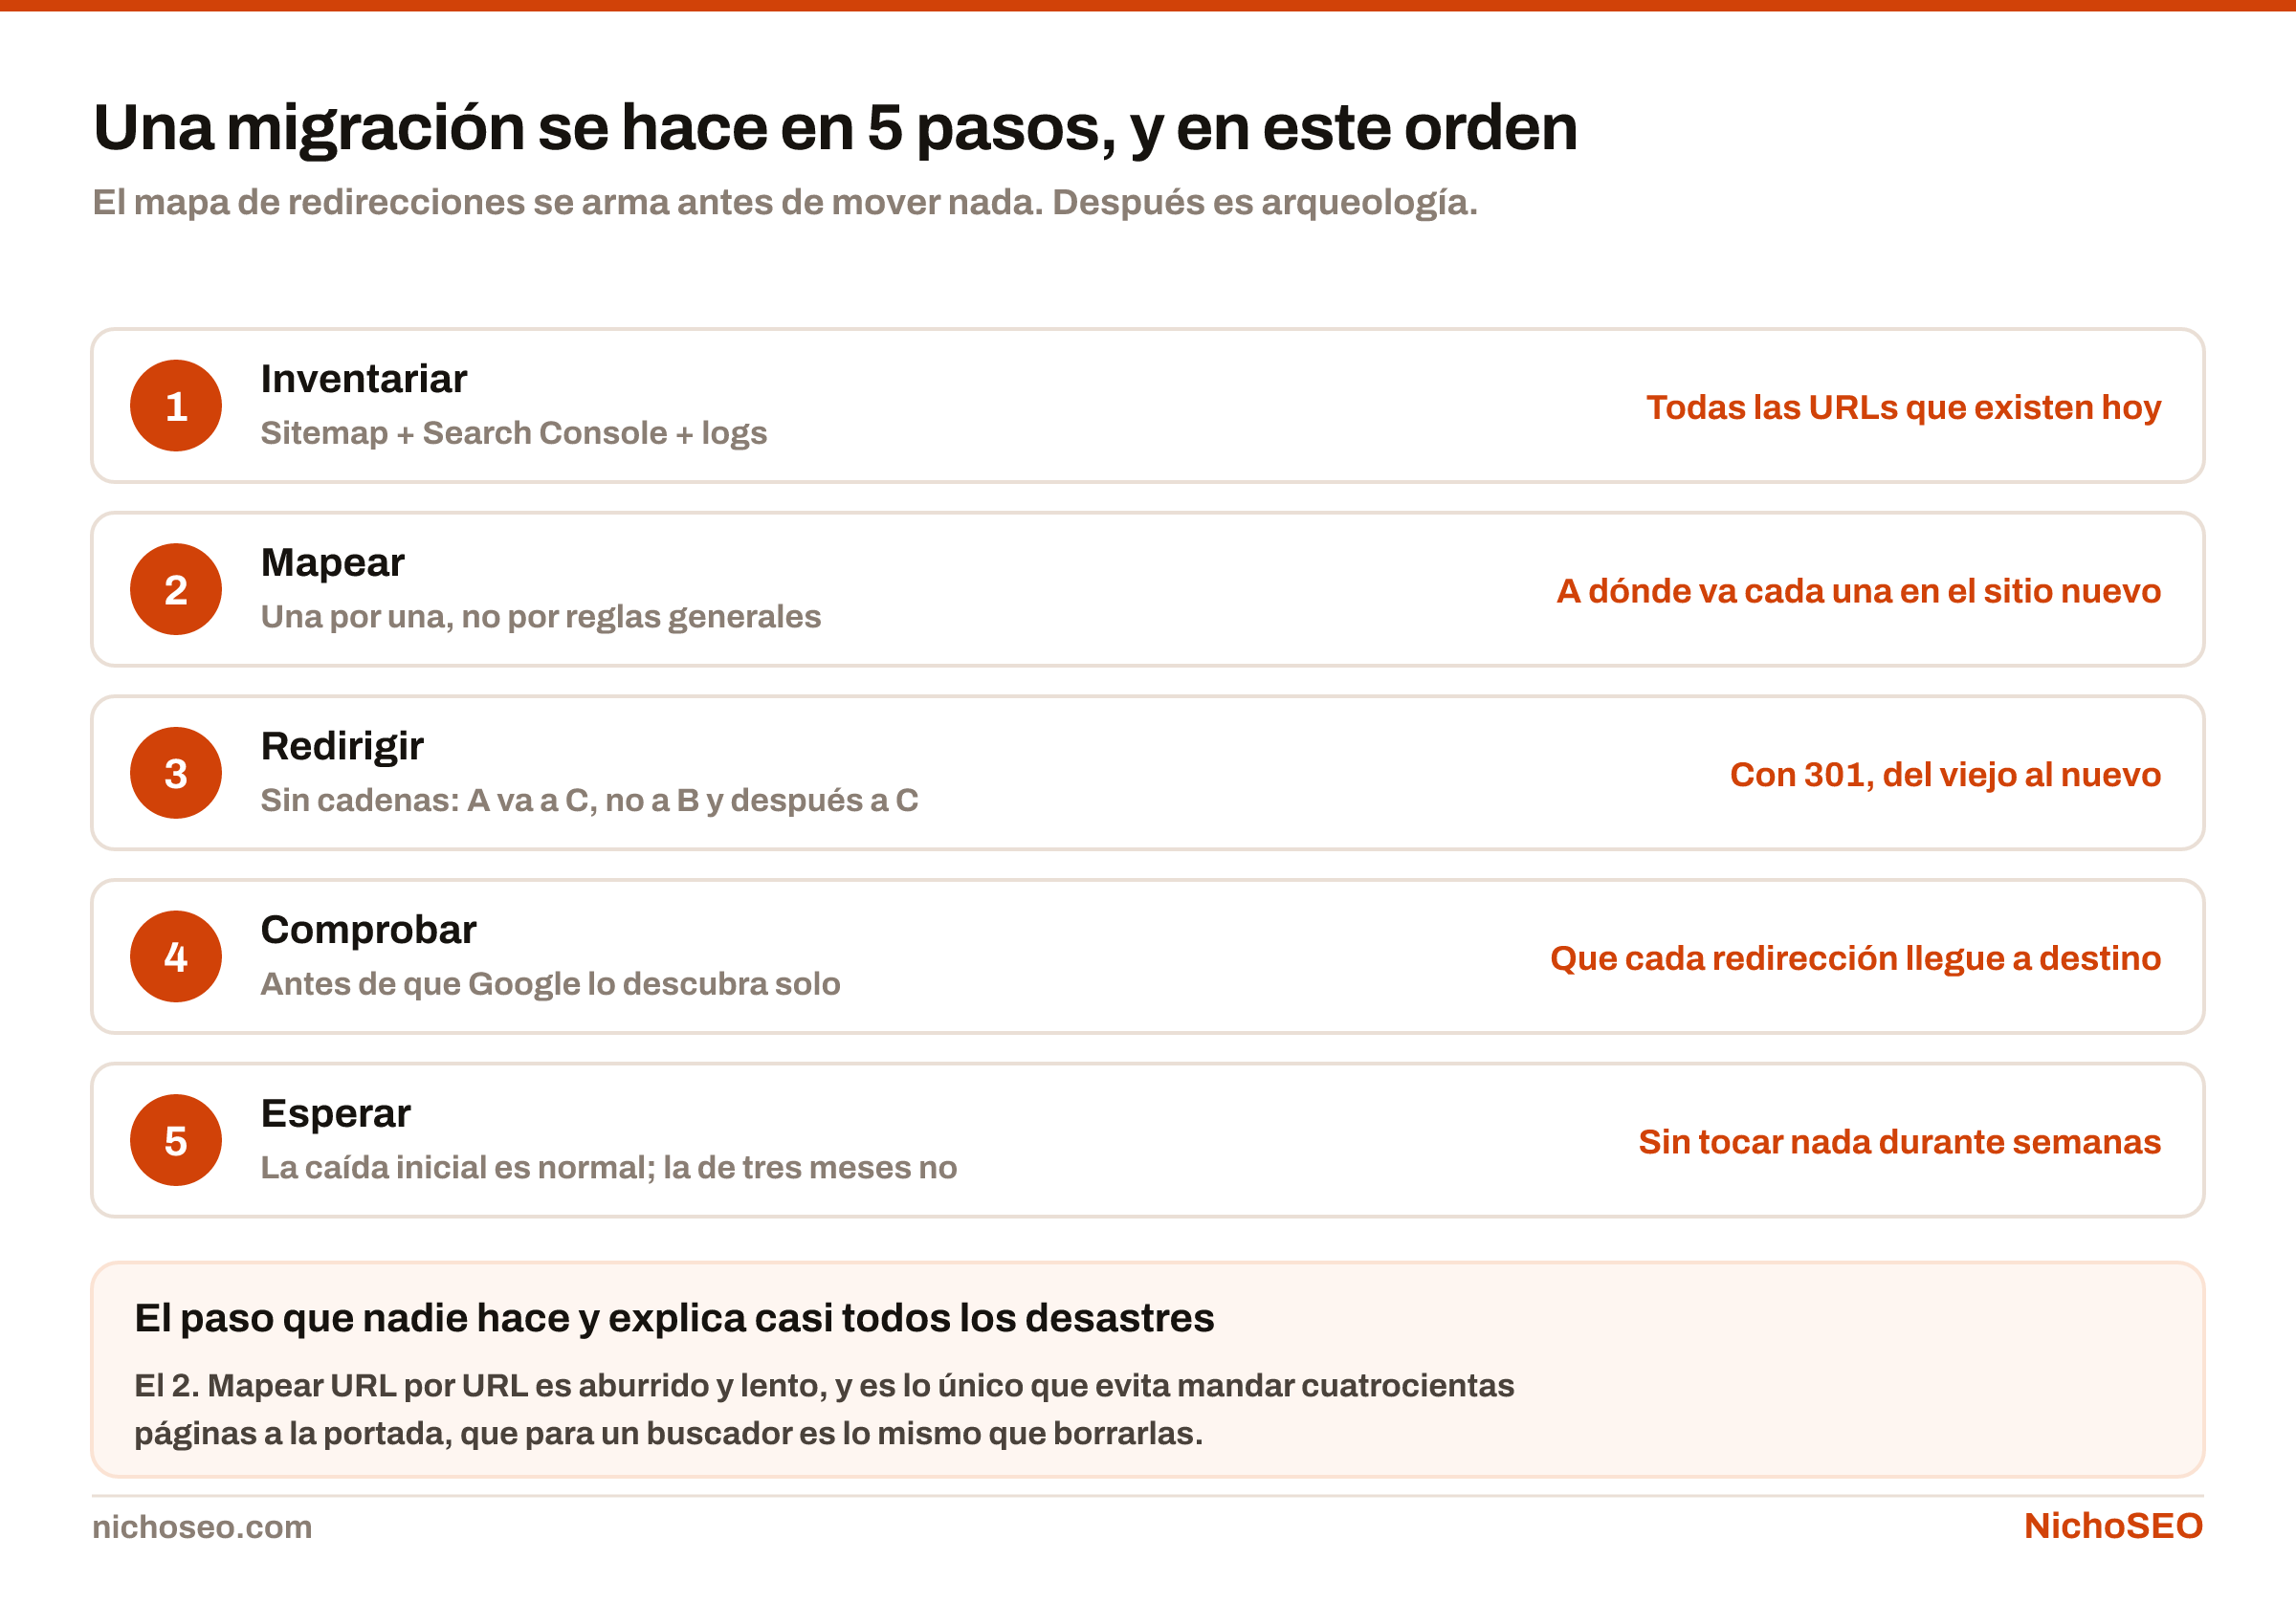
Los 5 pasos, en orden

Los cinco pasos de una migración de sitio en orden: inventariar lo que existe, decidir el destino de cada URL, redirigir con 301, comprobar en el sitio nuevo y esperar sin tocar nada.
El mapa de redirecciones se arma antes de mover nada. Después es arqueología.Descargar imagen

El orden no es una sugerencia. El paso 2 —mapear— hay que hacerlo con el sitio viejo todavía en pie, porque es la única forma de saber qué existía.

1. Inventariar todo lo que existe hoy

No alcanza con el sitemap: el sitemap tiene lo que vos creés que existe.

Hacen falta tres fuentes cruzadas:

  1. El sitemap, que da la lista declarada.
  2. Search Console, informe de páginas: ahí están las que Google conoce, incluidas las que vos olvidaste.
  3. Los registros del servidor, que muestran las que reciben visitas de verdad, incluidas las que ningún enlace interno alcanza. Cómo leerlos está en análisis de logs para SEO.

La tercera fuente es la que aparece siempre con sorpresas: URLs viejas de campañas, PDFs enlazados desde otro sitio, páginas huérfanas que igual reciben gente.

Qué incluir en un sitemap XML —páginas indexables, canónicas y que devuelven 200— y qué dejar afuera: redirecciones, noindex, paginados y URLs con parámetros.
El sitemap declara lo que vos creés que existe. El inventario de una migración tiene que incluir lo que existe igual.Descargar imagen

2. Mapear URL por URL

Es el paso aburrido y el que decide el resultado.

Una planilla con dos columnas: la dirección vieja y la nueva. Una fila por URL. La plantilla está hecha, con las columnas de comprobación incluidas. Sin reglas generales del tipo “todo lo de /blog/ va a /articulos/”, porque las excepciones son justo las páginas que importan.

Un mapa que conserva el tráfico

  • Cada URL vieja apunta a su equivalente más cercana
  • Si no hay equivalente, va a la categoría de ese tema
  • Las que no tienen destino razonable devuelven 410
  • El mapa se revisa a mano antes de aplicarlo

Uno que lo tira

  • Todo lo que no coincide va a la portada
  • Una regla general con expresiones regulares y nada más
  • Las que sobran quedan en 404 sin decidirlo
  • Se aplica y se revisa después, si hay tiempo
Mandar todo a la portada es, para un buscador, lo mismo que borrar esas páginas.

Ese primer punto de la derecha merece insistencia, porque se hace todo el tiempo. Una redirección a la portada le dice a Google que la página vieja no tiene equivalente: la trata como borrada y no traslada nada.

3. Redirigir con 301, y sin cadenas

La 301 es la que dice «esto se mudó para siempre» y es la que traslada las señales. La diferencia con la 302 y cuándo corresponde cada una está en redirecciones 301.

Lo que casi siempre sale mal es la cadena: la URL vieja apunta a una intermedia que apunta al destino. Pasa cuando el sitio ya tenía redirecciones de una mudanza anterior.

Diferencia entre una redirección 301 permanente, que traslada las señales acumuladas a la nueva URL, y una 302 temporal, que las deja en la original.
La diferencia no es cosmética: una traslada las señales acumuladas y la otra no.Descargar imagen

La regla: cada URL vieja apunta directo al destino final. Si ya había redirecciones, hay que reescribirlas para que salten el intermedio.

4. Comprobar antes de que lo descubra Google

Con el sitio nuevo arriba, recorrer la columna vieja de la planilla y comprobar que cada una llegue a donde debía, con un solo salto.

while read url; do
  printf '%s → %s\n' "$url" "$(curl -sI -o /dev/null -w '%{http_code} %{redirect_url}' "$url")"
done < urls-viejas.txt

Lo que hay que buscar: cualquier 404, cualquier 302 que debía ser 301, y cualquier destino que no sea el de la planilla.

A partir de cierto tamaño esto no se hace a mano: cuándo se justifica una herramienta de rastreo está en herramientas de rastreo.

5. Esperar sin tocar nada

Es el paso que más cuesta y el más importante.

Google necesita volver a rastrear todo, seguir cada redirección y trasladar las señales. Eso lleva semanas, y durante ese tiempo los números bajan.

Cuánto es normal caer

La curva típica de una migración bien hecha

10-20 %Semanas 1 a 3Caída normal mientras Google reprocesa
RecuperaciónSemanas 4 a 8Vuelve, a veces por encima
Sigue abajoMes 3Ahí hay un problema real, no paciencia
Son órdenes de magnitud observados, no una promesa: dependen del tamaño y de qué cambió.

La distinción importa porque define cuándo actuar. En la semana dos, mirar los datos y no tocar nada es lo correcto. En el mes tres, esperar más es perder el tiempo.

Si a los tres meses no volvió, lo primero que hay que revisar no es el contenido: es la planilla del paso 2, buscando URLs que se quedaron sin destino.

Los 4 errores que explican casi todas las migraciones fallidas

1. Cambiar varias cosas a la vez. Dominio, diseño, estructura de URLs y contenido en el mismo lanzamiento. Si cae el tráfico, no hay forma de saber cuál fue. Conviene separarlas por semanas.

2. No inventariar antes. Una vez que el sitio viejo bajó, reconstruir qué URLs existían es arqueología: quedan Search Console y lo que haya en el archivo de la web.

3. Dejar el sitio viejo apagado sin redirecciones. Un dominio que deja de responder no transmite nada. Las redirecciones tienen que vivir en el servidor viejo, y ese servidor tiene que seguir encendido al menos un año.

4. Bloquear el sitio nuevo sin querer. El robots.txt del entorno de pruebas, con su Disallow: /, sale a producción. Es el clásico, y se detecta en dos minutos: qué se puede y qué no con el robots.txt.

Qué hacer el día del cambio

Una lista corta para el momento en que se levanta el sitio nuevo:

  1. Comprobar que el robots.txt nuevo no bloquee nada que no quieras.
  2. Comprobar que no haya quedado un noindex de las pruebas: el diagnóstico de indexación.
  3. Enviar el sitemap nuevo en Search Console, y dejar el viejo hasta que se procese.
  4. Si cambió el dominio, usar la herramienta de cambio de dirección de Search Console. No reemplaza a las redirecciones: las acompaña.
  5. Anotar la fecha. Sin ese dato, dentro de dos meses nadie va a poder relacionar una caída con la mudanza.

La documentación oficial de Google sobre migraciones, con la distinción entre las que cambian URLs y las que no, está en su guía de migraciones.

8 de 13

Contenido duplicado: cuándo importa y cómo se resuelve

No existe la penalización por contenido duplicado. Existe que Google elija una versión y no sea la tuya. Los tres casos y qué hacer con cada uno.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

De ahí sale todo lo que hay que entender del tema.

Por qué no existe la penalización

Es el mito más repetido del SEO y conviene desarmarlo primero, porque genera trabajo inútil.

Google no castiga por duplicar. Lo que hace es agrupar las versiones que considera equivalentes, elegir una —la canónica— y mostrar solo esa.

El problema no es que te bajen: es que la que elija puede no ser la que vos querías, y que las señales queden repartidas entre varias direcciones en vez de concentrarse en una.

El diagnóstico para una página que no se indexa: comprobar si está bloqueada, si devuelve 200, si tiene noindex, si el canonical apunta a otro lado y si hay contenido propio.
Cinco preguntas, siempre en este orden. La primera que dé «no» es tu problema.Descargar imagen

Cuando en Search Console una página figura como «Duplicada, Google eligió una canónica distinta», eso es exactamente esto. No es un castigo: es un aviso de que tu señal y su decisión no coinciden.

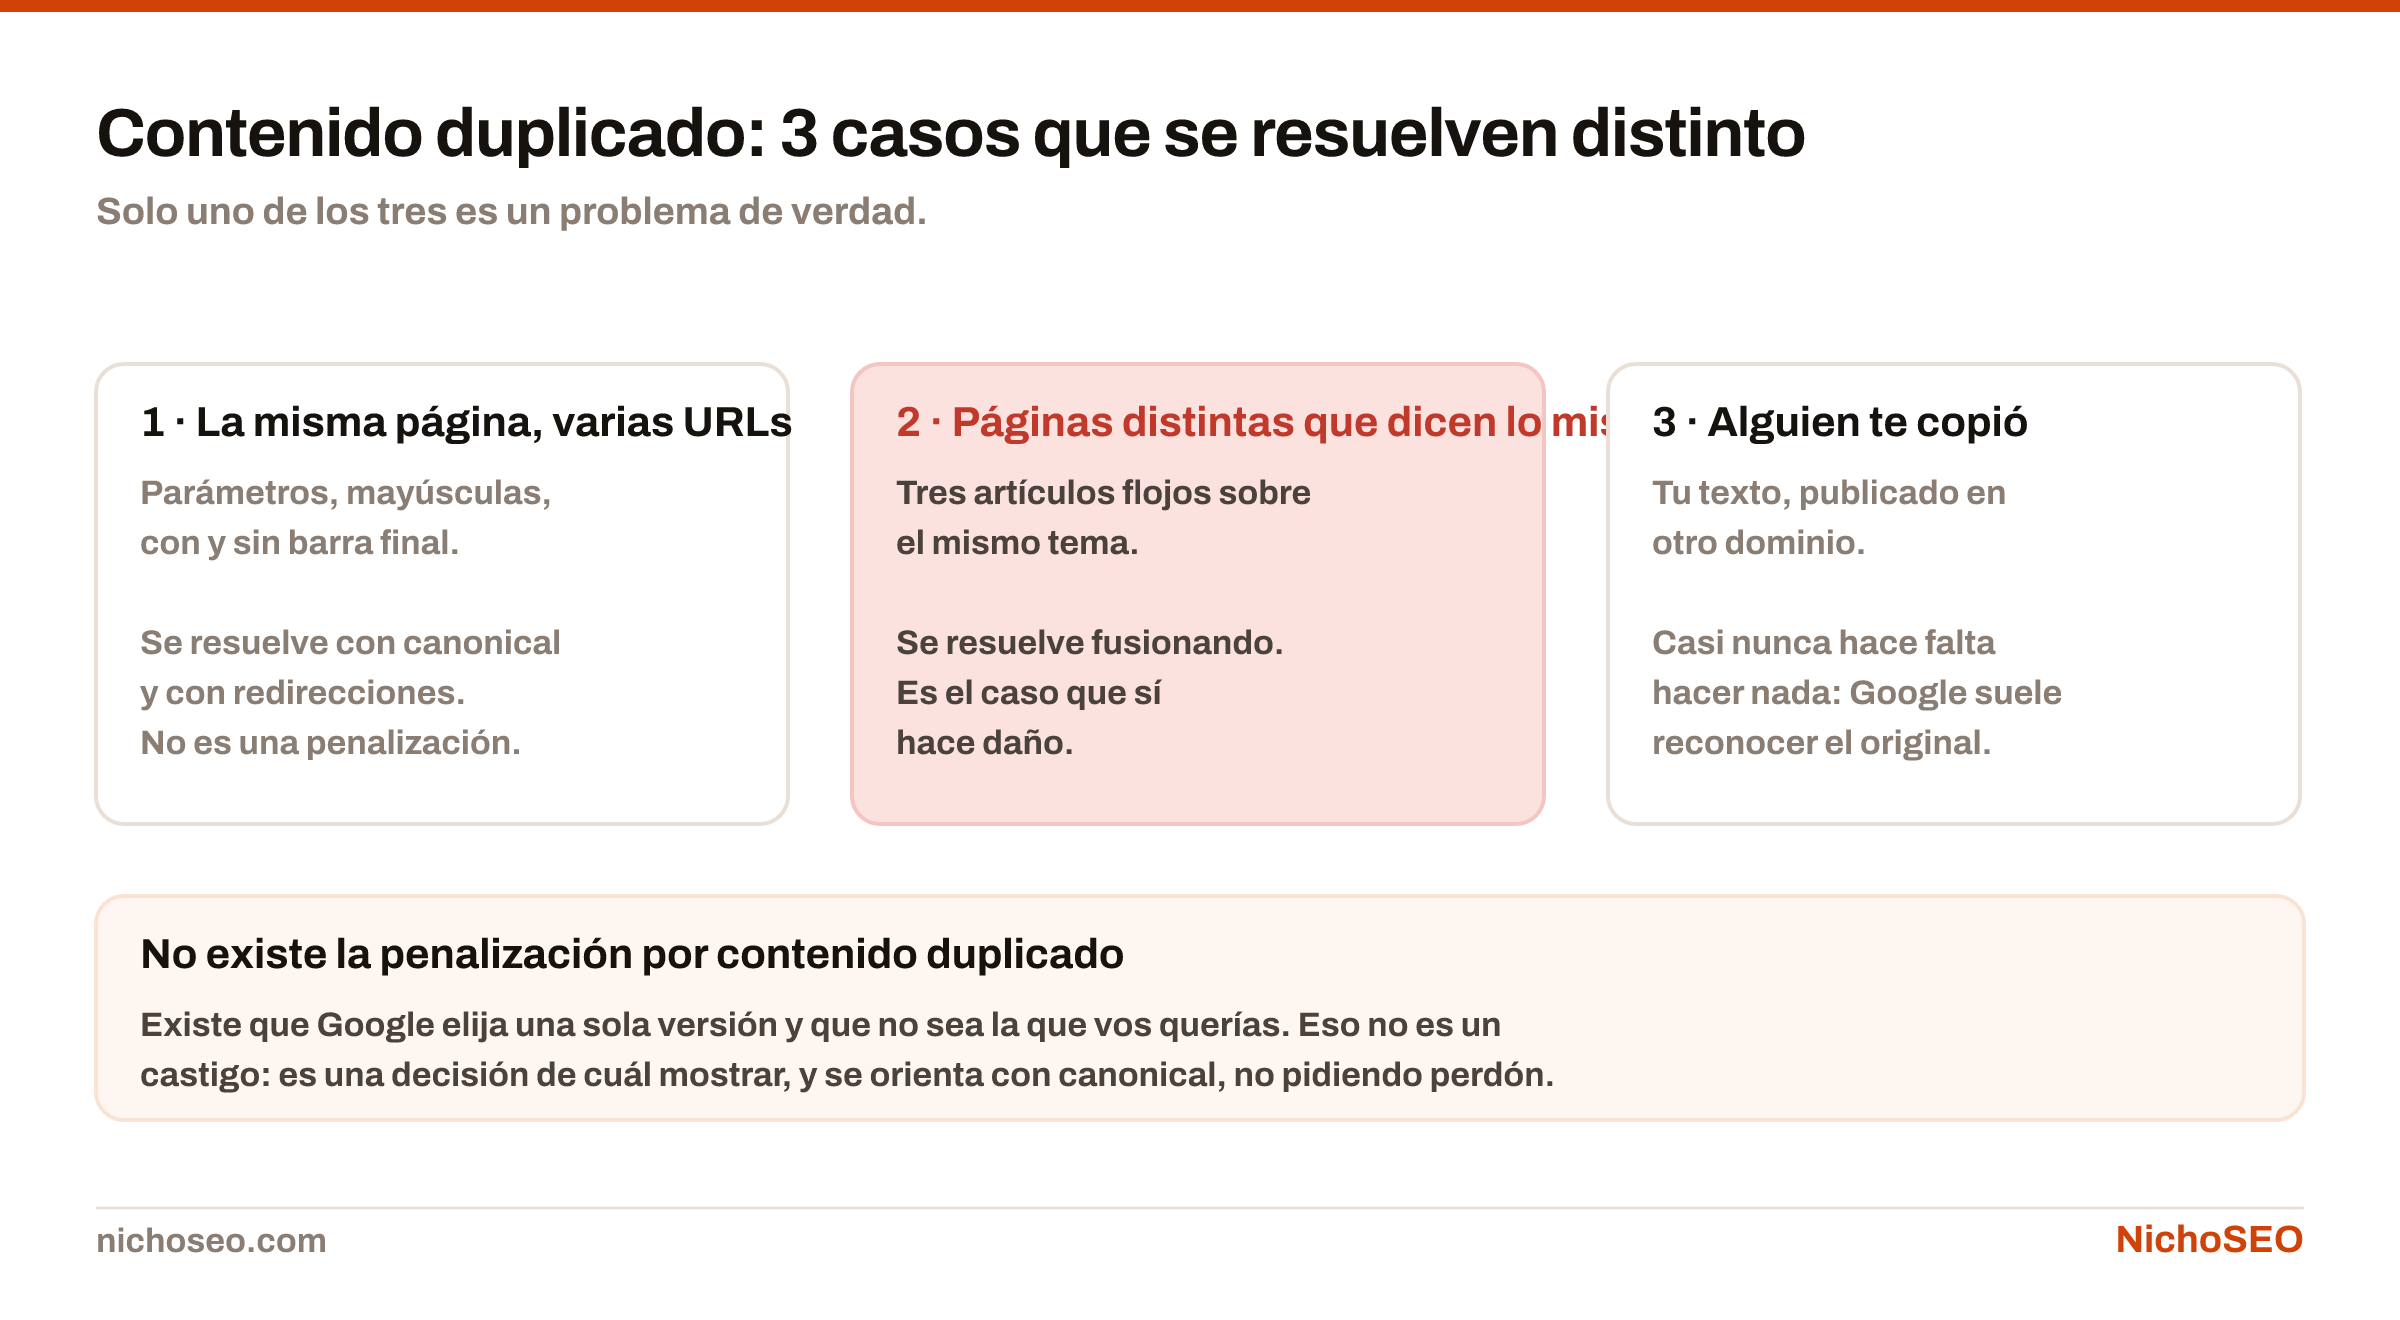
Los 3 casos, que se resuelven distinto

Los tres casos de contenido duplicado: el mismo contenido en varias URLs del propio sitio, contenido repetido entre páginas distintas, y contenido copiado de otro sitio. Cada uno se resuelve de manera diferente.
Solo uno de los tres es un problema de verdad.Descargar imagen

Meterlos en la misma bolsa es lo que hace que el tema parezca difícil. Son problemas distintos con soluciones distintas, y dos de los tres casi no importan.

Caso 1: la misma página en varias direcciones

Es el más común y el más inofensivo.

Las fuentes habituales: parámetros de campaña, versiones con y sin barra final, con y sin www, http y https, filtros de un listado, versiones para imprimir, identificadores de sesión.

Cómo se resuelve

  • Una canonical en cada versión apuntando a la principal
  • Redirección 301 cuando la versión vieja no debe existir
  • Enlaces internos que apunten siempre a la misma forma
  • Una sola forma en el sitemap

Lo que no hace falta

  • Bloquear las variantes en el robots.txt
  • Ponerles noindex a todas las variantes
  • Pedir una revisión a Google
  • Reescribir el texto para que no sea idéntico
Bloquear una variante impide que Google lea su canonical, que era justamente lo que resolvía el caso.

El detalle de la derecha que más se equivoca es el primero: bloquear en el robots.txt empeora las cosas. Si Google no puede leer la página, no puede leer su canonical, y entonces no sabe que es una variante. Qué hace y qué no hace ese archivo está en robots.txt.

Un detalle sobre la canonical: es una señal, no una orden. Google la tiene en cuenta junto con los enlaces internos, el sitemap y las redirecciones. Si todas esas señales dicen cosas distintas, gana la mayoría, no la etiqueta.

Por eso la regla práctica es que las cuatro señales coincidan: canonical, enlaces internos, sitemap y redirecciones apuntando todas a la misma versión.

Caso 2: páginas distintas que dicen lo mismo

Este sí hace daño, y no es un problema técnico: es editorial.

Son tres o cuatro artículos flojos sobre el mismo tema, escritos en momentos distintos, que compiten entre sí. Ninguno es lo bastante bueno para ganar y juntos reparten las señales.

Las tres salidas para resolver una canibalización: fusionar las páginas en una, diferenciarlas por intención, o desindexar la que sobra.
Dos páginas tuyas compiten por lo mismo. Hay tres arreglos y solo uno sirve en cada caso.Descargar imagen

Tiene nombre propio —canibalización— y tratamiento propio: está en canibalización SEO. La salida casi siempre es fusionar: una página buena que hereda las señales de las tres, con 301 desde las otras.

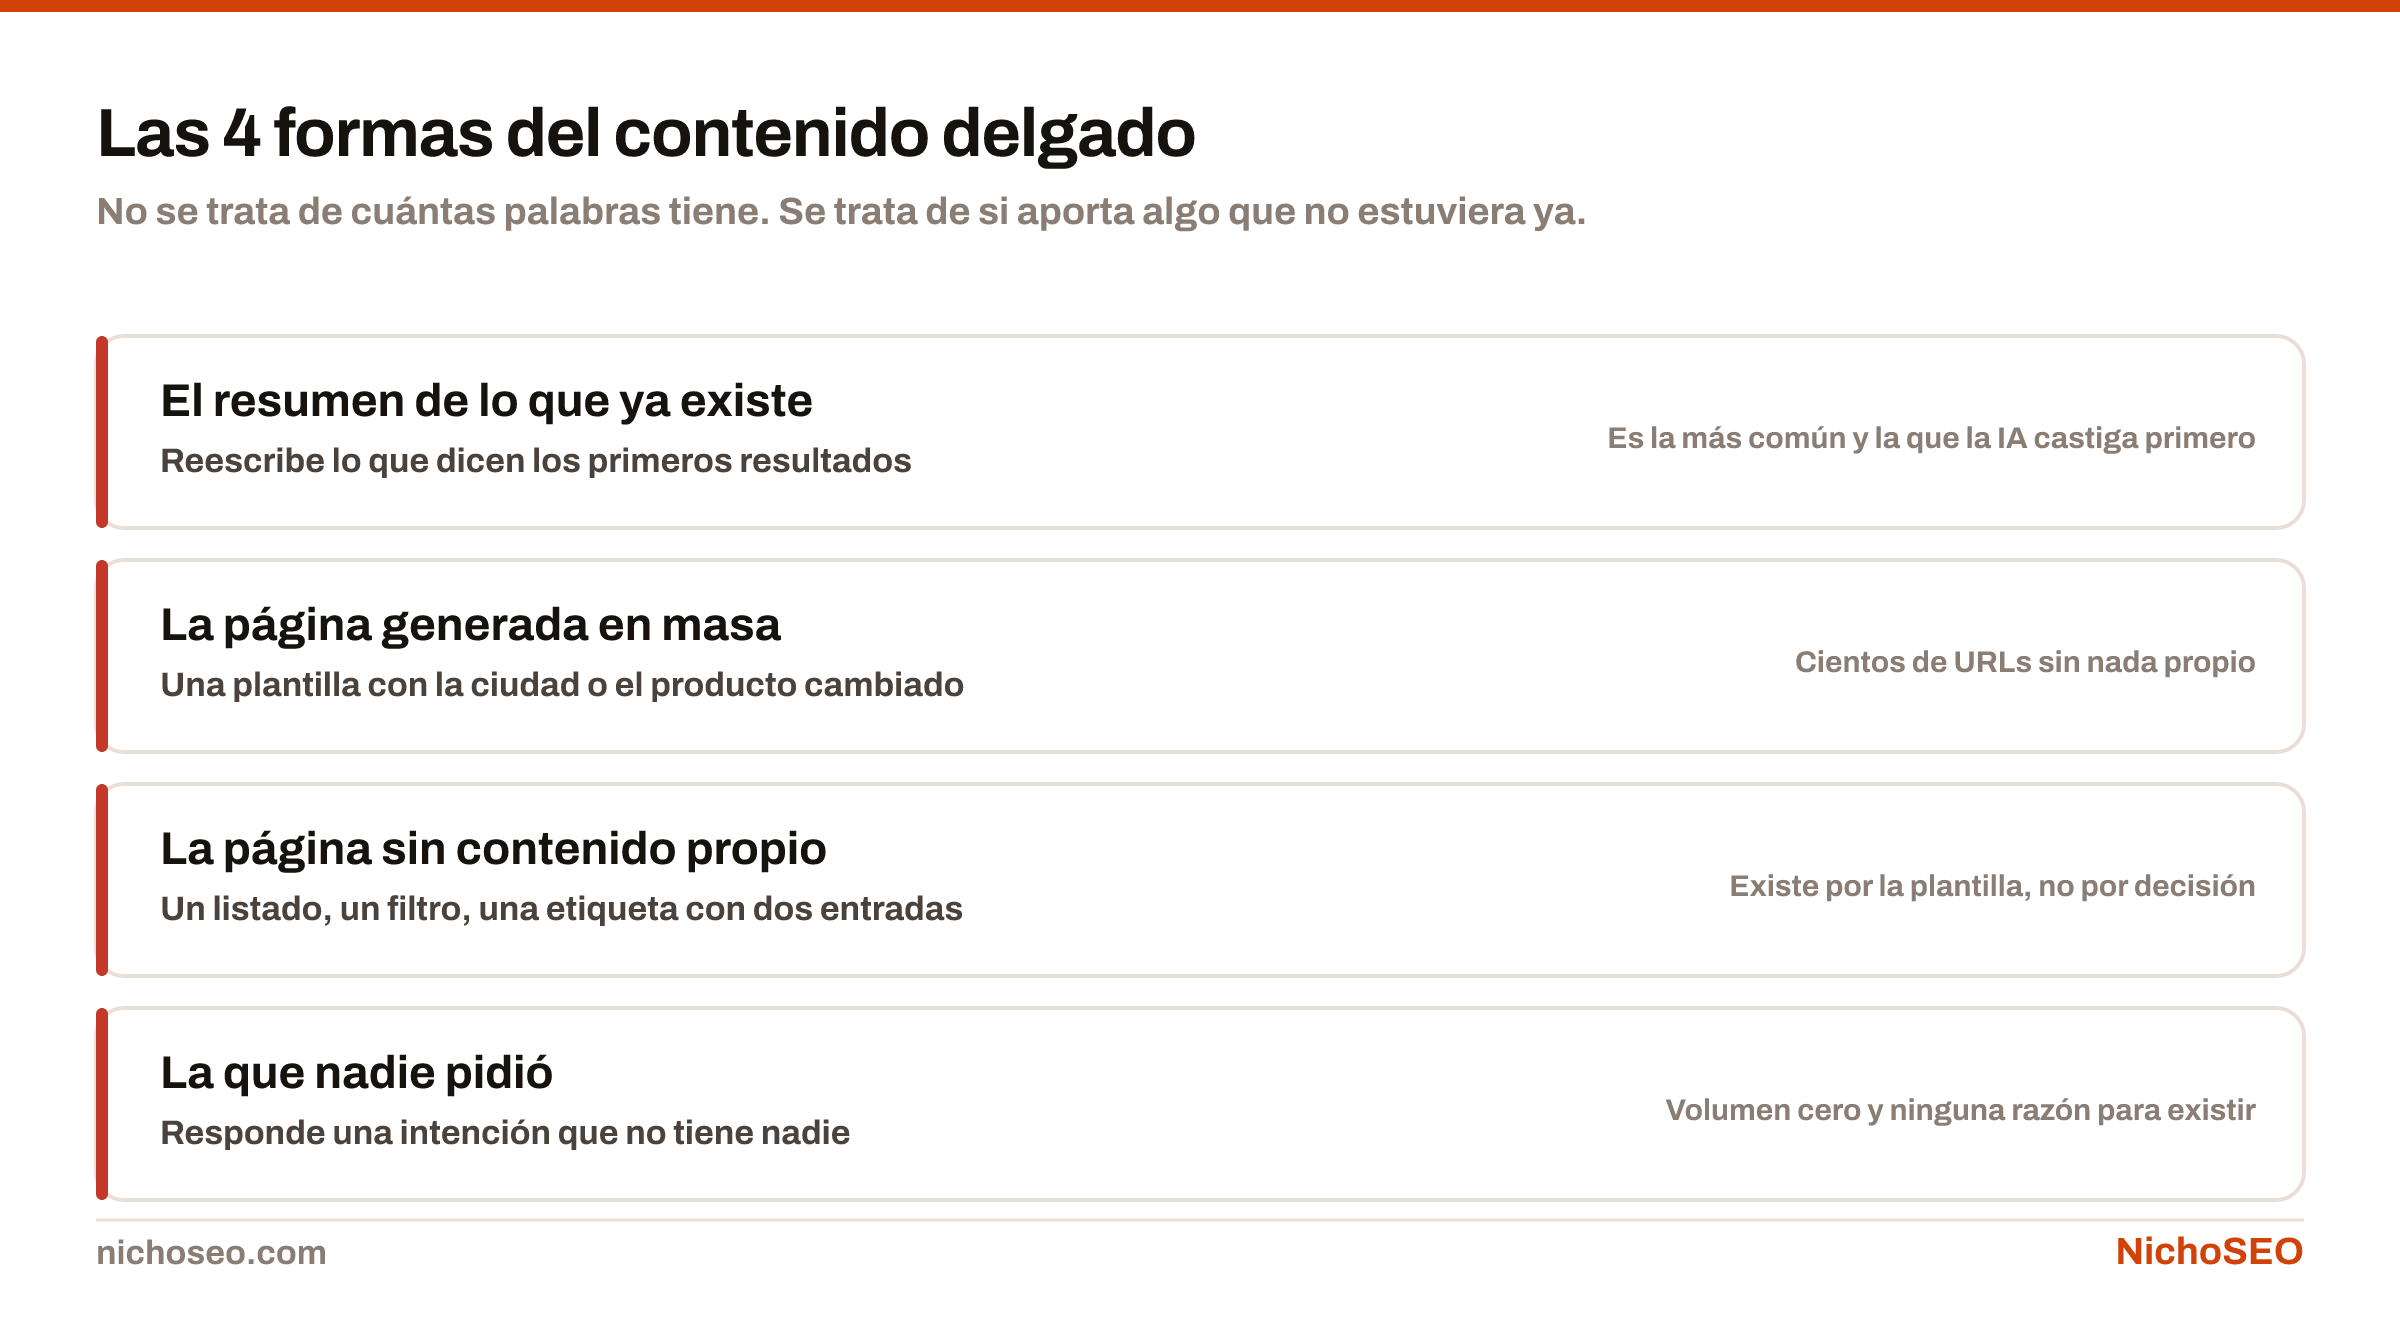
Cómo detectar cuáles están flojas, y el criterio para decidir entre ampliar, fusionar o borrar, está en thin content.

Las cuatro formas del contenido delgado: el resumen de lo que ya existe, la página generada en masa, la página sin contenido propio y la que responde una intención que nadie tiene.
No se trata de cuántas palabras tiene. Se trata de si aporta algo que no estuviera ya.Descargar imagen

Caso 3: alguien copió tu contenido

Casi nunca hay que hacer nada, y esa es la respuesta que menos gusta.

Google suele reconocer el original: lo publicó antes, tiene más señales y lo tiene indexado desde hace más tiempo. En la enorme mayoría de los casos el copión no aparece por encima.

Cuándo sí conviene actuar, que es poco:

  1. Cuando el copión rankea por encima tuyo para tu propio contenido. Ahí hay un problema real y el camino es un reclamo por derechos de autor.
  2. Cuando lo copiaron con tu permiso —una sindicación, un medio que republica—. Ahí conviene pedirles una canonical hacia tu original, que es lo que evita la ambigüedad.

Lo que no sirve: reescribir tu propio texto para diferenciarte, pedirle a Google que revise el caso, o publicar una aclaración.

Cómo detectarlo en tu sitio

Tres comprobaciones que llevan diez minutos.

Dónde mirar, en orden

IndexaciónSearch ConsoleBuscá «Duplicada» entre los motivos de no indexación
TítulosRepetidos en volumenUno es un descuido; ciento veinte es una plantilla
site:Una búsquedaUna frase tuya entre comillas, con site: tu dominio
Las tres salen gratis y de fuentes que ya tenés.

El informe de indexación es el más directo: los motivos son explícitos y cada uno lleva a una acción distinta. Cómo leerlo está en la guía de Search Console.

La segunda —títulos repetidos en volumen— es la que descubre el caso 2 disfrazado de caso 1. Si ciento veinte páginas comparten título, no es un problema de canonical: es una plantilla que genera páginas sin contenido propio, y eso es SEO programático mal hecho.

El resumen

Si tenés que quedarte con una sola idea: el duplicado técnico casi nunca es el problema.

Se resuelve con una canonical y coherencia entre señales, y se resuelve rápido. El que cuesta caro es el otro: tres páginas mediocres sobre lo mismo, que no se arreglan con una etiqueta sino escribiendo una buena y redirigiendo las demás.

La documentación oficial sobre canonicalización, con las señales que Google tiene en cuenta y en qué orden, está en su guía de canónicas.

9 de 13

robots.txt: qué se puede y qué no se puede hacer con él

Controla el rastreo, no la indexación, y confundir las dos cosas deja páginas atrapadas en los resultados sin forma de sacarlas. Qué hace, qué no, y qué poner.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Esa distinción parece un tecnicismo y es el origen de casi todos los problemas que causa este archivo.

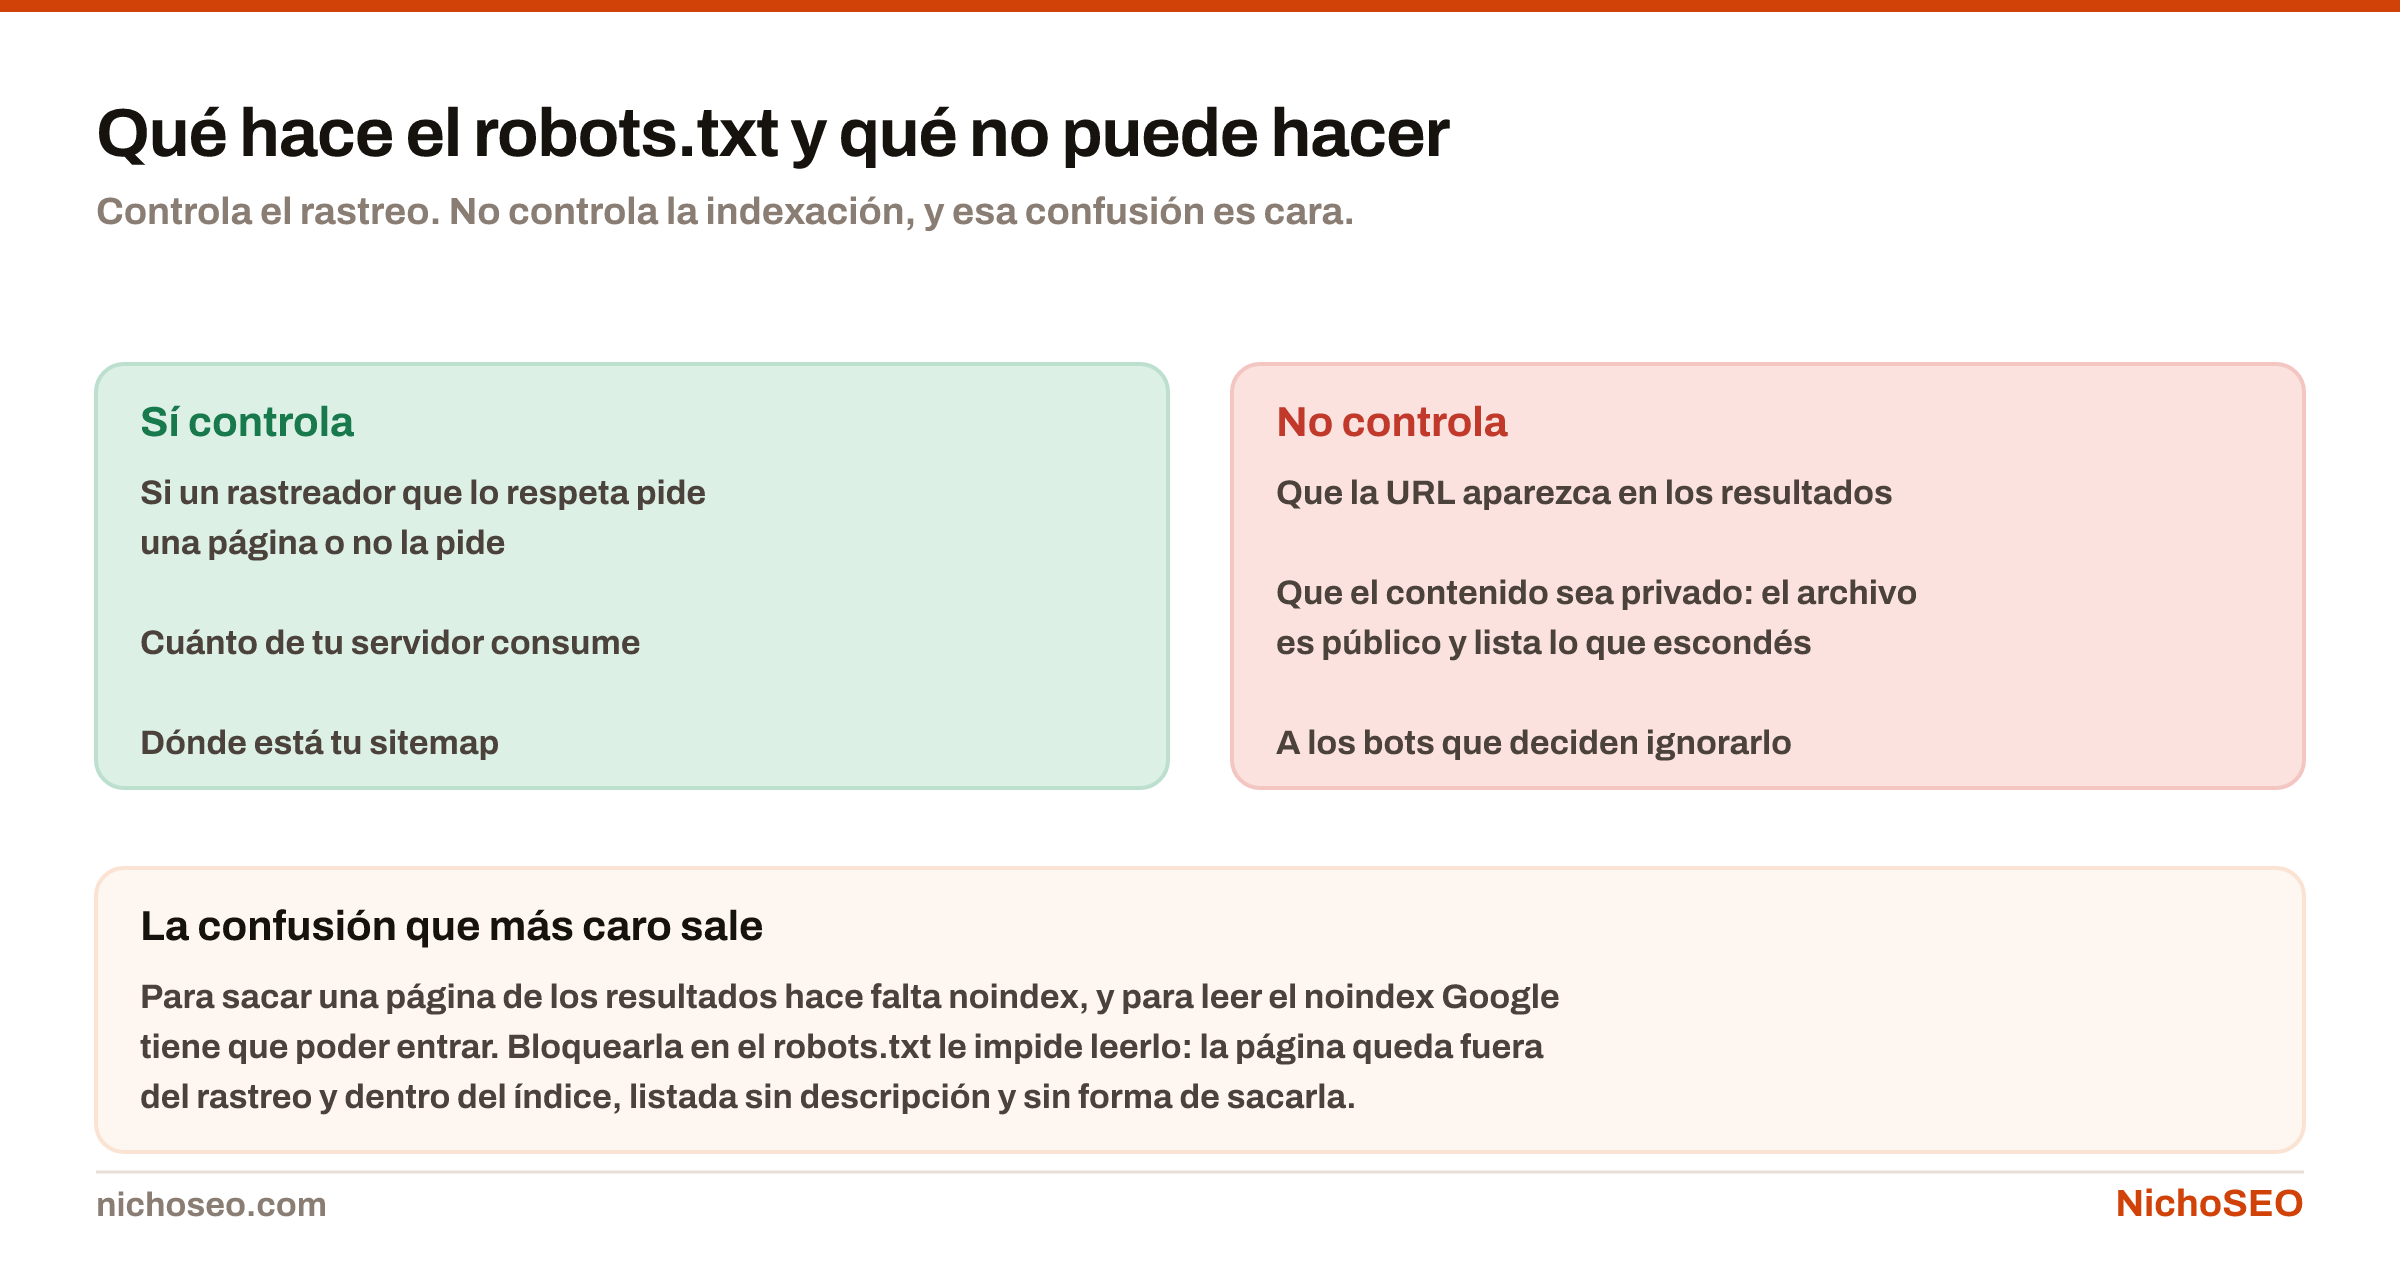
Qué hace y qué no

Qué controla el robots.txt —si un rastreador pide una página— frente a lo que no controla: que la URL aparezca en los resultados, la privacidad del contenido y el comportamiento de los bots que deciden ignorarlo.
Controla el rastreo. No controla la indexación, y esa confusión es cara.Descargar imagen

Las tres cosas de la derecha son las que más sorprenden, y conviene tomarlas de a una.

No saca páginas de los resultados. Una URL bloqueada puede seguir apareciendo si algún enlace apunta a ella. Google no puede leer su contenido, así que la muestra sin descripción, con un texto del tipo «No hay información disponible para esta página». Está en el índice y no se puede sacar, porque la instrucción que la sacaría está adentro de una página que Google no puede abrir.

No esconde nada. El archivo vive en tudominio.com/robots.txt y lo puede leer cualquiera. Escribir Disallow: /admin-secreto/ es publicar la dirección de lo que querías ocultar. Lo privado se protege con una contraseña, no con una convención.

No obliga a nadie. Es un acuerdo de buena fe. Los buscadores grandes lo respetan; un raspador que copia contenido, no. Si algo no puede leerse, no alcanza con pedirlo.

Lo que sí resuelve

Dos cosas, y las dos importan en sitios grandes.

Ahorrar rastreo donde no aporta. Un listado con veinte filtros combinables genera miles de URLs con el mismo contenido. Bloquear ese patrón evita que el rastreador gaste tiempo ahí en lugar de en tus páginas nuevas.

Declarar dónde está el sitemap. Una línea, y es la forma más simple de que cualquier buscador lo encuentre sin que se lo envíes. Qué incluir en él está en sitemap.xml.

Bloquear o desindexar: el árbol de decisión

Es la pregunta práctica, y tiene una respuesta corta.

Querés que no aparezca en los resultados

  • Poné noindex en la página
  • Dejala accesible al rastreador
  • Esperá a que la vuelva a visitar
  • Recién ahí, si querés, bloqueala

Querés que no la rastreen

  • Bloqueala en el robots.txt
  • Sirve para ahorrar rastreo, no para ocultar
  • Solo si no te importa que la URL siga listada
  • Nunca sobre una página que ya está indexada
Si hacés las dos cosas a la vez, el bloqueo gana y el noindex nunca se lee.

El orden de la izquierda es lo que casi nadie hace. Poner noindex y bloquear al mismo tiempo parece más seguro y es lo contrario: el bloqueo impide leer el noindex, así que la página queda listada para siempre.

El diagnóstico completo de una página que no se indexa —o que se indexa cuando no querías— está en cómo indexar una página.

El diagnóstico para una página que no se indexa: comprobar si está bloqueada, si devuelve 200, si tiene noindex, si el canonical apunta a otro lado y si hay contenido propio.
Cinco preguntas, siempre en este orden. La primera que dé «no» es tu problema.Descargar imagen

El archivo que sirve para casi cualquier sitio

Tres líneas y no hace falta más:

User-agent: *
Allow: /

Sitemap: https://tudominio.com/sitemap.xml

Eso es todo. Un sitio chico no gana nada bloqueando cosas, y cada línea de más es una oportunidad de bloquear sin querer algo que importaba.

Si tenés un panel de administración o un carrito, se agregan las rutas concretas:

User-agent: *
Allow: /
Disallow: /admin/
Disallow: /carrito/
Disallow: /*?filtro=

Sitemap: https://tudominio.com/sitemap.xml

Un detalle que se pasa por alto: las reglas se evalúan por especificidad, no por orden. Una Allow más específica gana sobre una Disallow más general, en todos los buscadores grandes.

Los rastreadores de IA son un caso aparte

Acá el archivo sí decide algo importante, y decide mal por omisión.

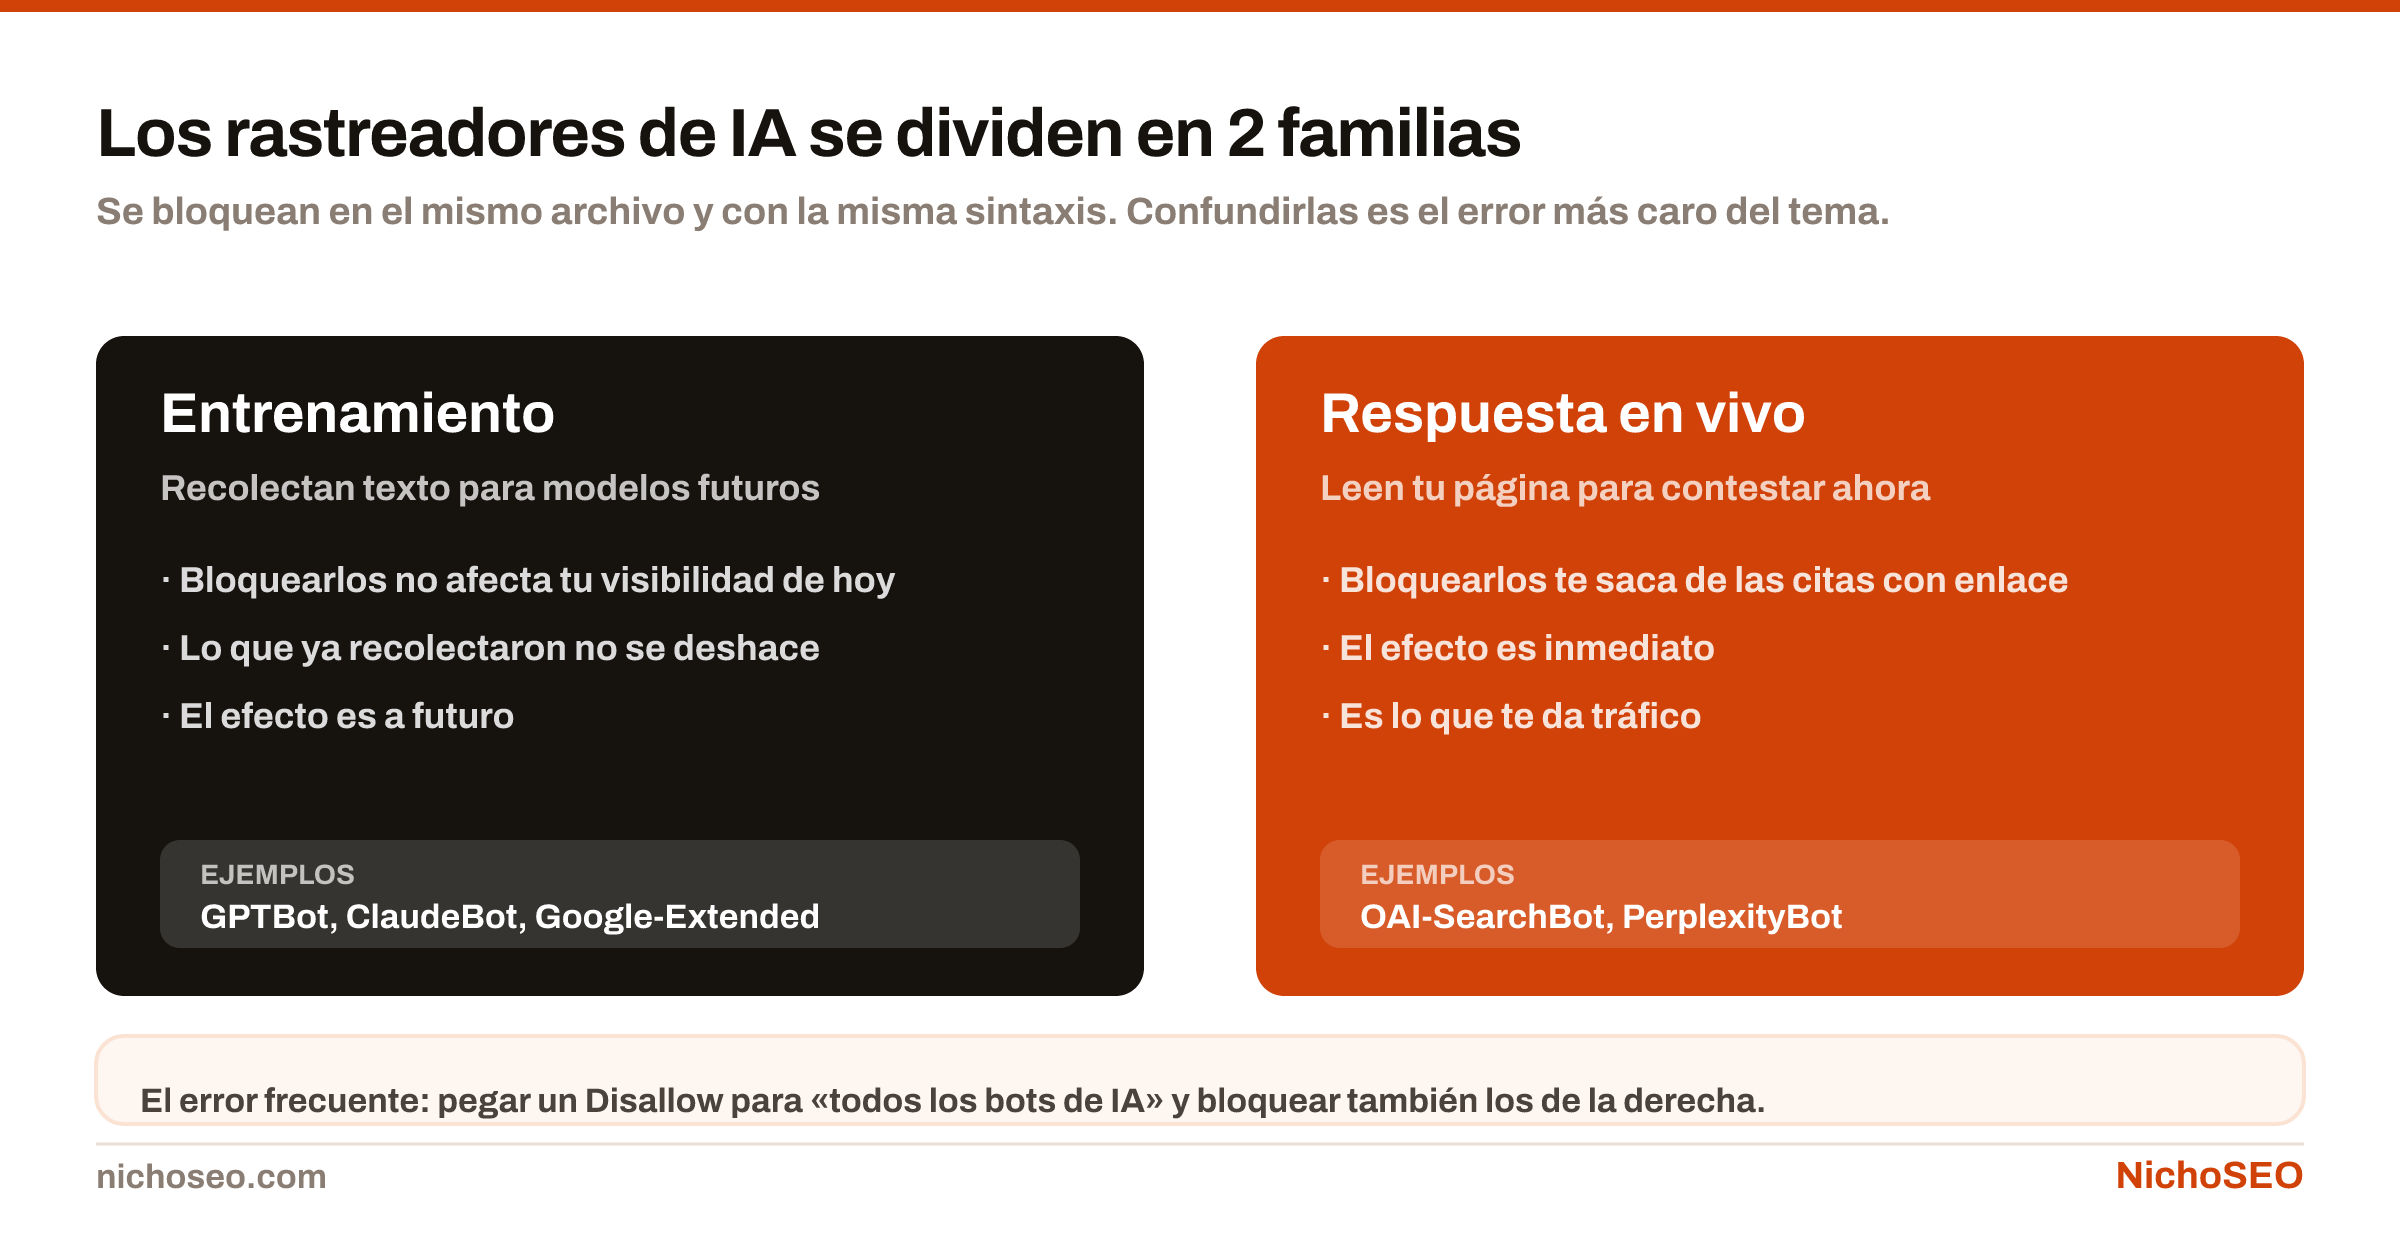
Los rastreadores de los motores generativos se controlan con este mismo archivo, pero no todos hacen lo mismo: unos se llevan texto para entrenar modelos futuros y otros leen tu página para responder una pregunta ahora.

Las dos familias de rastreadores de IA: los de entrenamiento, que recolectan texto para modelos futuros, y los de respuesta en vivo, que leen tu página para contestar ahora.
Se bloquean en el mismo archivo y con la misma sintaxis. Confundirlas es el error más caro del tema.Descargar imagen

Bloquear a todos por igual con una regla genérica es la decisión más cara que se puede tomar acá, porque los segundos son los que te citan. Qué conviene permitir a cada familia está en crawlers de IA.

Y hay una trampa adicional: Gemini no se controla desde acá. Usa el rastreador de Google, y el permiso es otra directiva. La diferencia está en ChatGPT vs Claude vs Gemini.

Cómo comprobar qué está pasando de verdad

El archivo declara una intención. Lo que pasó está en otro lado.

Tres comprobaciones, de la más barata a la más útil

30 sAbrir el archivotudominio.com/robots.txt, a ojo
2 minSearch ConsoleEl informe dice si una URL está bloqueada
5 minLos registrosQué bot entró de verdad y qué le respondiste
La tercera es la única que muestra lo que efectivamente ocurrió.

La tercera es la que descubre el problema que ninguna de las otras dos ve: un rastreador que el robots.txt permite y que el firewall rechaza igual. Cómo leer eso está en análisis de logs para SEO.

Los 4 errores más caros

  1. El Disallow: / del entorno de pruebas sale a producción. Es el clásico de toda migración, y tumba un sitio entero en días. La lista de comprobaciones del día del cambio está en migración SEO.
  2. Bloquear el CSS y el JavaScript. Google necesita esos archivos para ver la página como la ve una persona. Bloquearlos le da una versión rota.
  3. Bloquear para desindexar. Ya explicado arriba: hace exactamente lo contrario.
  4. Bloquear a todos los bots de IA con una regla genérica, sin distinguir entre los que entrenan y los que responden.

La especificación del protocolo, que desde 2022 es un estándar y no una convención suelta, está en el RFC 9309, y la documentación de Google sobre cómo interpreta el archivo, en su guía de robots.txt.

10 de 13

JavaScript SEO: cuando el contenido lo arma el navegador

Google procesa una página con JavaScript en dos pasadas, y la segunda no tiene plazo. Cómo comprobar qué ve en la primera.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Todo el tema se resume en qué dejás para cada pasada.

Las dos pasadas

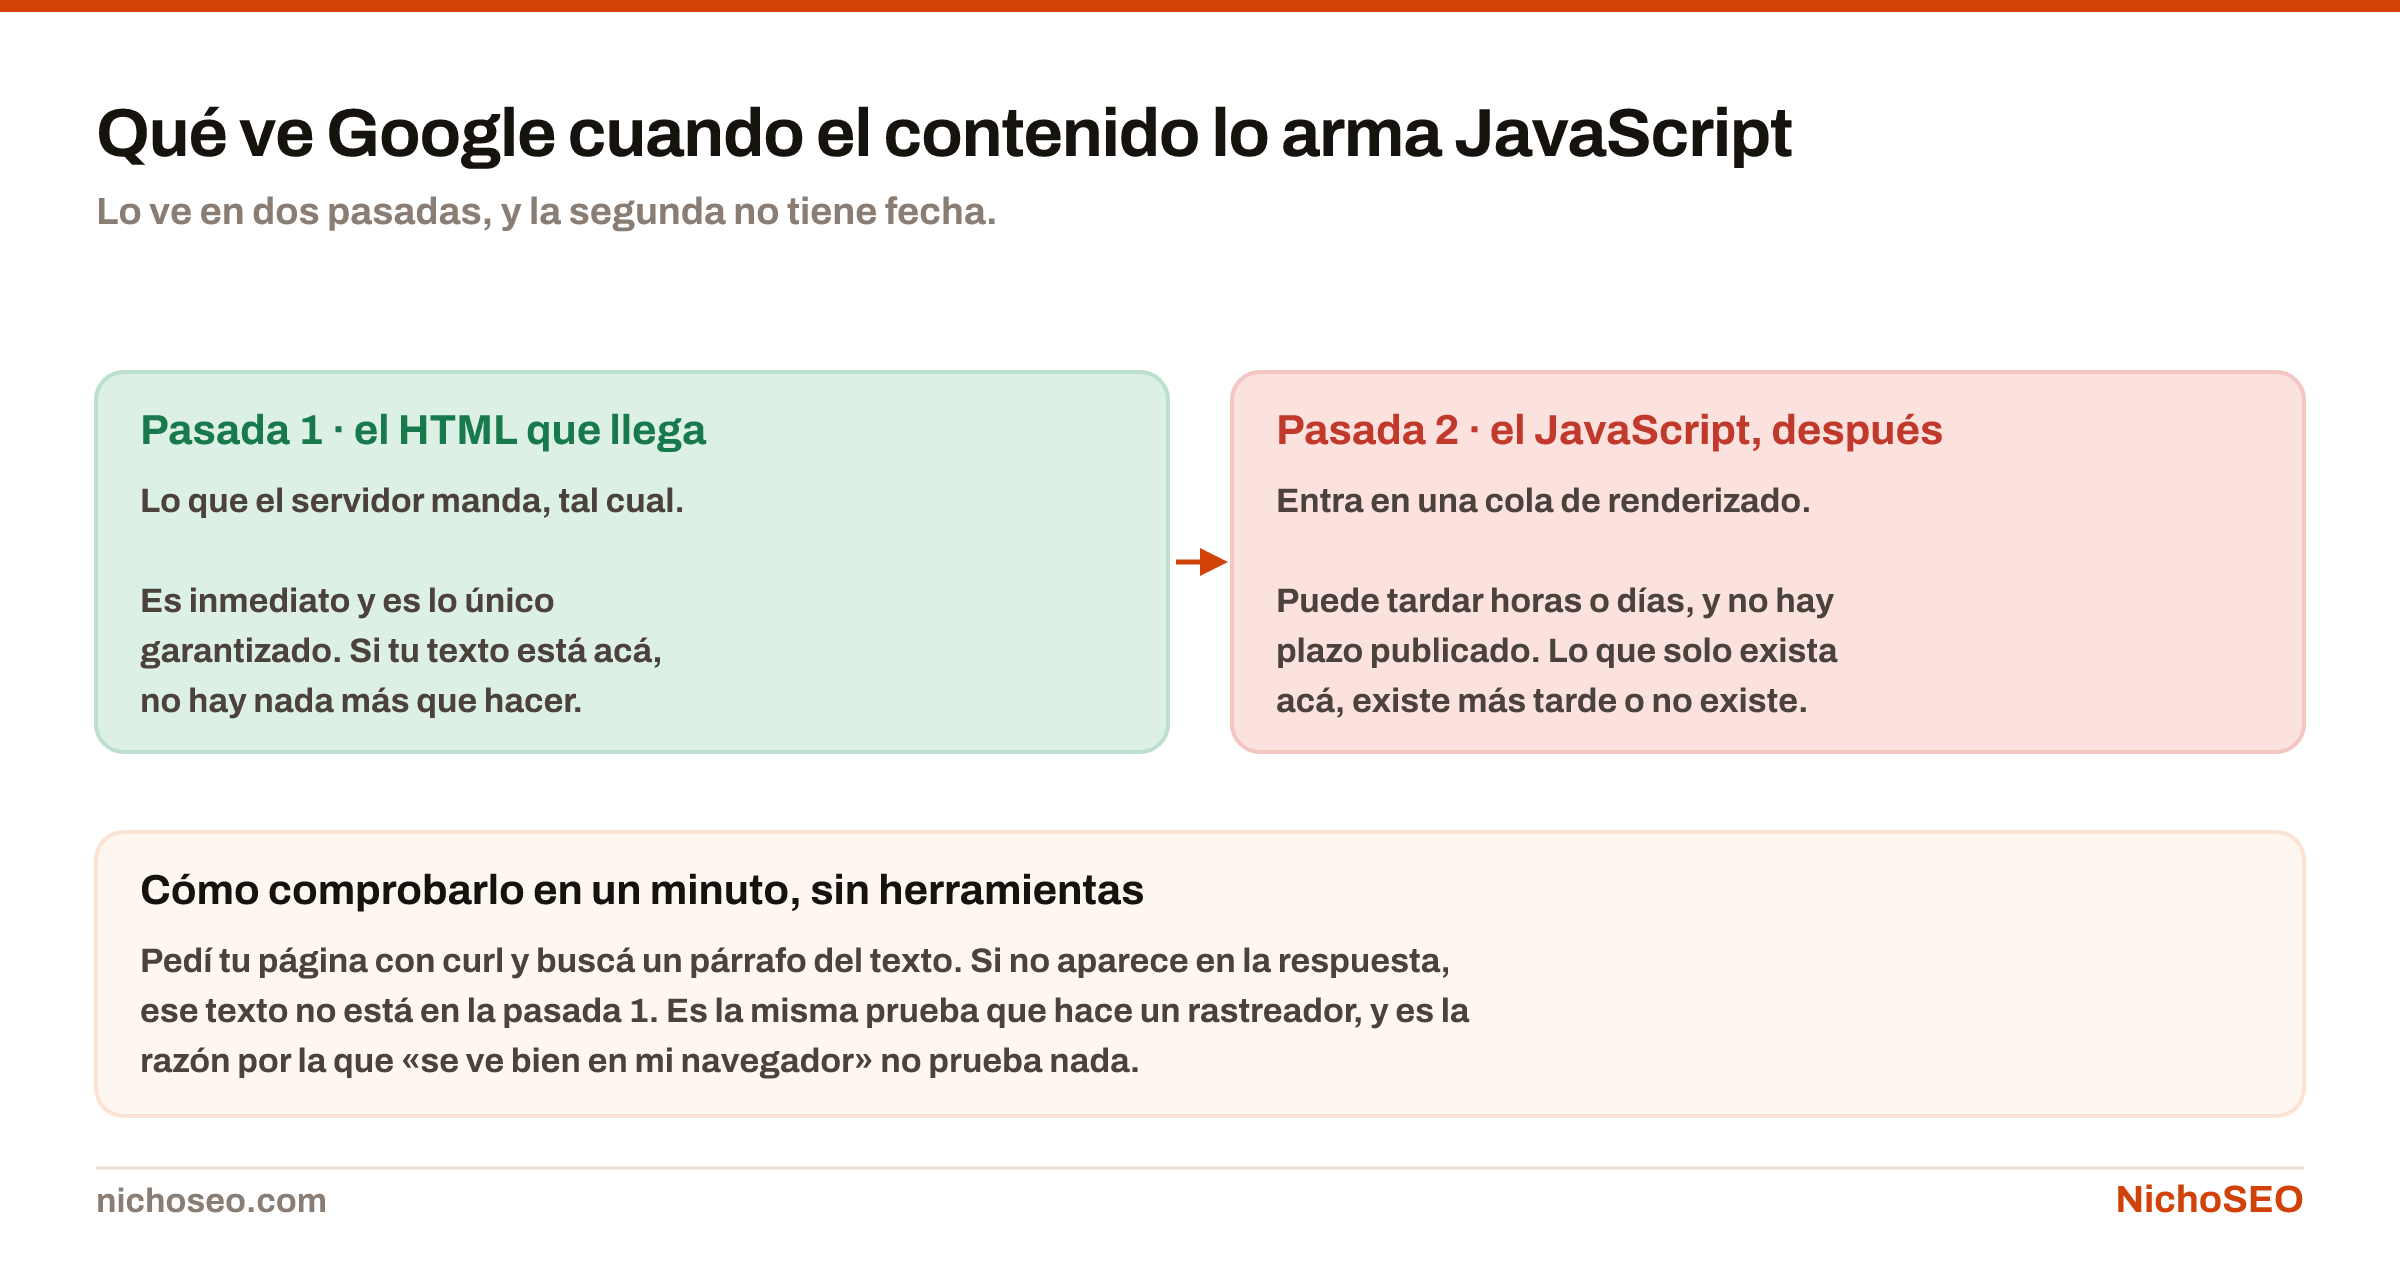
Las dos pasadas con las que Google procesa una página con JavaScript: primero lee el HTML inicial, y más tarde ejecuta el JavaScript en una cola sin plazo garantizado.
Lo ve en dos pasadas, y la segunda no tiene fecha.Descargar imagen

La primera es inmediata y es lo único seguro: el HTML que devuelve tu servidor, tal como llega.

La segunda entra en una cola. Google ejecuta el JavaScript cuando tiene capacidad, y eso puede ser en minutos o en días. No hay un plazo publicado, y depende de cuánta prioridad le dé a tu sitio.

La consecuencia práctica: lo que solo exista después de ejecutar JavaScript, existe más tarde o no existe. Para una página que cambia de precio todos los días, «más tarde» puede equivaler a nunca.

Esto encaja con las cuatro condiciones que tiene que cumplir una página, y es la segunda:

Las cuatro condiciones del SEO técnico en cadena: rastrear, renderizar, indexar y cargar rápido. Las tres primeras son de sí o no; la cuarta es de grado.
Cada una depende de la anterior. Si falla una, las siguientes no importan.Descargar imagen

Cómo comprobar qué ve la primera pasada

Un minuto y sin instalar nada:

curl -s https://tudominio.com/tu-pagina/ | grep -c "una frase de tu texto"

Si devuelve 0, esa frase no está en el HTML inicial. Es exactamente lo que ve un rastreador en la primera pasada.

Vale la pena insistir en por qué esto no se puede probar en el navegador: tu navegador siempre ejecuta el JavaScript. Ver la página bien en pantalla no dice nada sobre la primera pasada. Ni siquiera «ver código fuente» alcanza en todos los casos.

Pruebas que dicen algo

  • curl y buscar el texto en la respuesta
  • Desactivar JavaScript en el navegador y recargar
  • La herramienta de inspección de URL de Search Console
  • Comparar el HTML inicial con lo que ves en pantalla

Pruebas que no

  • «Se ve bien cuando entro»
  • Inspeccionar elementos, que muestra el DOM ya construido
  • Que la página esté indexada, que puede ser de la pasada 2
  • Preguntarle al desarrollador si «está bien hecho»
La diferencia entre las dos columnas es si la prueba ejecuta JavaScript o no.

La herramienta de inspección de URL de Search Console muestra las dos cosas —el HTML que recibió y el resultado renderizado—, y es la comprobación más completa que hay gratis. Dónde está y qué más informa está en la guía de Search Console.

Qué conviene que esté en la primera pasada

No hace falta renunciar a JavaScript. Hace falta elegir qué va en cada pasada.

Qué no conviene dejar para la segunda

El textoprincipalSi no está, la página está vacía para el buscador
Los enlacesinternosSin ellos no hay forma de descubrir el resto
Title y canonicaldel <head>Cambiarlos por JavaScript es apostar a la pasada 2
Lo secundariopuede esperarComentarios, recomendados, widgets
La regla: lo que define de qué habla la página, en la primera pasada.

Los enlaces merecen un párrafo, porque es el error más silencioso. Un menú que se arma con JavaScript y no deja etiquetas <a href> en el HTML inicial significa que, en la primera pasada, tu sitio es una sola página sin salidas.

Y hay una variante peor: los enlaces hechos con onclick sobre un <div>. Esos no son enlaces para nadie, ni en la primera pasada ni en la segunda.

Las tres formas de resolverlo

Ordenadas por lo que cuestan.

Renderizado en el servidor. El servidor arma el HTML completo y lo manda listo. Es la solución que elimina el problema: no hay segunda pasada que esperar. Cualquier marco moderno lo ofrece.

Generación estática. Las páginas se compilan una vez, al publicar, y quedan como archivos. Es lo mismo pero más barato de servir, y sirve cuando el contenido no cambia por visitante.

Renderizado dinámico. Detectar al rastreador y mandarle una versión ya armada. Funciona, es más frágil de mantener y Google lo desaconseja como solución permanente.

Lo que no es solución: pedirle a Google que sea más rápido, o suponer que ya lo resolvió porque la página aparece indexada. Que aparezca puede ser resultado de la pasada 2, con el retraso incluido.

Los 5 síntomas de que hay un problema de JavaScript

Sin mirar código, estos son los que se ven desde afuera:

  1. Search Console indexa la página pero no recibe impresiones para el contenido que sí está en pantalla.
  2. El informe de indexación dice «Rastreada, no indexada por ahora» en páginas que tienen contenido bueno.
  3. Las páginas nuevas tardan semanas en aparecer, cuando las viejas aparecían en días.
  4. Search Console lista menos páginas de las que existen, porque no encontró los enlaces.
  5. El title que aparece en los resultados no es el que pusiste, porque el que pusiste se asigna por JavaScript.

El primero y el quinto son los más claros. Para el quinto sirve comparar: lo que Google muestra, contra lo que debería mostrar según el simulador de SERP. Si no se parecen, el title no llegó. El segundo puede tener otras causas, y el diagnóstico completo está en cómo indexar una página.

Qué pasa con los motores de IA

Peor que con Google, y conviene saberlo.

Los rastreadores de los motores generativos, en general, no ejecutan JavaScript. Leen el HTML que llega y con eso trabajan. No hay segunda pasada.

Eso convierte lo que con Google es un retraso en una ausencia total: si tu texto solo existe después de ejecutar JavaScript, para esos sistemas tu página está vacía.

Es una de las comprobaciones de la auditoría de GEO por ese motivo: está en la auditoría de GEO.

Los seis errores de SEO técnico más frecuentes, agrupados según qué condición rompen: rastreo, renderizado o indexación.
Cada uno rompe una de las cuatro condiciones. Ese es el orden en que conviene buscarlos.Descargar imagen

El resumen práctico

Una regla que resuelve el 90 % de los casos: si lo pedís con curl y el texto no aparece, hay trabajo.

No significa reescribir el sitio. Significa mover el contenido principal, los enlaces y las etiquetas del <head> a la primera pasada, y dejar en la segunda lo que puede esperar.

La documentación de Google sobre cómo procesa JavaScript, con el detalle de las dos fases, está en su guía de JavaScript SEO.

11 de 13

Paginación SEO: listados largos sin romper la indexación

Un rastreador sigue enlaces: no hace clic ni baja la página. De ahí sale todo lo que hay que decidir sobre listados, scroll infinito y botones de «cargar más».

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Todo se deduce de un hecho: un rastreador sigue enlaces, no hace clic ni baja la página.

Los 3 patrones, y qué le pasa a cada uno

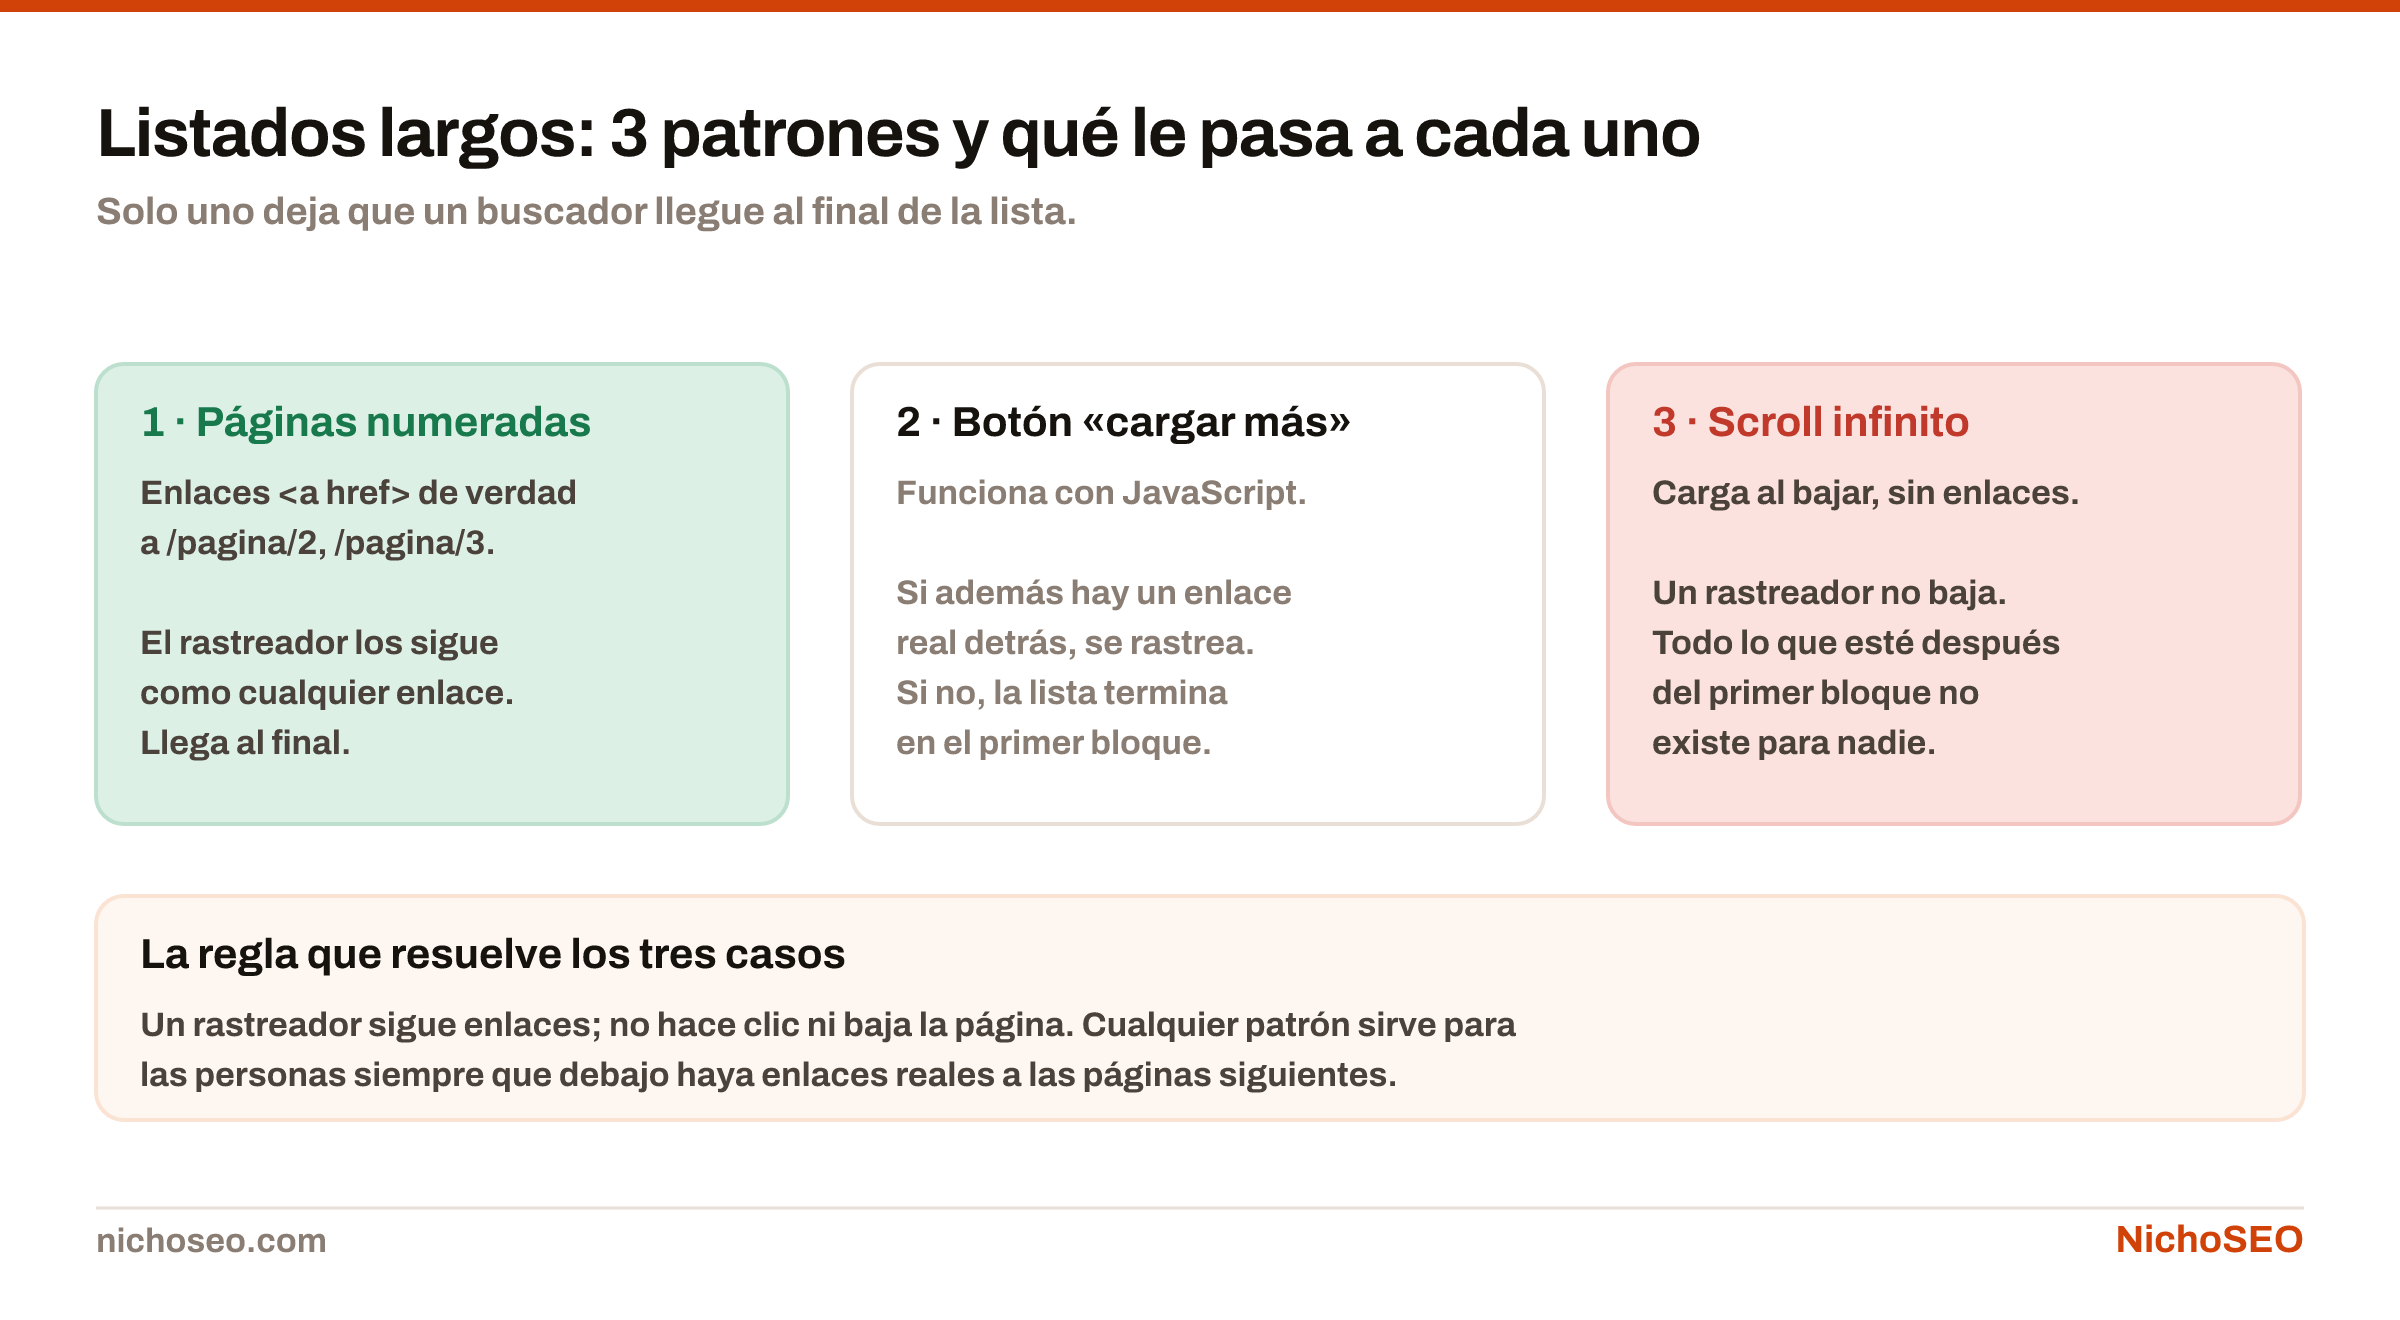
Los tres patrones para listados largos: páginas numeradas con enlaces reales, cargar más con un botón, y scroll infinito. Solo el primero permite que un rastreador llegue a todos los elementos.
Solo uno deja que un buscador llegue al final de la lista.Descargar imagen

El tercero es el que más se elige por diseño y el que más contenido esconde. Un catálogo de mil productos con scroll infinito y sin enlaces reales es, para un buscador, un catálogo de veinte.

El segundo depende de cómo esté hecho: un botón que carga más con JavaScript puede estar bien, si debajo hay un enlace real a /pagina/2 que el botón intercepta. Si el botón es un <div> con un onclick, no hay nada que seguir.

La forma de comprobarlo no requiere abrir el código: cómo ver qué queda en el HTML inicial está en JavaScript SEO.

Lo que ya no se usa

Conviene decirlo porque sigue apareciendo en guías viejas: rel="next" y rel="prev" ya no sirven.

Google anunció que dejó de tenerlas en cuenta y que trata cada página del listado como una página independiente. Si las tenés puestas no hacen daño; si estás por ponerlas, no hace falta.

Lo que sí sigue importando es más básico: que haya enlaces <a href> de verdad entre las páginas.

Qué hacer con la canonical

Es el error más frecuente de la paginación y el más caro.

Cada página se declara a sí misma

  • /blog/pagina/3/ tiene canonical a /blog/pagina/3/
  • Google indexa cada página del listado
  • Los elementos de la página 3 se descubren
  • Cada una compite por lo suyo, que suele ser poco

Todas apuntan a la primera

  • /blog/pagina/3/ tiene canonical a /blog/
  • Google trata la 3 como duplicado de la 1
  • Deja de rastrearla, y con ella los elementos que lista
  • Se pierde el camino hacia lo que está al fondo
La canonical hacia la primera página es la forma más silenciosa de esconder medio catálogo.

La lógica de por qué la columna derecha falla: si Google considera la página 3 un duplicado, deja de visitarla. Y si deja de visitarla, no ve los enlaces que contiene. Todo lo que solo estaba enlazado desde ahí se vuelve huérfano.

El caso general —cuándo una canonical resuelve y cuándo esconde— está en contenido duplicado.

La página «ver todo»

Es una alternativa razonable cuando el listado es moderado.

Una sola página con los cien elementos, con canonical desde las paginadas hacia ella. Concentra las señales y le da a Google un solo lugar donde encontrar todo.

Deja de servir cuando la lista es grande: una página con mil productos pesa demasiado y tarda demasiado, y el remedio sale más caro que la enfermedad. Los umbrales de carga están en Core Web Vitals.

La regla práctica: hasta unos cien elementos, «ver todo» suele convenir. Por encima, paginación numerada.

Cómo afecta a la profundidad

Este es el costo real de la paginación y el que menos se mira.

La profundidad de clic de un sitio: las páginas a uno o dos saltos de la home se rastrean bien, las que están a cinco o más casi no se visitan.
Contá desde la home. Lo que está a más de tres o cuatro saltos casi no se rastrea ni se visita.Descargar imagen

Si un listado tiene cuarenta páginas y solo enlazás «siguiente», el elemento de la página cuarenta está a cuarenta clics de la portada. Google llega tarde, con poca frecuencia, y le asigna poca importancia.

Tres formas de acortar eso:

  1. Enlazar números, no solo «siguiente». Mostrar 1, 2, 3 … 18, 19, 20 pone el final a dos clics en lugar de a veinte.
  2. Partir por categorías antes que por números. Veinte páginas de «todo» rinden peor que cinco categorías de cuatro páginas cada una, y además son páginas que alguien busca.
  3. Enlazar los elementos importantes desde otro lado. Si un producto importa, no lo dejes colgando solo de la página 12 del listado.

La lógica completa de cómo se reparte la autoridad por los enlaces está en enlazado interno, y cómo agrupar por tema en vez de por formato, en arquitectura web.

Qué poner en el sitemap

No las páginas del listado: los elementos.

Qué va y qué no

SíLos elementosCada producto, cada artículo, con su URL
SíLa página 1Es una página que alguien puede buscar
NoLas páginas 2 en adelanteNadie las busca y no aportan al descubrimiento
El sitemap es la lista de lo que querés que se indexe, no un mapa de la navegación.
Qué incluir en un sitemap XML —páginas indexables, canónicas y que devuelven 200— y qué dejar afuera: redirecciones, noindex, paginados y URLs con parámetros.
En un listado, lo que va al sitemap son los elementos. Las páginas 2 en adelante no las busca nadie.Descargar imagen

El detalle de qué incluir y qué dejar afuera está en sitemap.xml.

Cómo comprobar que un listado se rastrea entero

Dos comprobaciones concretas:

Con curl, mirá si hay enlaces reales. Pedí la primera página del listado y buscá href apuntando a la segunda. Si no aparece, el rastreador tampoco la ve.

En Search Console, contá. Si el catálogo tiene 800 productos y el informe de indexación lista 120, el camino se corta en alguna parte. El diagnóstico está en cómo indexar una página.

En catálogos grandes esto no se comprueba a mano: a partir de cuántas páginas se justifica una herramienta de rastreo está medido en herramientas de rastreo.

El resumen

Podés usar el patrón que quieras para las personas —scroll infinito incluido— siempre que debajo haya enlaces reales a las páginas siguientes.

Y una regla que evita el error más caro: cada página del listado lleva su propia canonical. Apuntarlas todas a la primera es la forma más silenciosa de esconder medio catálogo.

El anuncio de Google sobre rel=next y rel=prev, que sigue siendo la referencia para lo que dejó de usarse, está en su documentación de paginación.

12 de 13

Optimizar imágenes para la web: peso y formato

Las imágenes son casi siempre lo más pesado de una página. Las cuatro decisiones que deciden cuánto pesan, ordenadas por cuánto ahorra cada una.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Y a diferencia de otras optimizaciones, esta se nota: es de las pocas cosas que mejoran la experiencia y el SEO por el mismo motivo.

Las 4 decisiones, por cuánto ahorran

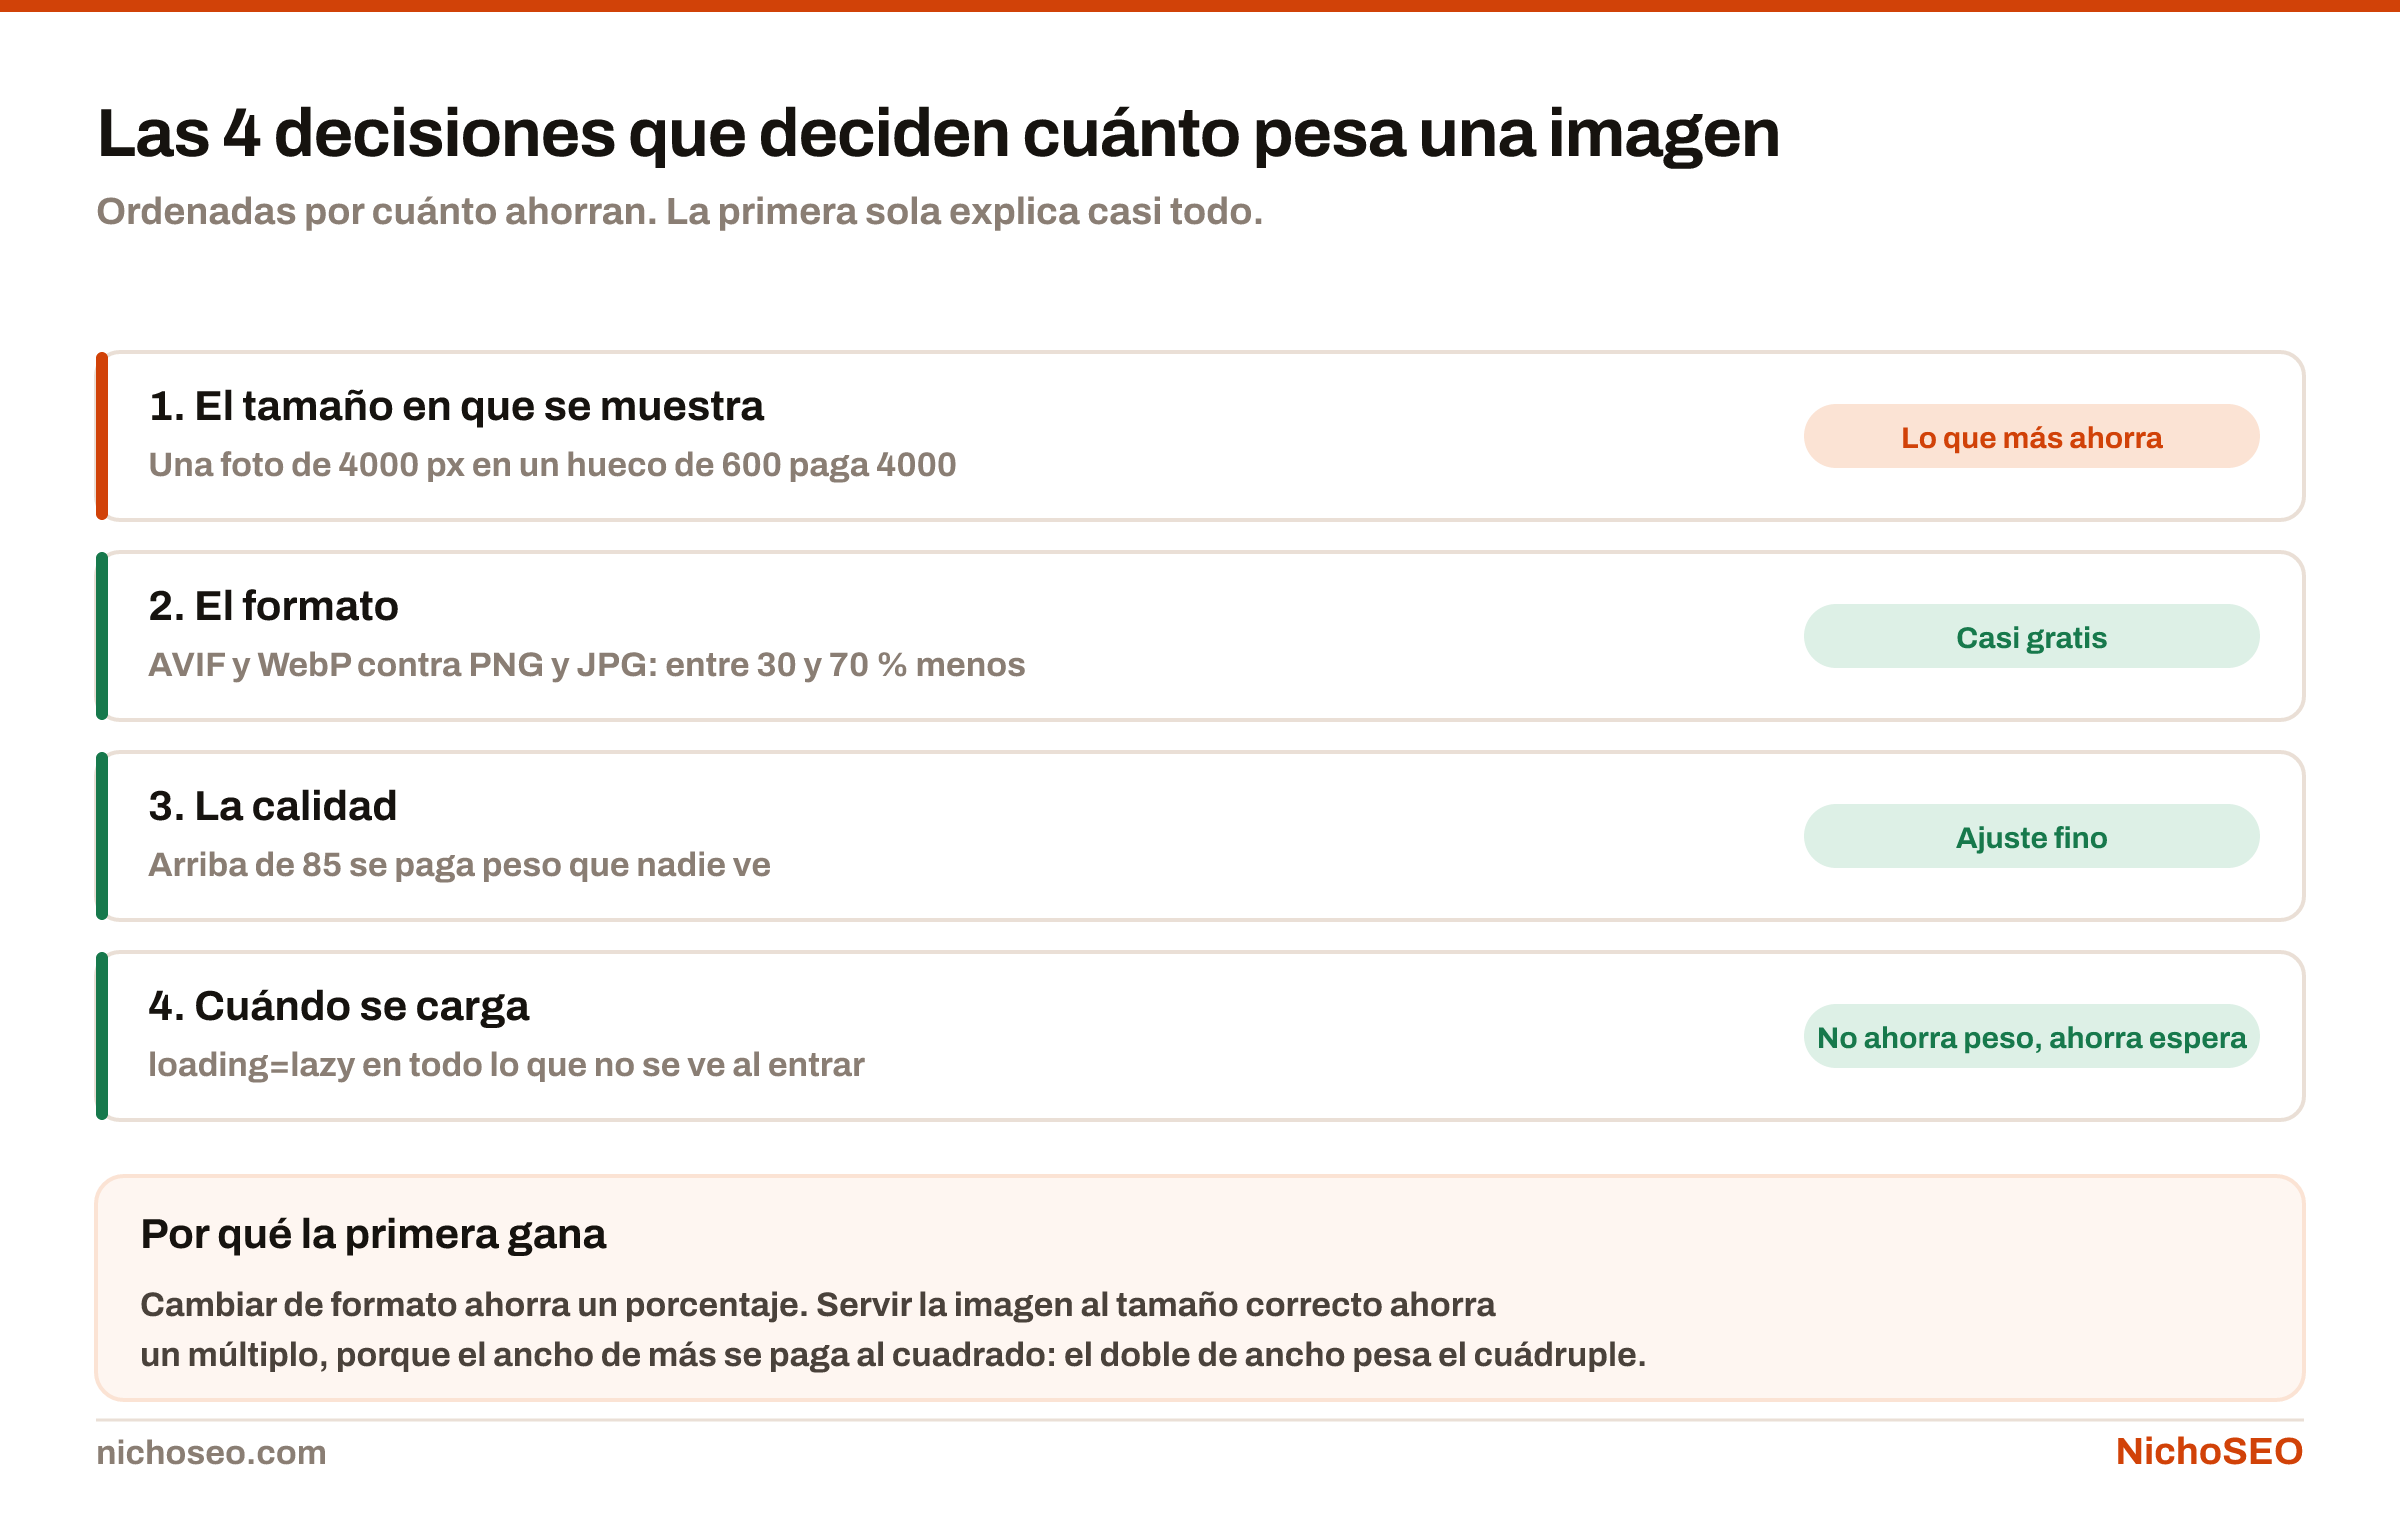
Las cuatro decisiones que determinan el peso de una imagen en una web: servirla al tamaño en que se muestra, elegir el formato correcto, ajustar la calidad y diferir la carga de lo que está fuera de pantalla.
Ordenadas por cuánto ahorran. La primera sola explica casi todo.Descargar imagen

La primera explica casi todo, y es la que menos se hace.

1. El tamaño: el ancho de más se paga al cuadrado

Una foto de 4000 px de ancho mostrada en un hueco de 600 px no pesa un poco de más: pesa muchísimo de más, porque el área crece con el cuadrado del ancho.

La misma foto, a distintos anchos

4000 pxSin tocarLo que sale de una cámara o de un banco de imágenes
1200 pxAl doble del huecoSuficiente para pantallas densas
×11La diferenciaAproximada, porque depende del contenido de la foto
La relación es cuadrática: al triple de ancho, alrededor de nueve veces el peso.

La regla práctica: el doble del ancho en que se muestra. Ese doble cubre las pantallas densas y no se nota la diferencia con un archivo más grande.

Para huecos que cambian de ancho según el dispositivo, srcset deja que el navegador elija. Vale la pena solo cuando la diferencia entre el móvil y el escritorio es grande.

2. El formato: cuál para qué

No hay un formato mejor: hay uno mejor para cada tipo de contenido.

Qué usar

  • AVIF para todo, con WebP de respaldo
  • SVG para logos, íconos y diagramas de líneas
  • PNG solo cuando hace falta transparencia sin pérdida
  • Un <picture> con varias fuentes si necesitás respaldo

Qué evitar

  • PNG para fotografías: es el peor caso posible
  • JPG para capturas de pantalla con texto: lo emborrona
  • GIF para animaciones: un video pesa mucho menos
  • Un formato único para todo el sitio
La primera fila de la derecha es la más común y la más cara.

Los dos casos extremos que más se equivocan:

PNG para fotos. El PNG guarda cada píxel exacto. En una fotografía eso significa guardar el ruido del sensor, que no aporta nada visible y pesa mucho.

JPG para capturas con texto. El JPG comprime suavizando, y el texto suavizado se ve sucio. Para capturas de pantalla conviene PNG, WebP o AVIF.

Los dibujos de colores planos —diagramas, esquemas, gráficos— son el caso donde el cambio de formato rinde más: el mismo archivo puede pesar un tercio en AVIF.

3. La calidad: dónde está el punto de no retorno

Por encima de 85 se paga peso que casi nadie ve.

Un valor entre 75 y 85 suele ser indistinguible del original a simple vista y pesa entre un tercio y la mitad. Para AVIF los números son otros: alrededor de 60 ya da un resultado muy bueno.

Lo importante es no comprimir dos veces. Guardar un JPG al 80, abrirlo y volver a guardarlo al 80 no da 80: da 64, y se nota.

4. Cuándo se carga

loading="lazy" no reduce el peso total: reduce lo que hay que esperar para ver la primera pantalla, que es lo que la persona percibe y lo que mide el LCP.

Los tres umbrales de Core Web Vitals: LCP bueno hasta 2,5 segundos, INP bueno hasta 200 milisegundos y CLS bueno hasta 0,1, con sus tramos a mejorar y malo.
Se miden con visitas reales y hay que cumplirlos para 3 de cada 4 personas.Descargar imagen

Dos reglas que se contradicen y hay que respetar las dos:

A lo que no se ve al entrar, loading="lazy". Todo lo que está más abajo.

A la imagen principal, nunca. Si la imagen grande de arriba se carga de forma diferida, el LCP empeora en lugar de mejorar. Esa lleva loading="eager" y, si se puede, fetchpriority="high".

El error clásico es poner lazy en todas de una sola vez, incluida la de arriba. Empeora justamente la métrica que se quería mejorar.

El detalle que casi nadie pone: las medidas

Toda imagen necesita width y height en el HTML, aunque el CSS después la redimensione.

Sin eso, el navegador no sabe cuánto espacio reservar: pinta el texto, llega la imagen y todo salta hacia abajo. Eso es CLS, y es una de las tres métricas de Core Web Vitals.

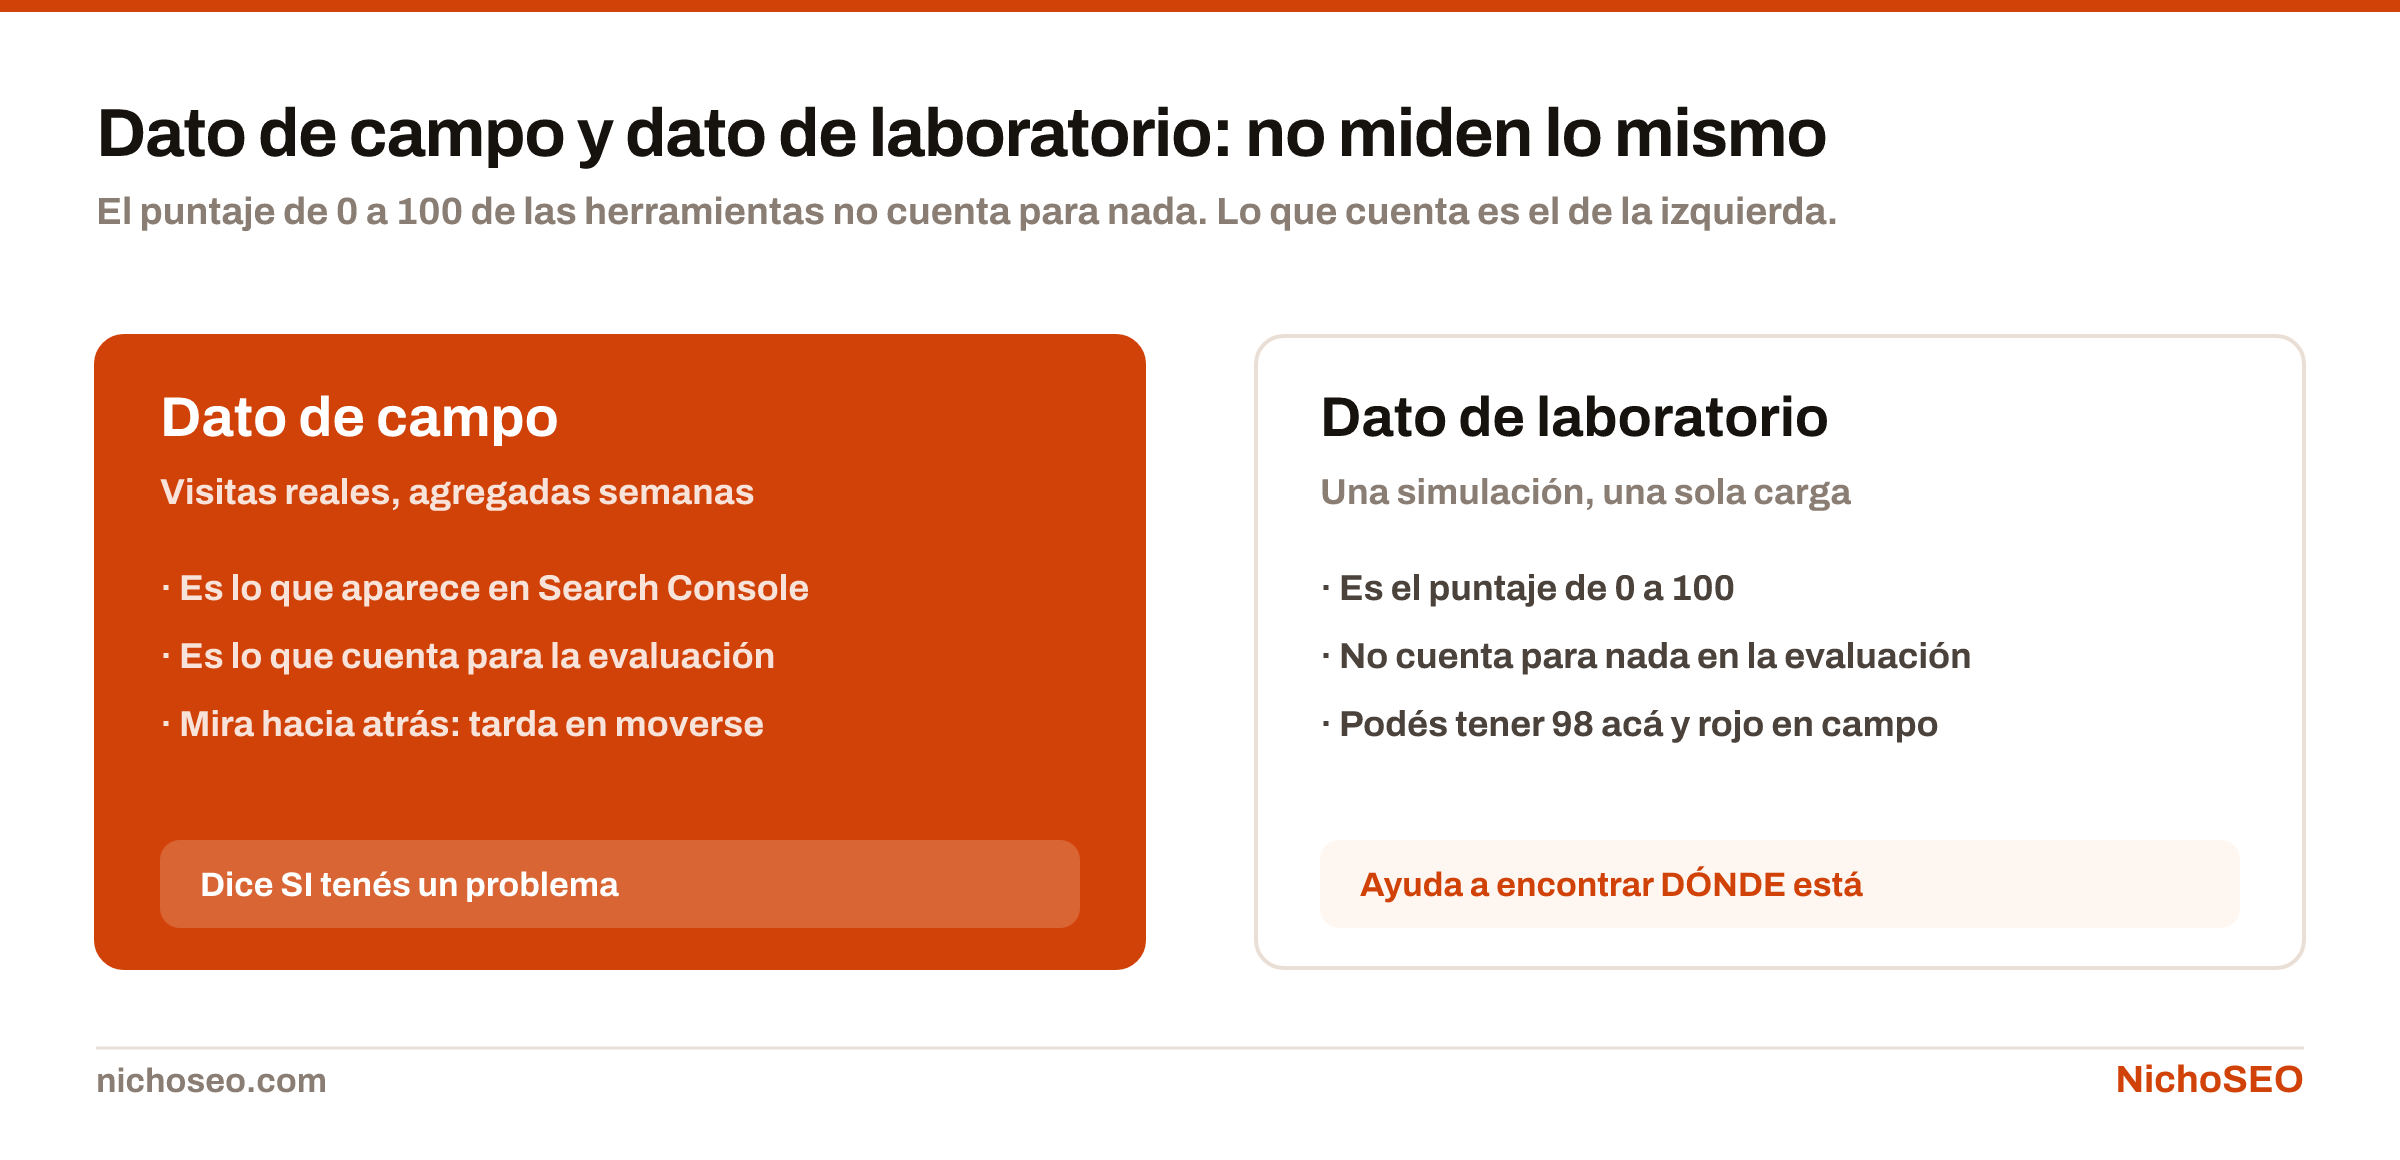
Diferencia entre el dato de campo de Core Web Vitals, que sale de visitas reales y es el que cuenta, y el dato de laboratorio, que es una simulación útil solo para diagnosticar.
El puntaje de 0 a 100 de las herramientas no cuenta para nada. Lo que cuenta es el de la izquierda.Descargar imagen

Es un arreglo de dos atributos que mejora una métrica entera, y es de los pocos casos en que la relación entre esfuerzo y resultado es tan clara.

El texto alternativo no es opcional

Va aparte porque no tiene que ver con el peso, pero se decide en el mismo momento.

El alt es lo que lee alguien con un lector de pantalla y lo único que un buscador puede entender de la imagen. Tiene que decir qué muestra, no que hay una imagen.

Mal: alt="gráfico". Bien: alt="Los seis rastreadores de IA más frecuentes, con de quién es cada uno".

Una excepción legítima: cuando la imagen es decorativa y lo que dice ya está en el texto de al lado, el alt vacío es lo correcto. Repetir el nombre que está escrito dos centímetros más arriba no le sirve a nadie.

Qué lee un modelo de una imagen, y por qué un dato dibujado adentro no se puede citar, está en GEO multimodal.

Cómo comprobar en qué estás

Dos herramientas gratis y ningún costo:

PageSpeed Insights lista las imágenes con problema, una por una, y dice cuánto ahorraría cada arreglo. Empieza siempre por «servir imágenes con el tamaño adecuado», que es la decisión 1.

El panel de red del navegador, ordenando por tamaño. La imagen más pesada de tu portada suele ser una sorpresa.

Mide la velocidad de una página con datos de usuarios reales y con una simulación de laboratorio.

Para qué se usa

  • Ver tus Core Web Vitals de campo, que son los que cuentan
  • Encontrar qué está frenando la carga, con el dato de laboratorio
  • Comparar una plantilla contra otra antes de cambiar nada

Los umbrales concretos y la diferencia entre lo que mide una prueba de laboratorio y lo que miden las visitas reales están en Core Web Vitals.

El orden para arreglarlo

  1. Achicá las que están fuera de tamaño. Es el 80 % del ahorro y no requiere cambiar nada del código.
  2. Pasá a AVIF con respaldo WebP. Si tu plataforma lo hace sola, ya está.
  3. Poné width y height en todas. Dos atributos, una métrica.
  4. lazy a todo menos a la de arriba.

Los tres primeros se hacen una vez y quedan. El cuarto es una regla para cuando publiques.

La guía oficial de Google sobre imágenes, que incluye los criterios de nombres de archivo y de texto alternativo, está en su documentación de imágenes.

13 de 13

Análisis de logs para SEO: qué ve el servidor

El registro del servidor guarda cada visita de cada bot, incluidos los de IA. Qué ves ahí que no ves en ningún panel, cómo leerlo y qué buscar primero.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Es la fuente de datos menos glamorosa del oficio y la única que no está filtrada por nadie.

Qué ves ahí que no ves en Search Console

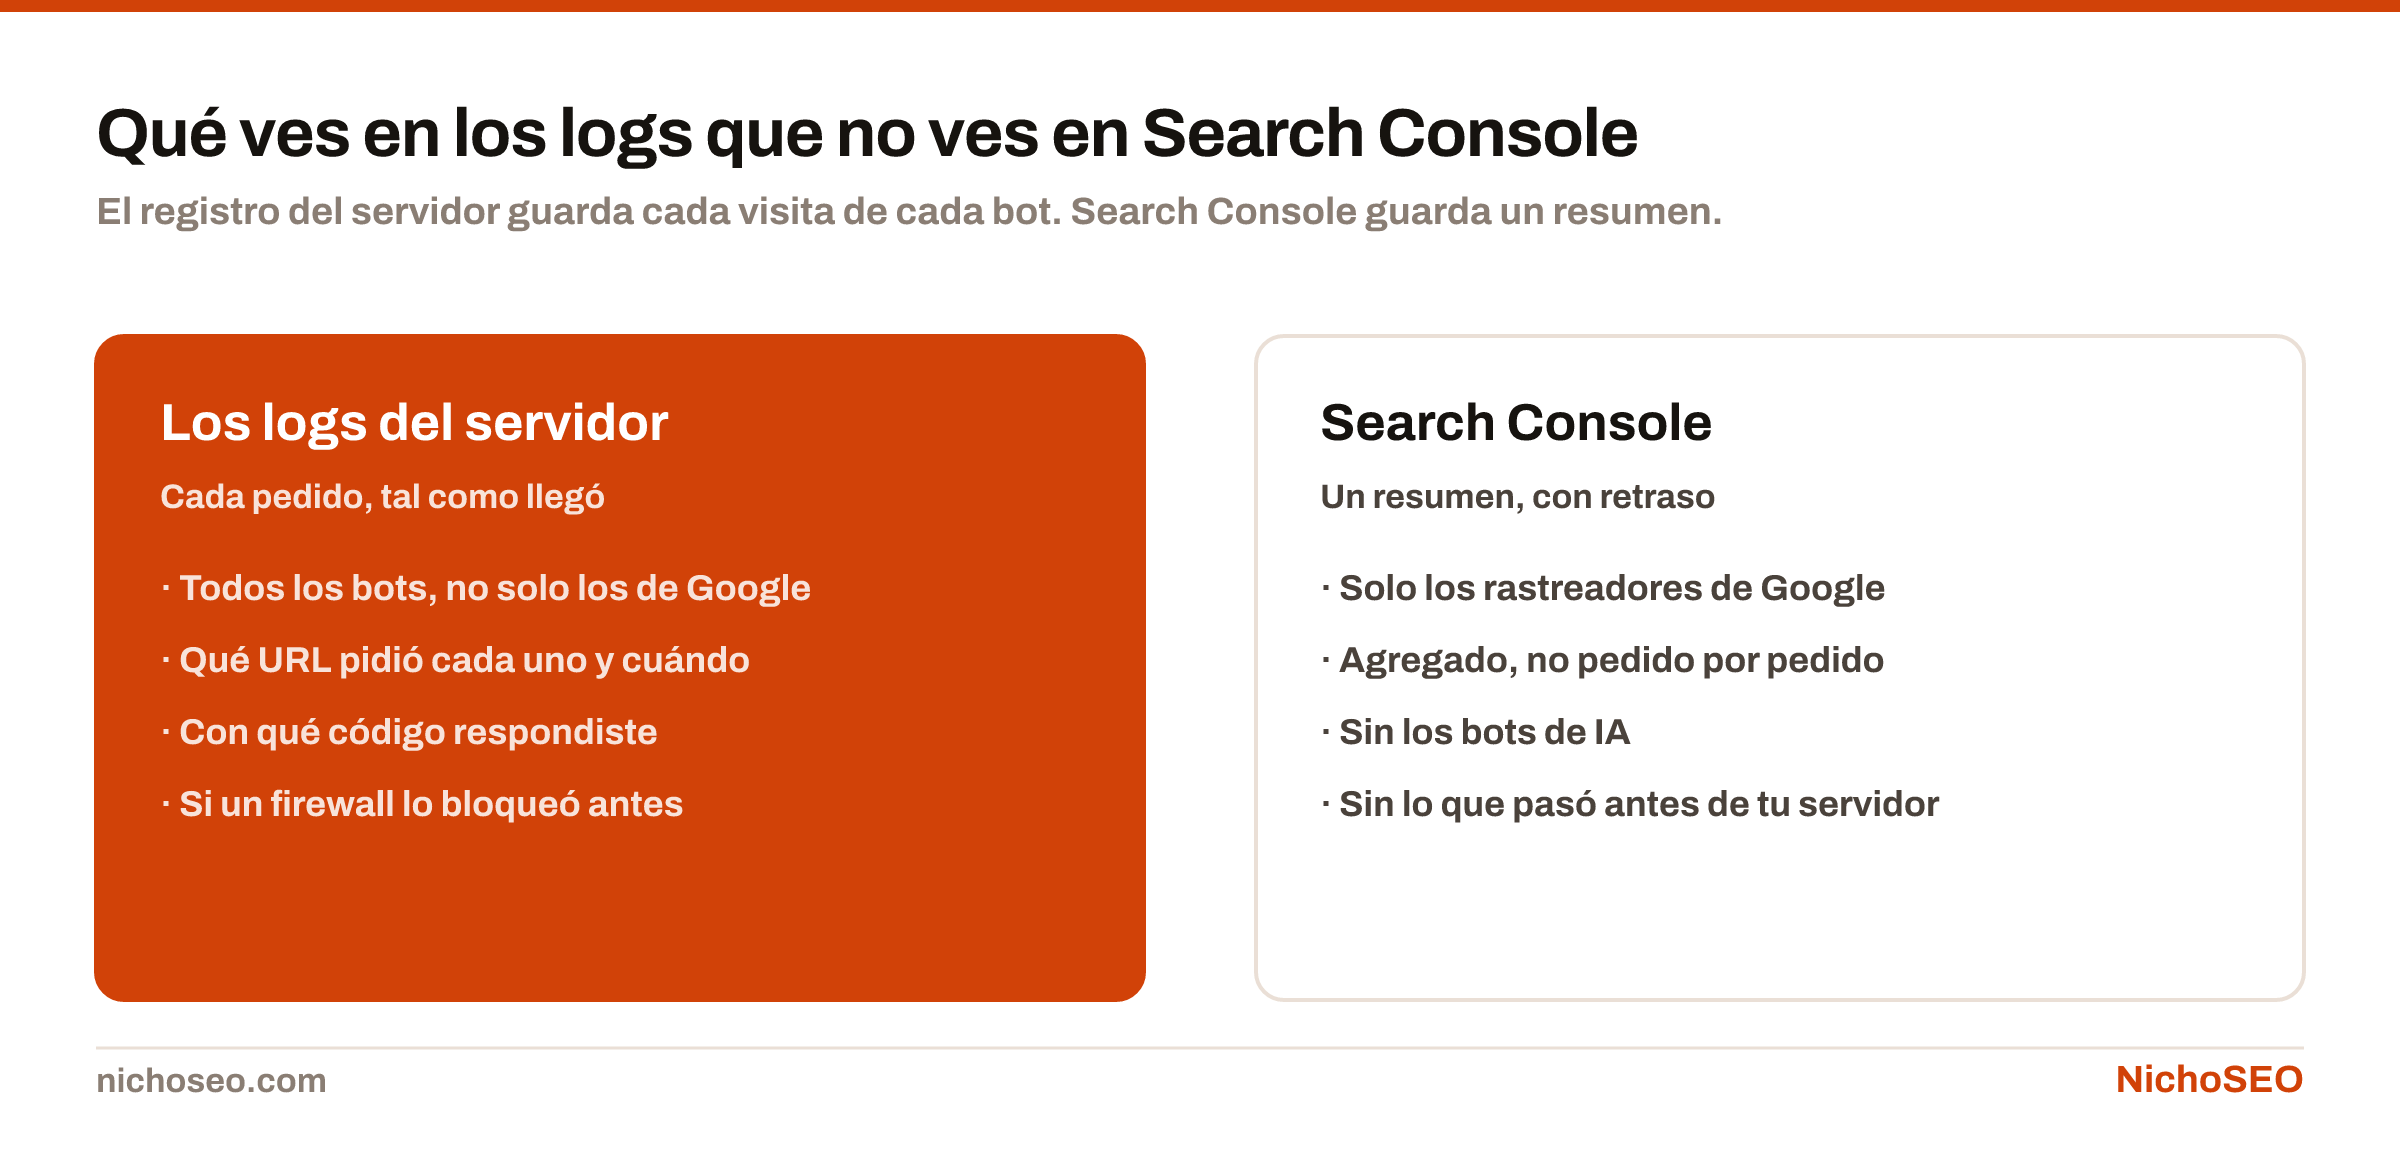
Diferencia entre los registros del servidor, que guardan cada visita de cada bot, y Search Console, que informa un resumen de solo los rastreadores de Google.
El registro del servidor guarda cada visita de cada bot. Search Console guarda un resumen.Descargar imagen

La diferencia que más importa hoy es la tercera: Search Console no informa nada sobre los bots de IA. Lo que sí informa, y en qué orden conviene leerlo, está en la guía de Search Console. Si OAI-SearchBot o PerplexityBot no están entrando a tu sitio, no hay panel que te lo diga.

Las 4 cosas que hay que buscar primero

1. Bots legítimos que nunca aparecen. Filtrá por los user-agents que te importan y mirá si figuran. Si Googlebot entra todos los días y OAI-SearchBot no aparece nunca, algo lo está frenando: el robots.txt, un firewall o la protección del proveedor.

Las dos familias de rastreadores de IA: los de entrenamiento, que recolectan texto para modelos futuros, y los de respuesta en vivo, que leen tu página para contestar ahora.
Se bloquean en el mismo archivo y con la misma sintaxis. Confundirlas es el error más caro del tema.Descargar imagen

Ese último caso es el más difícil de ver de otra forma, porque el bloqueo ocurre antes de tu aplicación y no deja rastro en ningún otro lado.

2. Códigos de error que se repiten. Un 403 recurrente para un bot es un bloqueo. Un 500 es tu servidor cayéndose justo cuando lo visitan. Los dos son invisibles desde el navegador.

3. URLs que consumen rastreo sin aportar. Filtros, ordenamientos, paginados infinitos. Si el 60 % de los pedidos van a variantes con parámetros, el rastreador se está gastando en eso en vez de encontrar tus páginas nuevas.

4. Páginas importantes que casi no se visitan. Si una entrada clave se rastrea una vez al mes, probablemente esté demasiado enterrada en la arquitectura.

Cómo leerlo sin herramientas caras

Un log es texto: una línea por pedido, con la fecha, la URL, el código y el user-agent.

Con filtrar por user-agent y contar ya sacás la mitad del valor. Las preguntas que responde ese recuento son las cuatro de arriba, y no necesitan nada más sofisticado.

Si tu sitio está en un servicio que no te da acceso a los logs, esa es una limitación real que conviene conocer antes de necesitarlos.

Cuándo importa y cuándo no

Vale ser honesto con la prioridad, porque es un tema que se invoca más de lo que se aplica.

Importa mucho en sitios grandes, con miles de URLs, donde el presupuesto de rastreo es una restricción real; y en cualquier sitio donde se sospeche que los bots de IA no están entrando.

Importa poco en un sitio de doscientas páginas bien enlazadas, donde Google rastrea todo sin esfuerzo. Ahí el análisis de logs va a confirmar que está todo bien, que es información pero no acción.

Las cuatro condiciones del SEO técnico en cadena: rastrear, renderizar, indexar y cargar rápido. Las tres primeras son de sí o no; la cuarta es de grado.
Los logs sirven sobre todo para la primera condición: comprobar que el rastreador entra de verdad, y no suponerlo.Descargar imagen

Lo que no resuelve

No te dice por qué una página no se indexa, solo si se rastreó. Rastrear e indexar son dos pasos distintos y el segundo no deja huella en tu servidor. Para eso está el diagnóstico de indexación.

No te dice si el contenido gustó. Los logs miden acceso, no calidad.

Google documenta cómo identificar correctamente a sus rastreadores —incluidas las verificaciones para descartar impostores— en su guía de rastreadores.