
Puntos clave
- Hay dos familias de rastreadores de IA: los de entrenamiento y los de respuesta en vivo. Se llaman distinto y hacen cosas distintas.
- Bloquear los de entrenamiento es una decisión defendible. Bloquear los de respuesta en vivo te saca de las citas, y casi siempre se hace sin querer.
- Un Disallow genérico para todos los bots de IA mete a los dos grupos en la misma bolsa. Es el error más común.
- El robots.txt es una convención que se respeta por buena fe, no un control de acceso. Si algo no puede leerse, no alcanza con pedirlo.
Confundirlas es el error más caro del tema, porque el bloqueo se hace en el mismo archivo y con la misma sintaxis.
Las 2 familias de rastreadores de IA
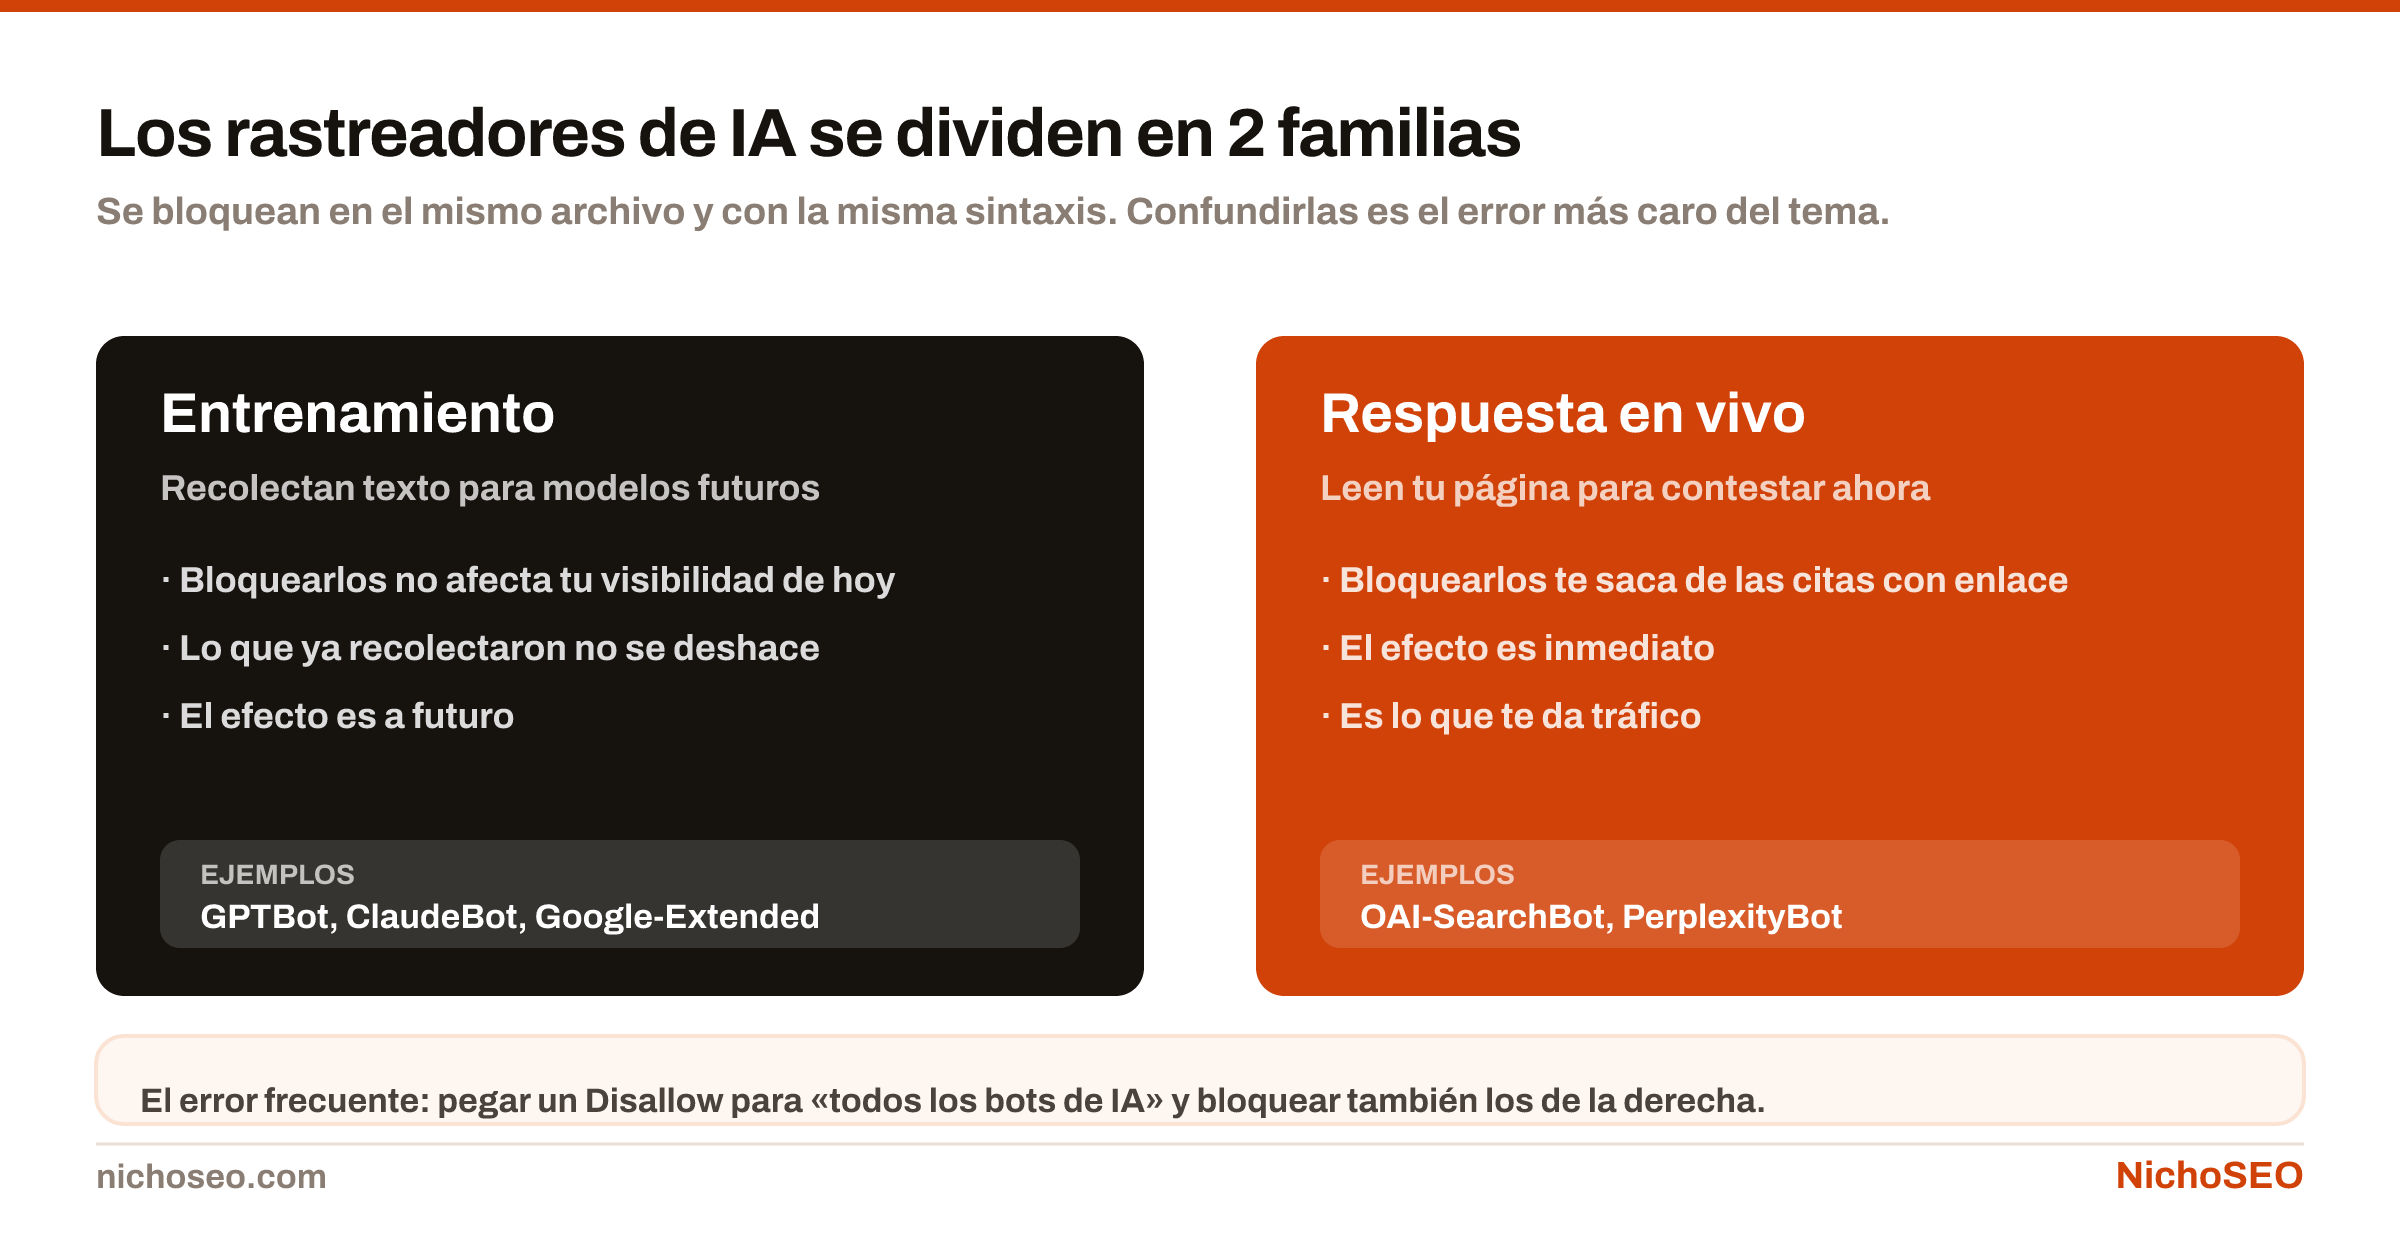
Alguien lee que «la IA se roba el contenido», busca una lista de bots de IA y pega un bloque de Disallow para todos. Con eso bloquea el entrenamiento —que era la intención— y también la lectura en vivo, que era justo lo que le daba citas y tráfico. El efecto de lo segundo se nota en semanas y casi nunca se conecta con la causa.
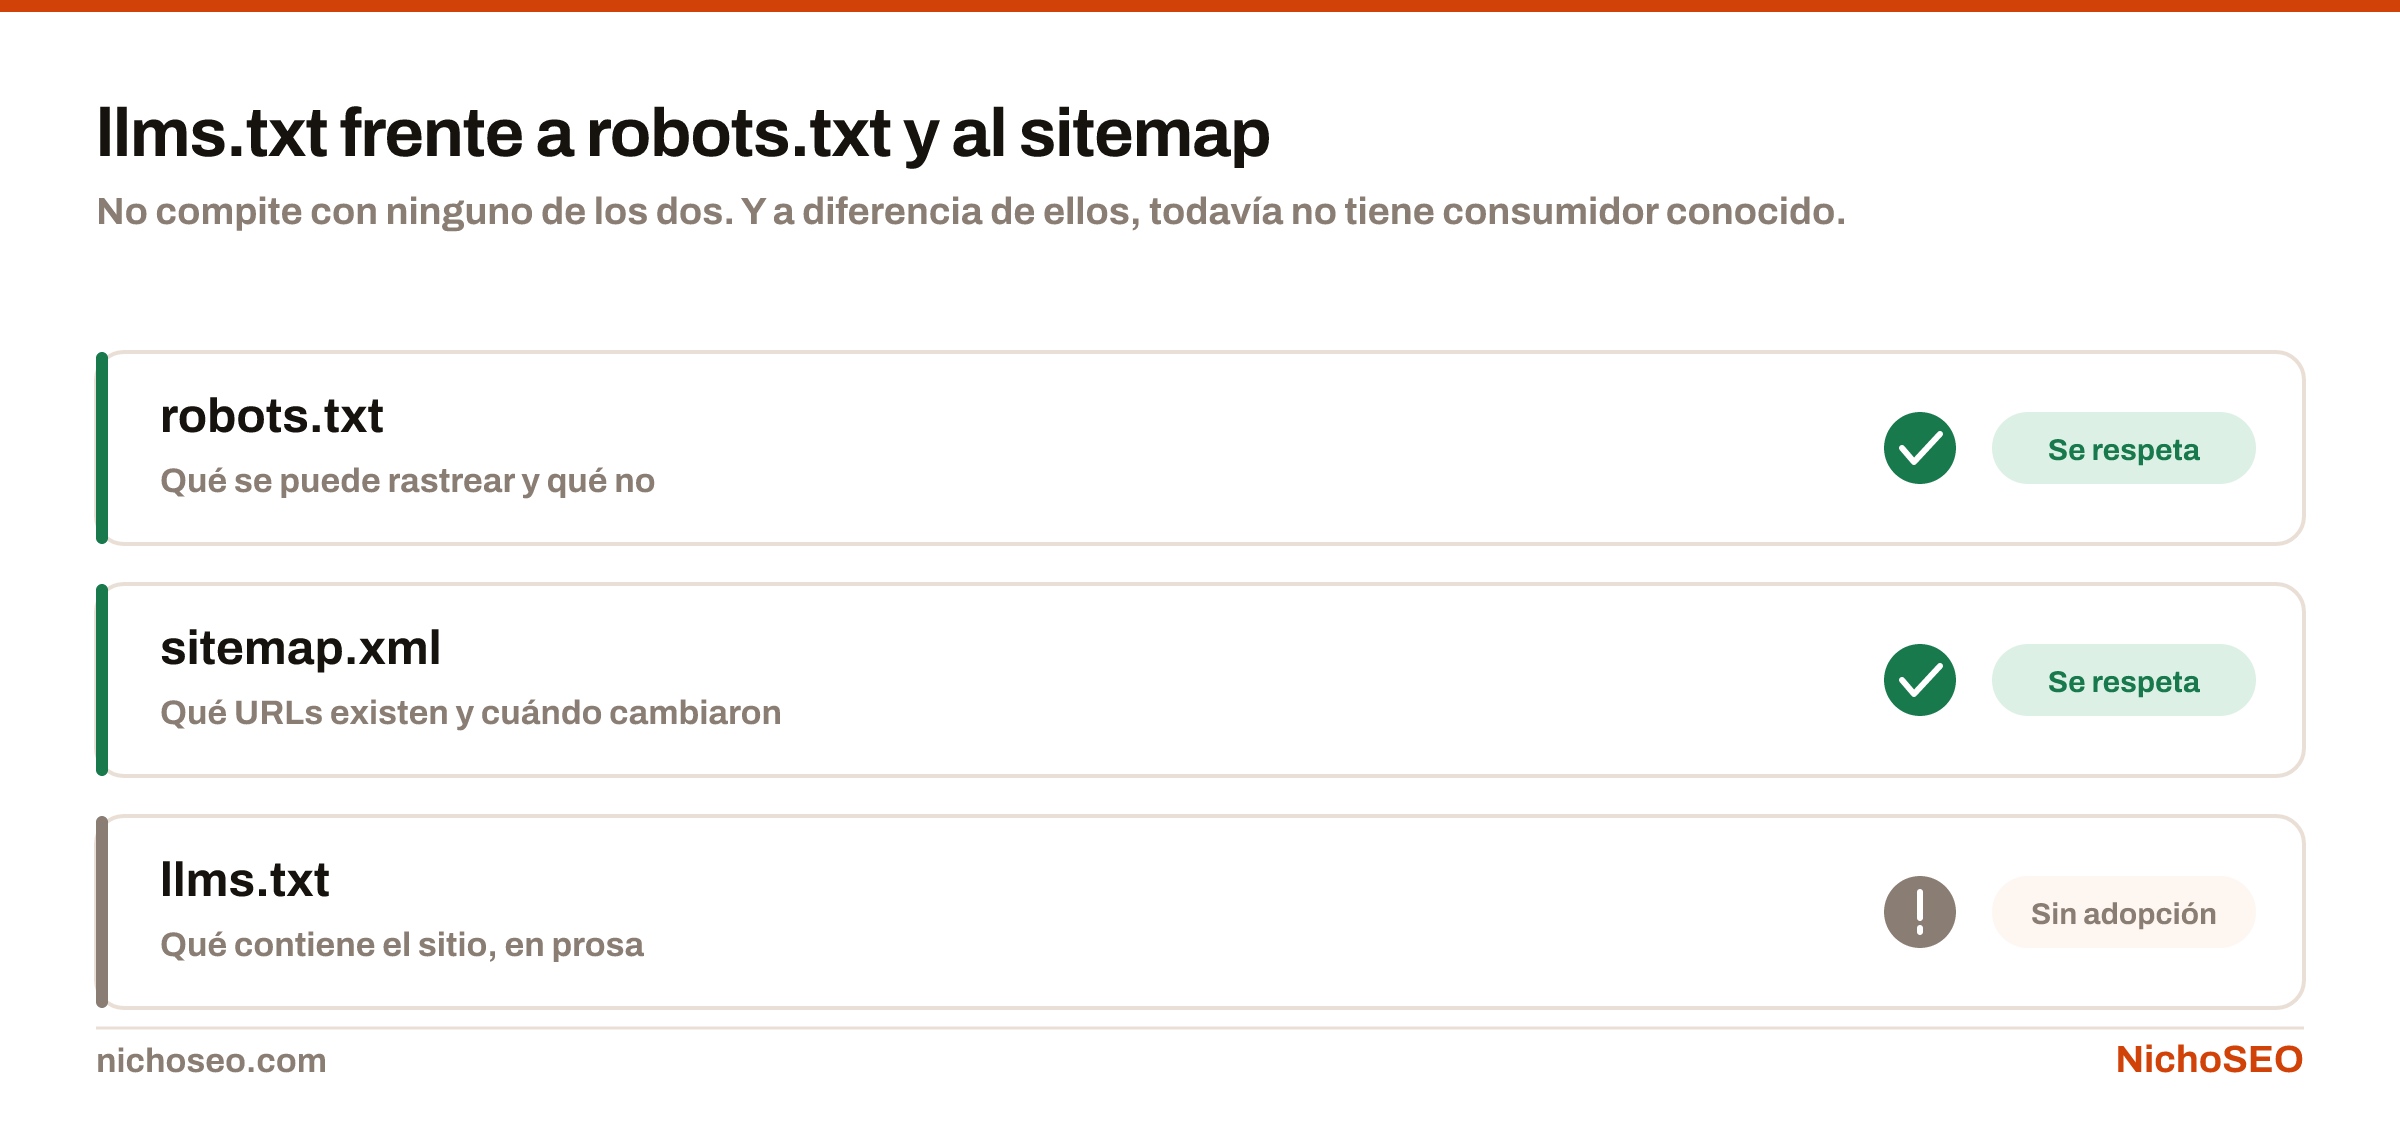
El del medio es el más joven y el más discutido: qué es llms.txt, quién lo lee hoy y si conviene tenerlo, aparte.
Qué poner en tu robots.txt: dos configuraciones listas
Permitir todo, que es lo que conviene a casi cualquiera que quiera visibilidad:
User-agent: *
Allow: /

Sitemap: https://tusitio.com/sitemap.xml
Bloquear solo el entrenamiento, dejando entrar a los que responden:
# Entrenamiento: no
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

# Respuesta en vivo: sí
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Las listas oficiales están publicadas: OpenAI, Perplexity y Google. Conviene mirarlas en vez de copiar una lista de un foro.
3 cosas que conviene saber antes de bloquear nada
El robots.txt no es un control de acceso. Es una convención que los rastreadores serios respetan por buena fe. No impide técnicamente que nadie lea una página pública. Si algo no debe leerse, no alcanza con pedirlo: hay que sacarlo de la web pública.
Bloquear el entrenamiento no borra lo anterior. Lo que ya se recolectó está en los modelos que se entrenaron con eso. El bloqueo aplica hacia adelante.
La lista de bots cambia. Aparecen nombres nuevos y algunos se renombran. Un robots.txt escrito una vez y nunca revisado empieza a bloquear cosas que ya no existen y a dejar pasar cosas que sí.
Cómo decidir qué bloquear: las dos preguntas separadas
La pregunta no es «¿quiero que la IA use mi contenido?» sino dos preguntas separadas:
- ¿Quiero que mi contenido entre en el entrenamiento de modelos futuros? Acá entra el criterio de cada uno: propiedad intelectual, modelo de negocio, tipo de contenido.
- ¿Quiero aparecer citado cuando alguien pregunte por mi tema? Si la respuesta es sí —y para casi cualquier sitio que busca visibilidad lo es—, los rastreadores de respuesta en vivo van permitidos.
Las dos respuestas pueden ser distintas. El archivo permite decirlo, y ese es todo el punto de separarlos.
Cómo comprobar qué bots están entrando de verdad
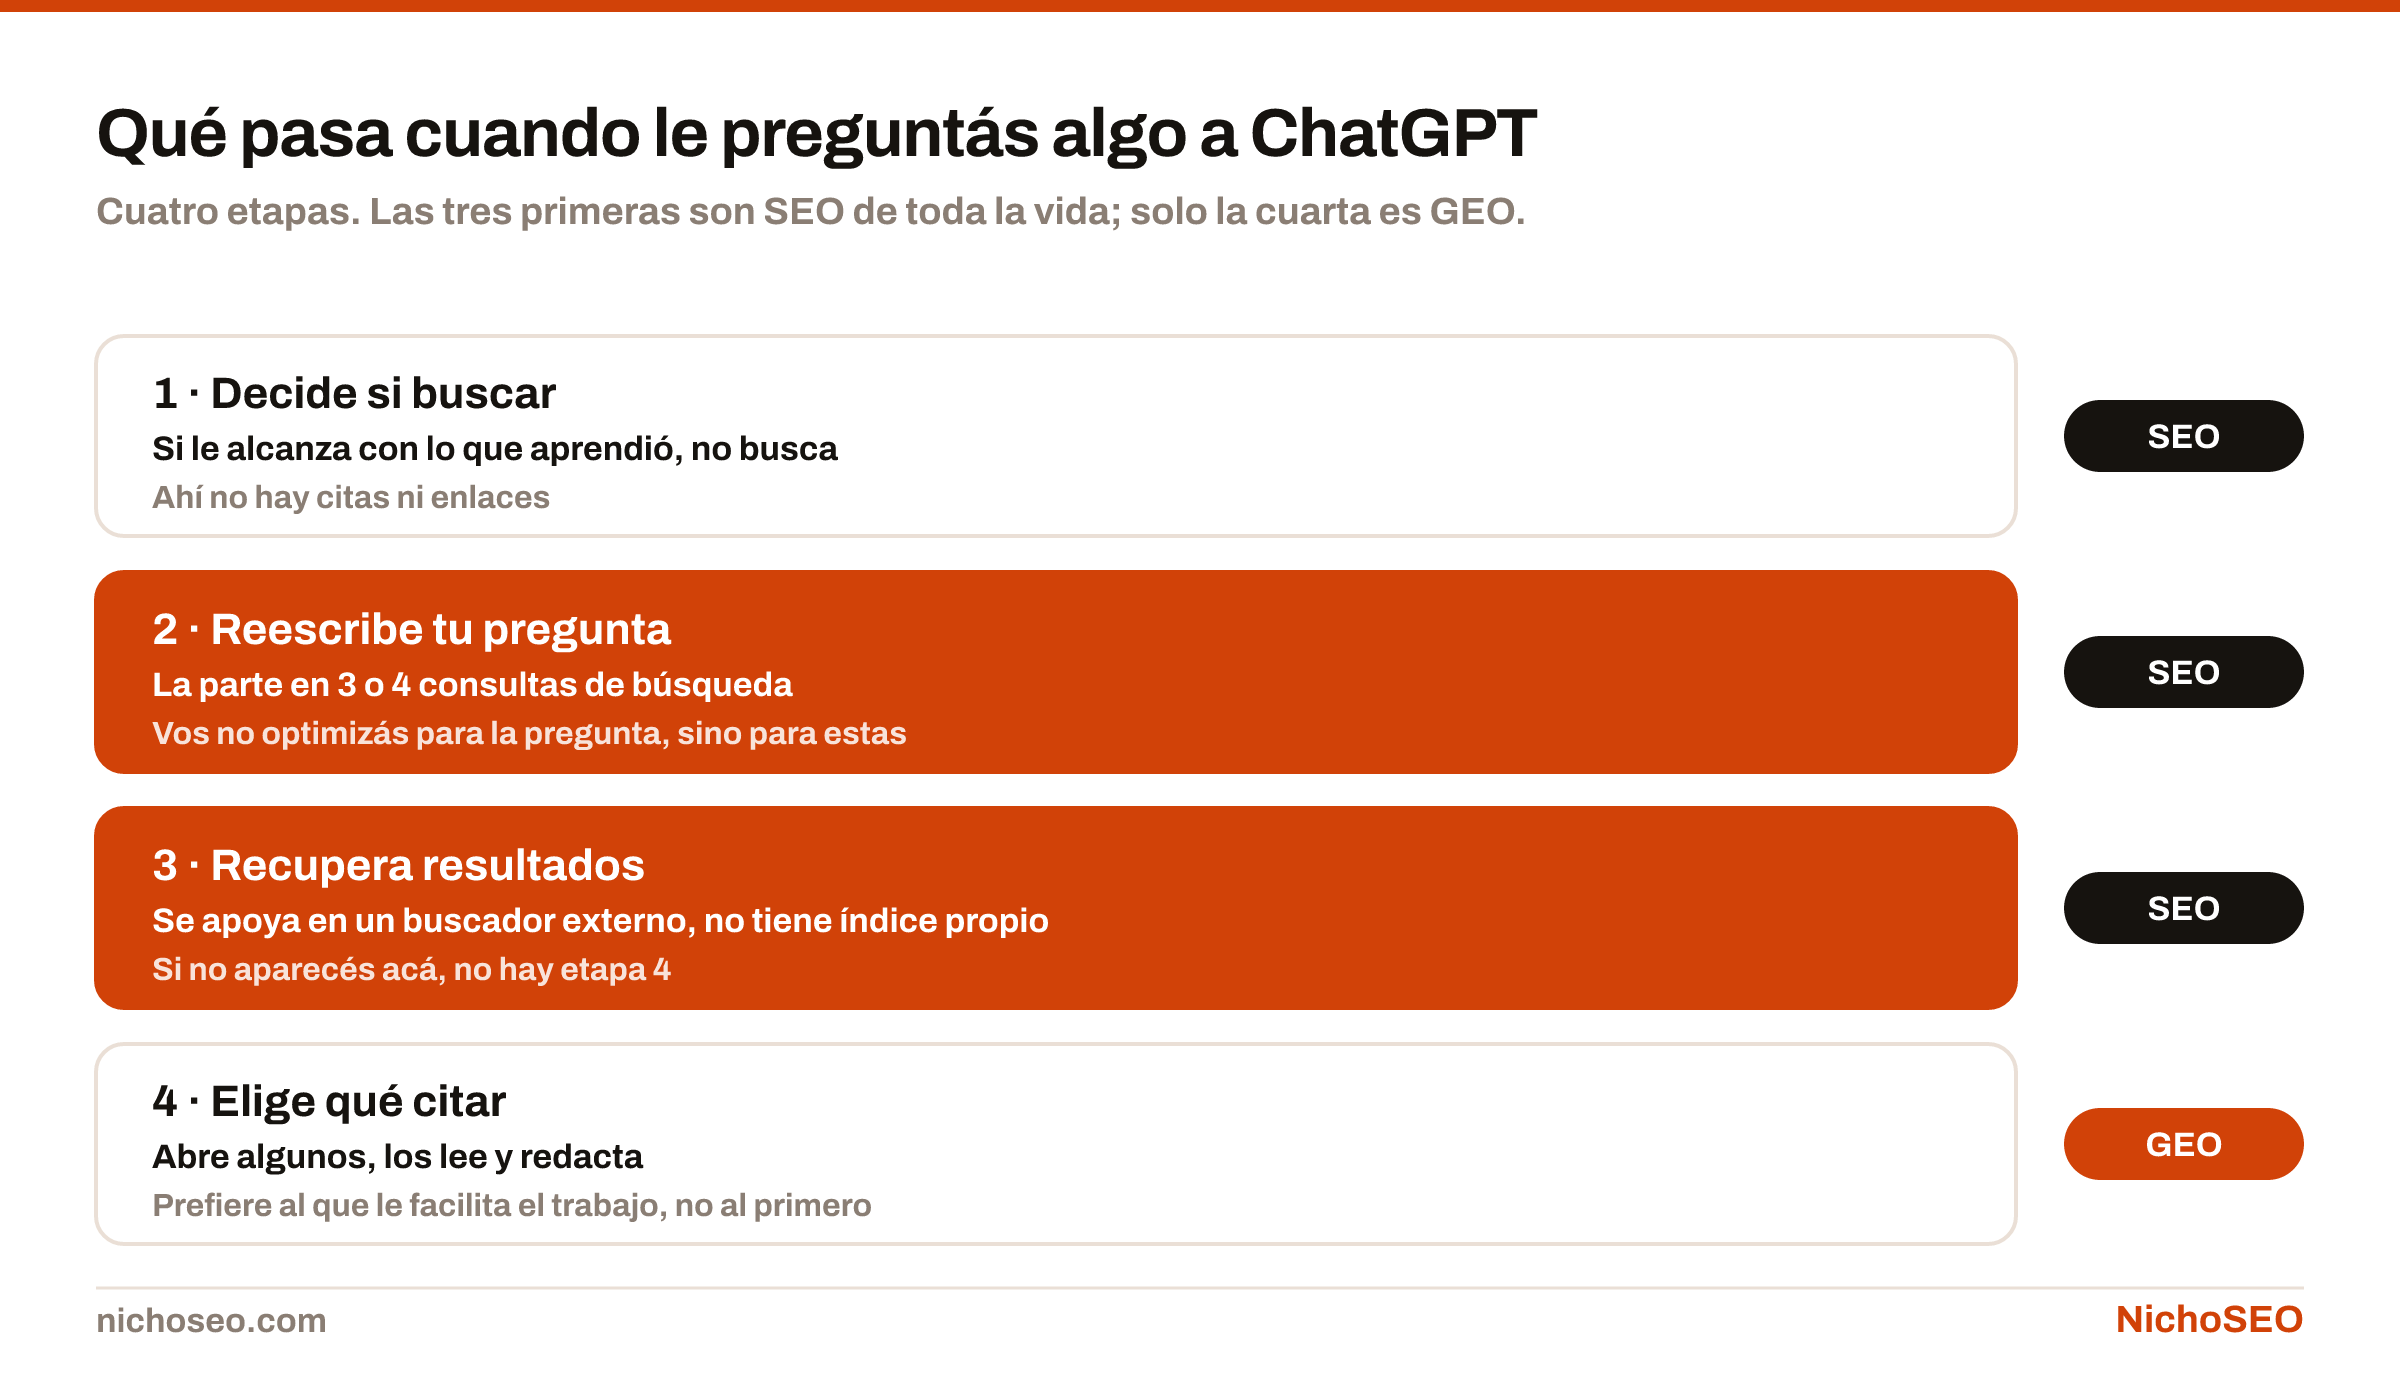
Mirá los registros del servidor y buscá esos user-agents. Si un bot que creés permitido no aparece nunca, algo lo está frenando antes del robots.txt: un firewall, un WAF o la protección anti-bots del proveedor, que muchas veces bloquea por su cuenta sin que nadie lo haya pedido.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Historial de revisiones
- Se aplicó el playbook: título y encabezados descriptivos, tarjeta de definición y tres imágenes descargables.
- Publicada.