
Puntos clave
- No existe un botón que garantice la indexación. La inspección de URL en Search Console pide una revisión, no la obliga.
- El diagnóstico va en orden: ¿se puede rastrear? ¿está bloqueada? ¿el canonical apunta a otra? ¿el contenido aporta algo?
- «Descubierta, actualmente sin indexar» y «Rastreada, actualmente sin indexar» son dos problemas distintos y se arreglan distinto.
- Cuando todo lo técnico está bien y igual no indexa, el problema es el contenido. Es la respuesta que nadie quiere y la correcta la mayoría de las veces.
Cómo hacer que Google indexe tu página: el procedimiento
Cuatro cosas, en orden:
- Que la página se pueda rastrear. Responde 200, no está bloqueada en el
robots.txt, no exige autenticación. - Que esté enlazada desde alguna página que ya se indexa. Es como se descubre, y una página huérfana puede no descubrirse nunca.
- Que esté en el sitemap, con un
lastmodreal. - Pedir la revisión con la inspección de URL de Search Console. Eso adelanta la visita; no garantiza el resultado.
Con eso alcanza para la mayoría de los casos. El resto de este texto es para cuando no alcanza.
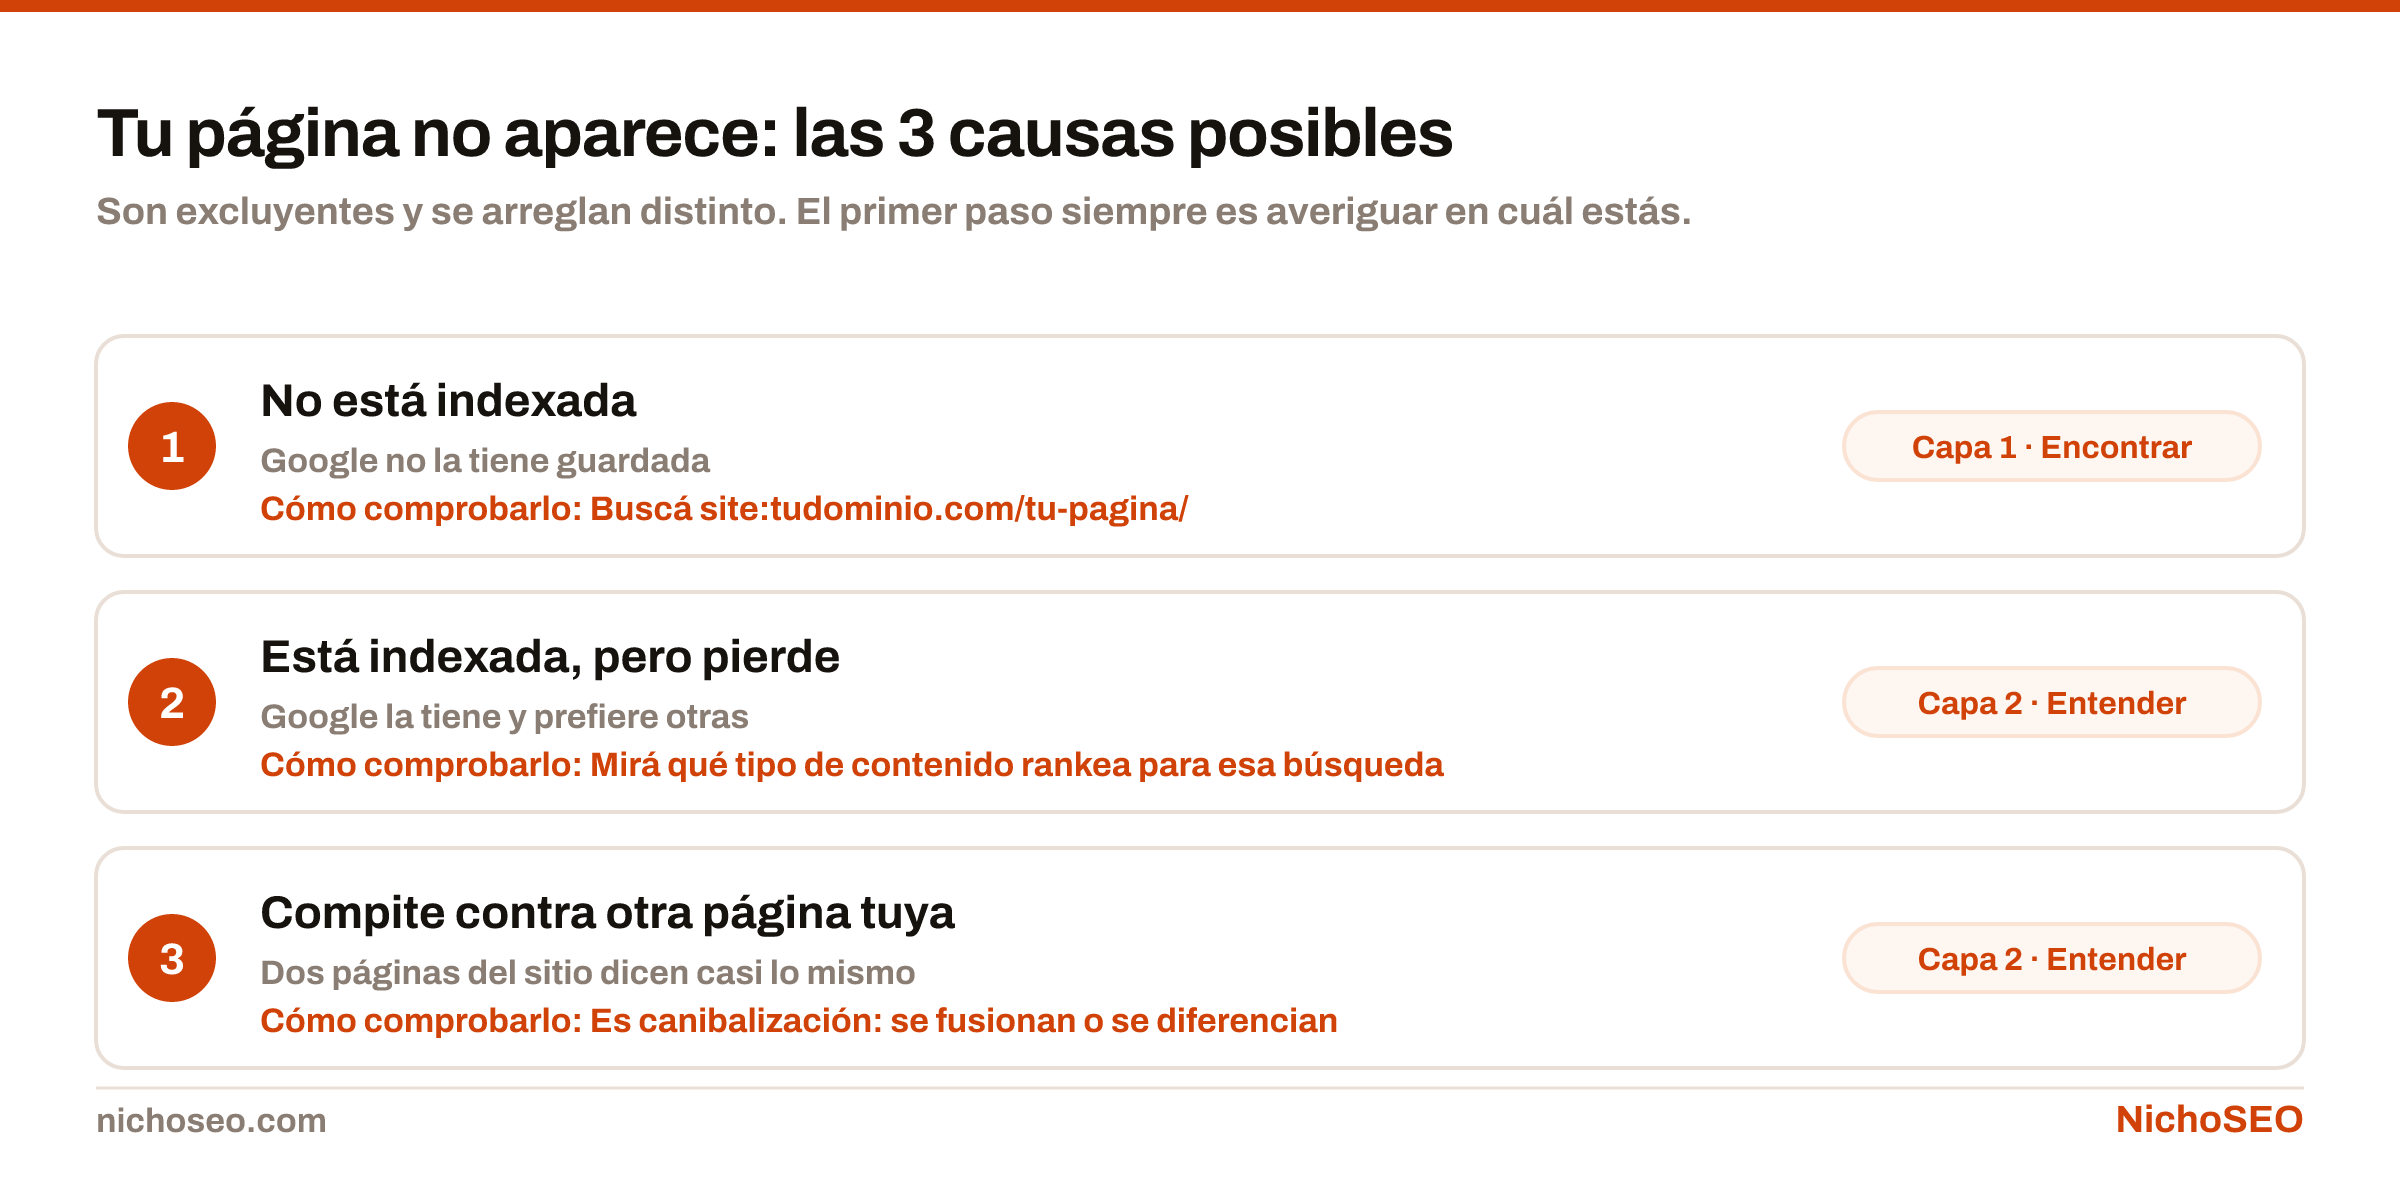
«No puede» y «no quiere»: dos problemas distintos
Descubierta, sin indexar
- Google conoce la URL pero no la pidió todavía.
- Suele ser cuestión de prioridad: hay muchas URLs y esta no parece urgente.
- Se ataca con enlaces internos desde páginas fuertes y con menos URLs compitiendo.
Rastreada, sin indexar
- La pidió, la leyó y decidió no guardarla.
- Casi siempre es una señal sobre el contenido, no sobre la técnica.
- No se arregla insistiendo con la inspección de URL.
Confundirlos hace perder semanas. Para el primero se trabaja descubrimiento; para el segundo, el contenido.
El diagnóstico en 5 pasos, siempre en este orden
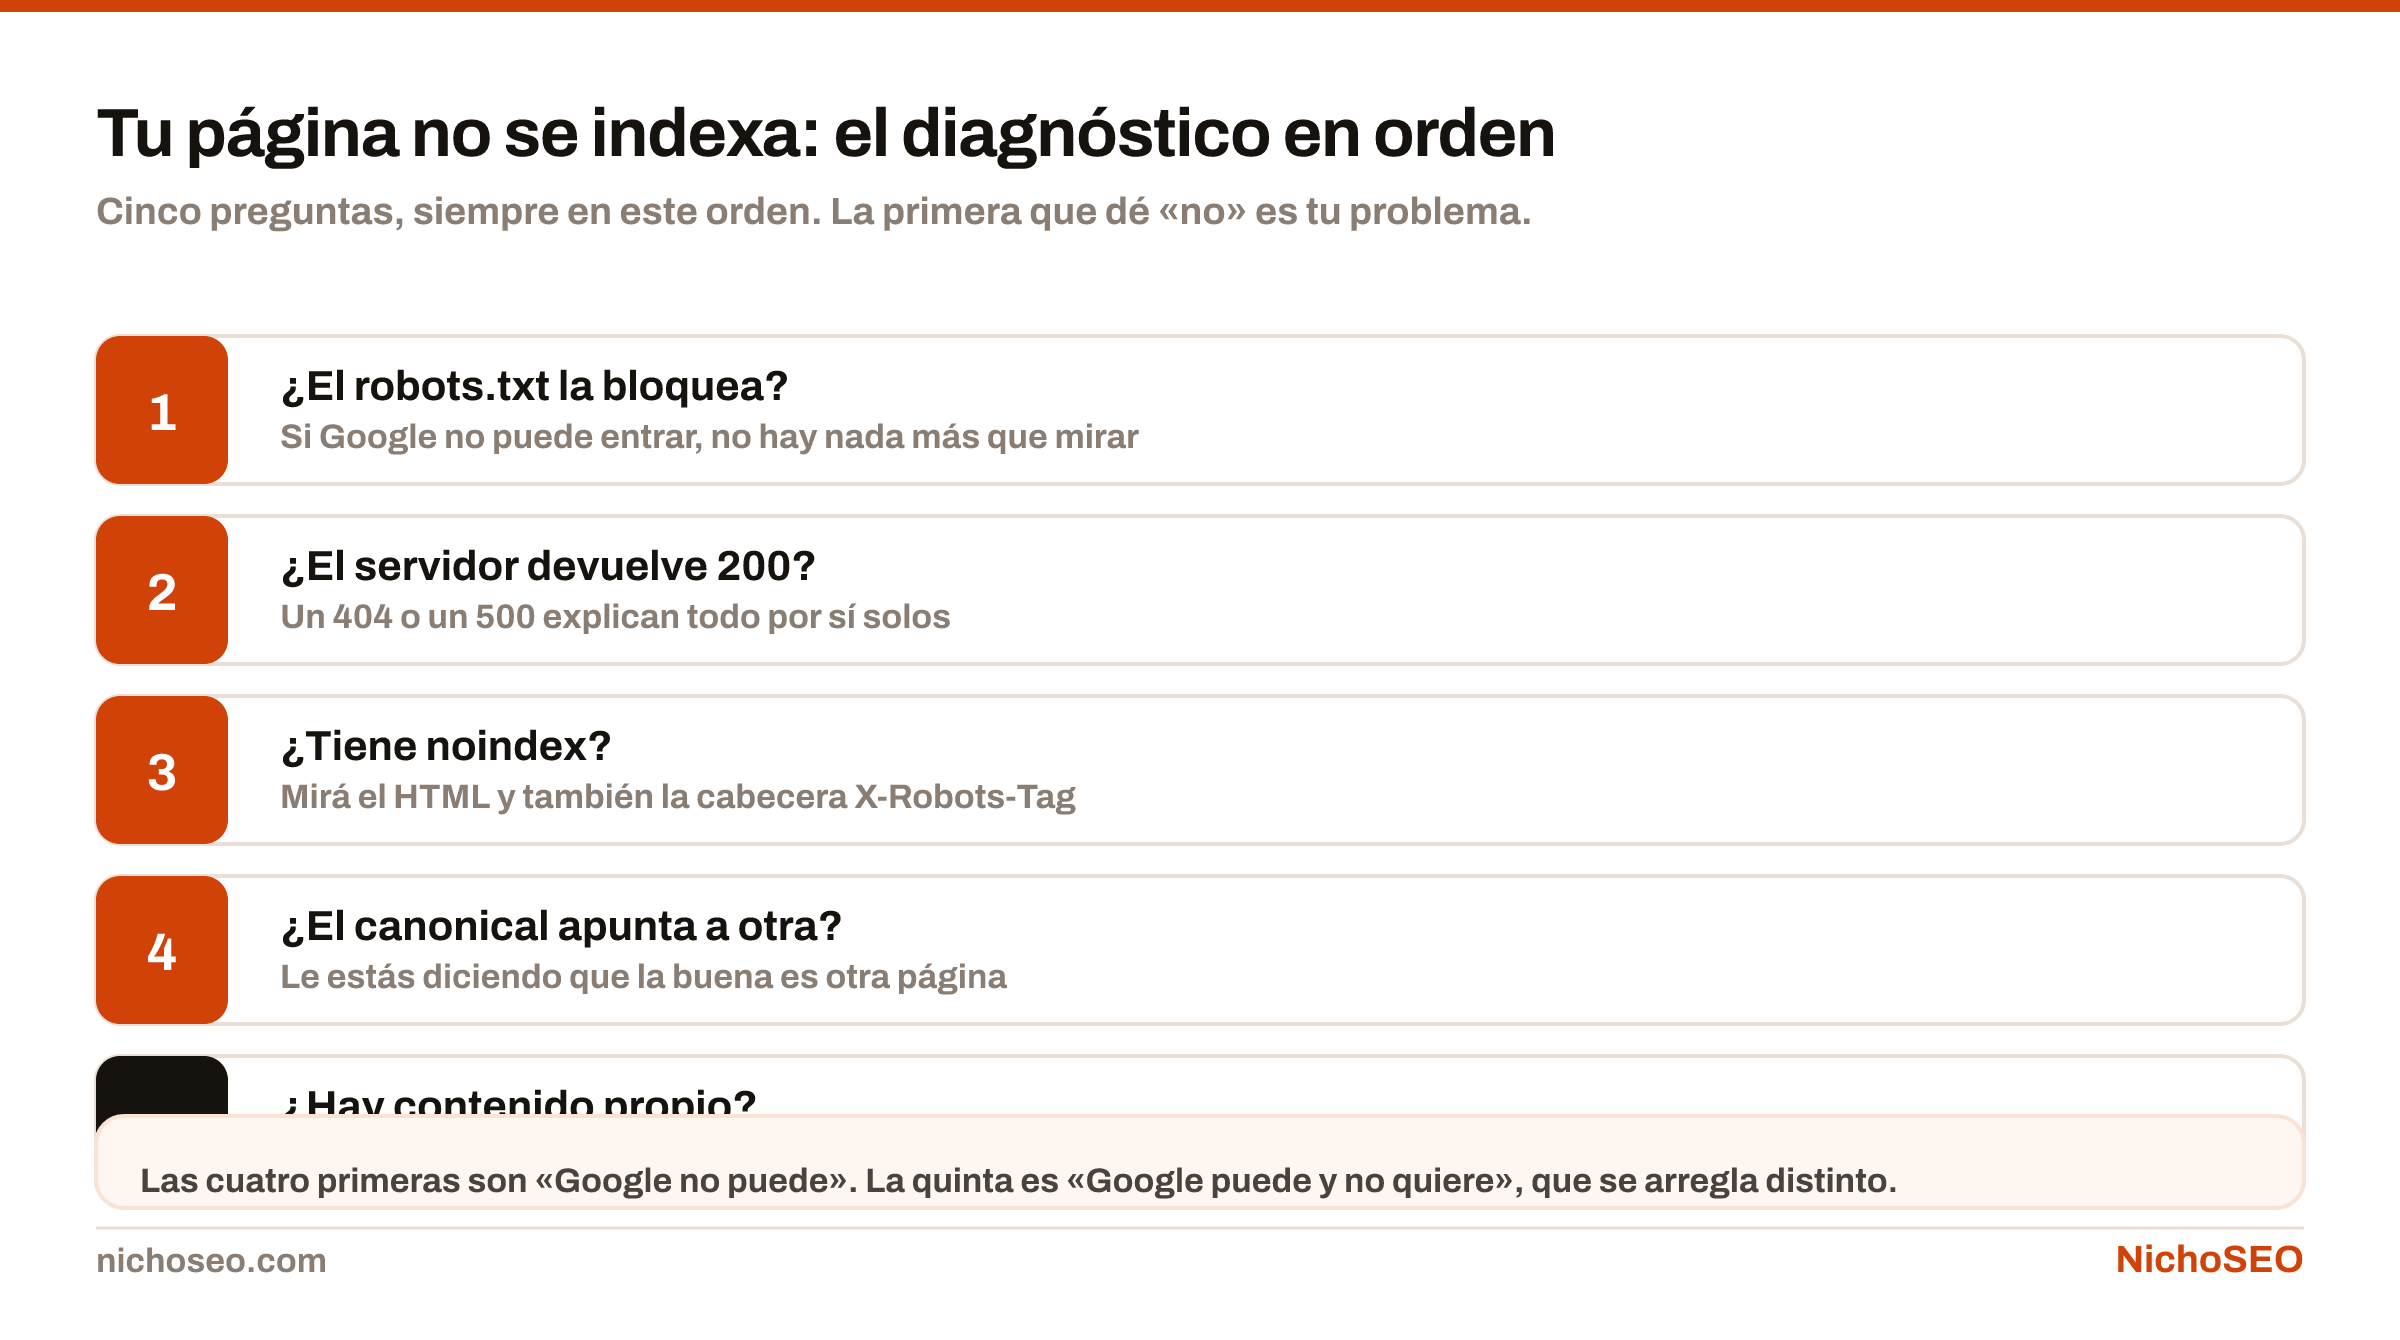
1. ¿Responde 200? curl -I sobre la URL. Un 301, un 404 o un 403 explican todo por sí solos.
2. ¿Hay un noindex? Buscalo en el HTML y en las cabeceras. Un X-Robots-Tag: noindex no aparece en el código fuente, y es de los que más tiempo hacen perder.
3. ¿El canonical apunta a otra página? Si sí, le estás diciendo a Google que no la indexe. Pasa con plantillas que ponen el mismo canonical en todo el sitio.
4. ¿El contenido existe sin JavaScript? Mirá el código fuente original. Si el artículo no está ahí, depende de un renderizado que agrega demora e incertidumbre.
5. ¿Hay otra página tuya casi igual? Google elige una y descarta las demás. Eso es canibalización, y se resuelve fusionando.
Si la página se rastrea, responde 200, no tiene noindex, el canonical apunta a sí misma y el contenido está en el HTML, y aun así no indexa: el problema es que la página no aporta nada que no esté ya indexado. Es la respuesta que nadie quiere escuchar y la correcta la mayoría de las veces.
Los dos documentos que hacen falta para el diagnóstico son etiquetas meta para robots y los rastreadores de Google.
Qué no hacer cuando una página no indexa
Pedir la indexación todos los días. No acelera nada y no cambia la decisión.
Comprar servicios de indexación. Los que funcionan usan las mismas APIs públicas; los que prometen forzarla, mienten.
Publicar más para compensar. Si el problema es que el contenido no aporta, más contenido igual empeora el diagnóstico del sitio entero.
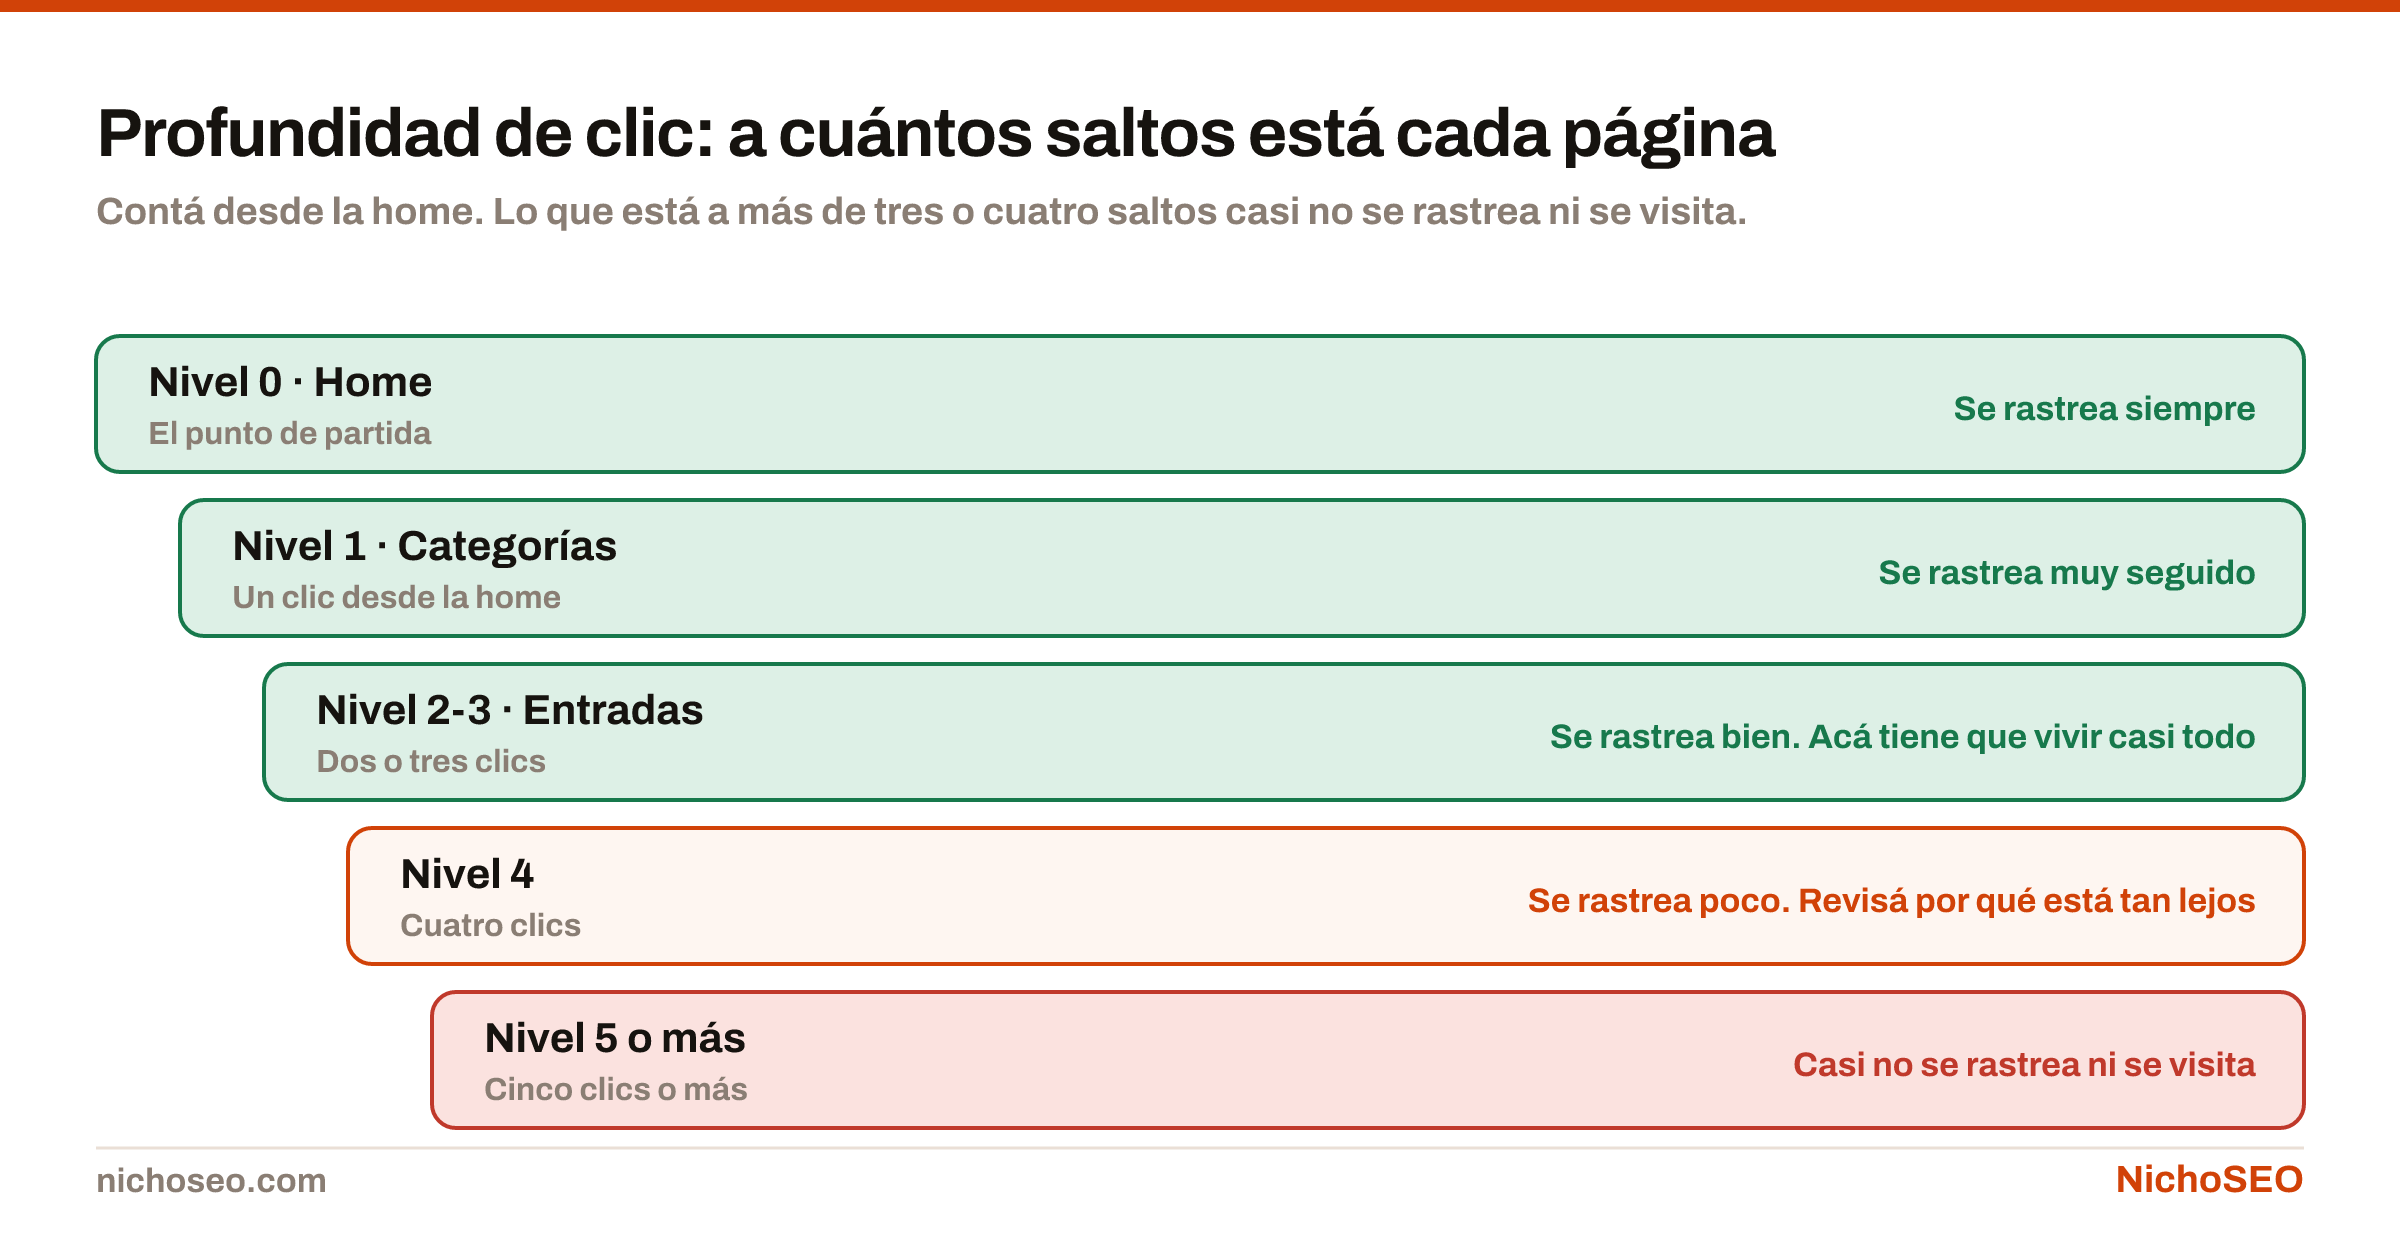
Qué sí acelera la indexación
Enlaces internos desde páginas que ya se indexan y reciben tráfico. Un enlace desde tu página más fuerte hace más por una URL nueva que cualquier herramienta.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Historial de revisiones
- Se aplicó el playbook: título y encabezados descriptivos, tarjeta de definición y tres imágenes descargables.
- Publicada.