

Puntos clave
- Un modelo cita texto. De un video cita la transcripción, no el video.
- Subir tu propia transcripción es mejor que dejar la automática, y cuesta poco.
- Una infografía con el dato solo dibujado es un dato que no se puede citar.
- El texto alternativo de una imagen tiene que decir qué muestra, no que hay una imagen.
- La regla general: todo lo que quieras que se cite tiene que existir como texto.
Esa frase resume el capítulo entero: todo lo demás son formas de asegurarse de que ese texto exista.
Qué extrae de cada formato
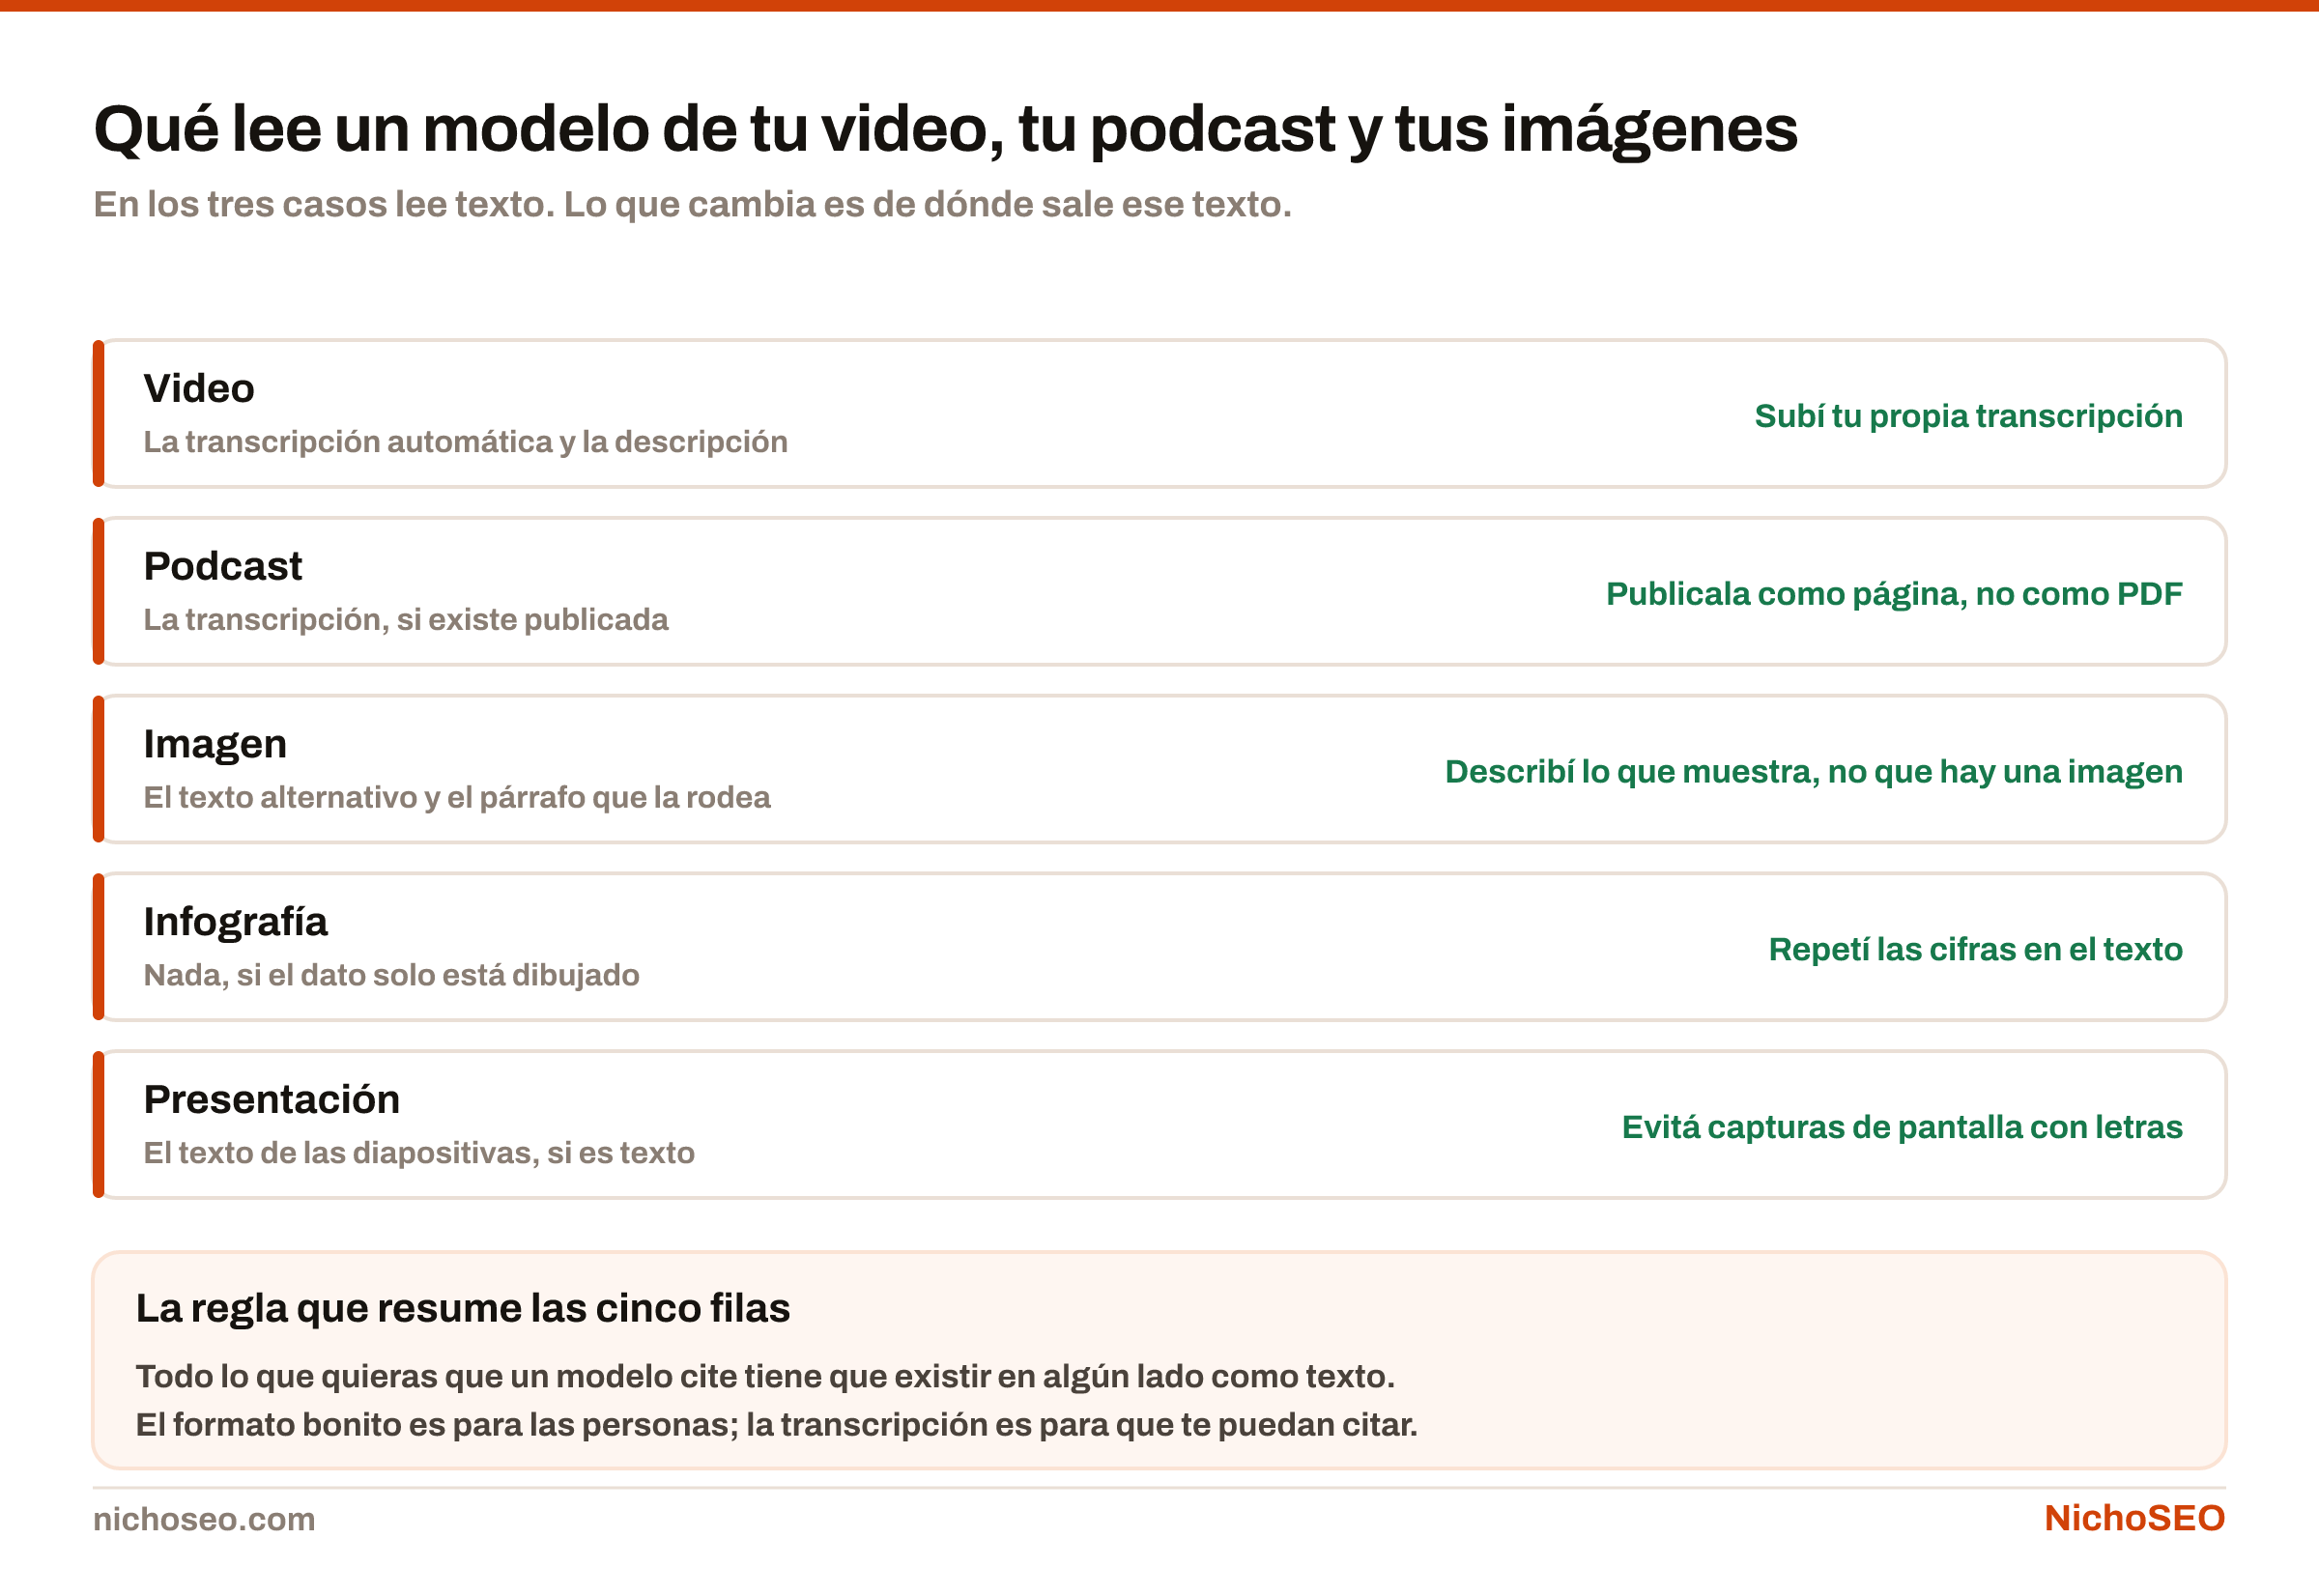
La columna del medio es la que sorprende. En los cinco formatos, lo que el modelo usa es texto, y en dos de los cinco ese texto puede directamente no existir.
Una infografía donde el dato está dibujado adentro es, para un rastreador, una imagen sin contenido. La cifra que tanto trabajo costó producir no está en ninguna parte que se pueda leer.
Video: la transcripción es el contenido
Un video en YouTube genera una transcripción automática. Eso es mejor que nada y bastante peor de lo que conviene.
Las automáticas fallan justo donde importa: los nombres propios, los términos técnicos, las cifras. Un video sobre “GPTBot” puede quedar transcrito como “GPT bot” o “chat bot”, y esa es exactamente la palabra por la que querías que te encontraran.
Un video que se puede citar
- Transcripción propia, corregida, subida como subtítulos
- Descripción con el contenido real, no «suscribite»
- Capítulos con títulos que digan algo
- Una página en tu sitio con el video y la transcripción
Uno que no
- Solo la transcripción automática
- Descripción con enlaces y nada más
- Sin capítulos, o con «intro / tema / cierre»
- El video incrustado sin nada de texto alrededor
La cuarta merece detalle: publicar el video en tu propio sitio con la transcripción escrita debajo. Eso convierte un contenido que vive en una plataforma ajena en una página tuya, con texto, que un modelo puede citar y enlazar.
Los capítulos funcionan como encabezados: dividen el video en partes con título y permiten que se cite un tramo concreto. Un capítulo que dice “Cómo comprobarlo en los logs” sirve; uno que dice “Parte 2” no.
Podcast: publicá la transcripción como página
Es el formato con la brecha más grande entre el trabajo invertido y lo que un modelo puede usar.
Una hora de conversación con información que no está en ningún otro lado, y si no hay transcripción publicada, para un modelo no existe.
Lo que hace falta:
- Una página por episodio, en tu sitio, no solo en la plataforma de audio.
- La transcripción completa en HTML, con los nombres de quién dice qué.
- Encabezados dentro de la transcripción, cada cinco o diez minutos, que digan de qué se habla.
- Un resumen arriba con lo que se responde en el episodio.
El punto 4 es el más rentable: un resumen de cinco líneas al principio es lo más fácil de extraer de toda la página, y es lo que un modelo va a citar si tiene que responder algo rápido.
La transcripción automática también sirve como punto de partida acá, pero conviene pasarla por una corrección de nombres propios y cifras antes de publicarla.
Imágenes: el alt tiene que decir qué muestra
El texto alternativo es el campo más maltratado de la web.
La mayoría dice “imagen”, “gráfico” o repite el título del artículo. Nada de eso informa, ni a un lector de pantalla ni a un rastreador.
Lo que tiene que decir un texto alternativo
Un ejemplo de la diferencia. Mal: alt="gráfico de bots". Bien: alt="Los seis rastreadores de IA más frecuentes, con de quién es cada uno y si entrena modelos o responde consultas en vivo".
El segundo tiene otra ventaja: si la imagen no carga, el texto solo sigue informando.
Y hay una regla que viene de ahí: si un dato importa, repetilo en el texto del artículo. La imagen es para que se entienda de un vistazo; el párrafo es para que se pueda citar.
Por qué las infografías rinden menos de lo que parece
Son el formato que más se comparte y el que peor se cita.
Toda la información está dibujada. Un rastreador ve un archivo de imagen y un texto alternativo, que en el mejor de los casos resume una parte.
Eso no significa que no sirvan: sirven para que la gente las comparta, y cuando alguien las publica en su sitio suele acompañarlas de texto que sí se lee. Pero no reemplazan al artículo: lo acompañan.
La forma de aprovecharlas es la obvia y la que casi nadie hace: publicar las cifras de la infografía también como tabla o como párrafos. Mismo trabajo, dos formatos, y uno de los dos se puede citar.
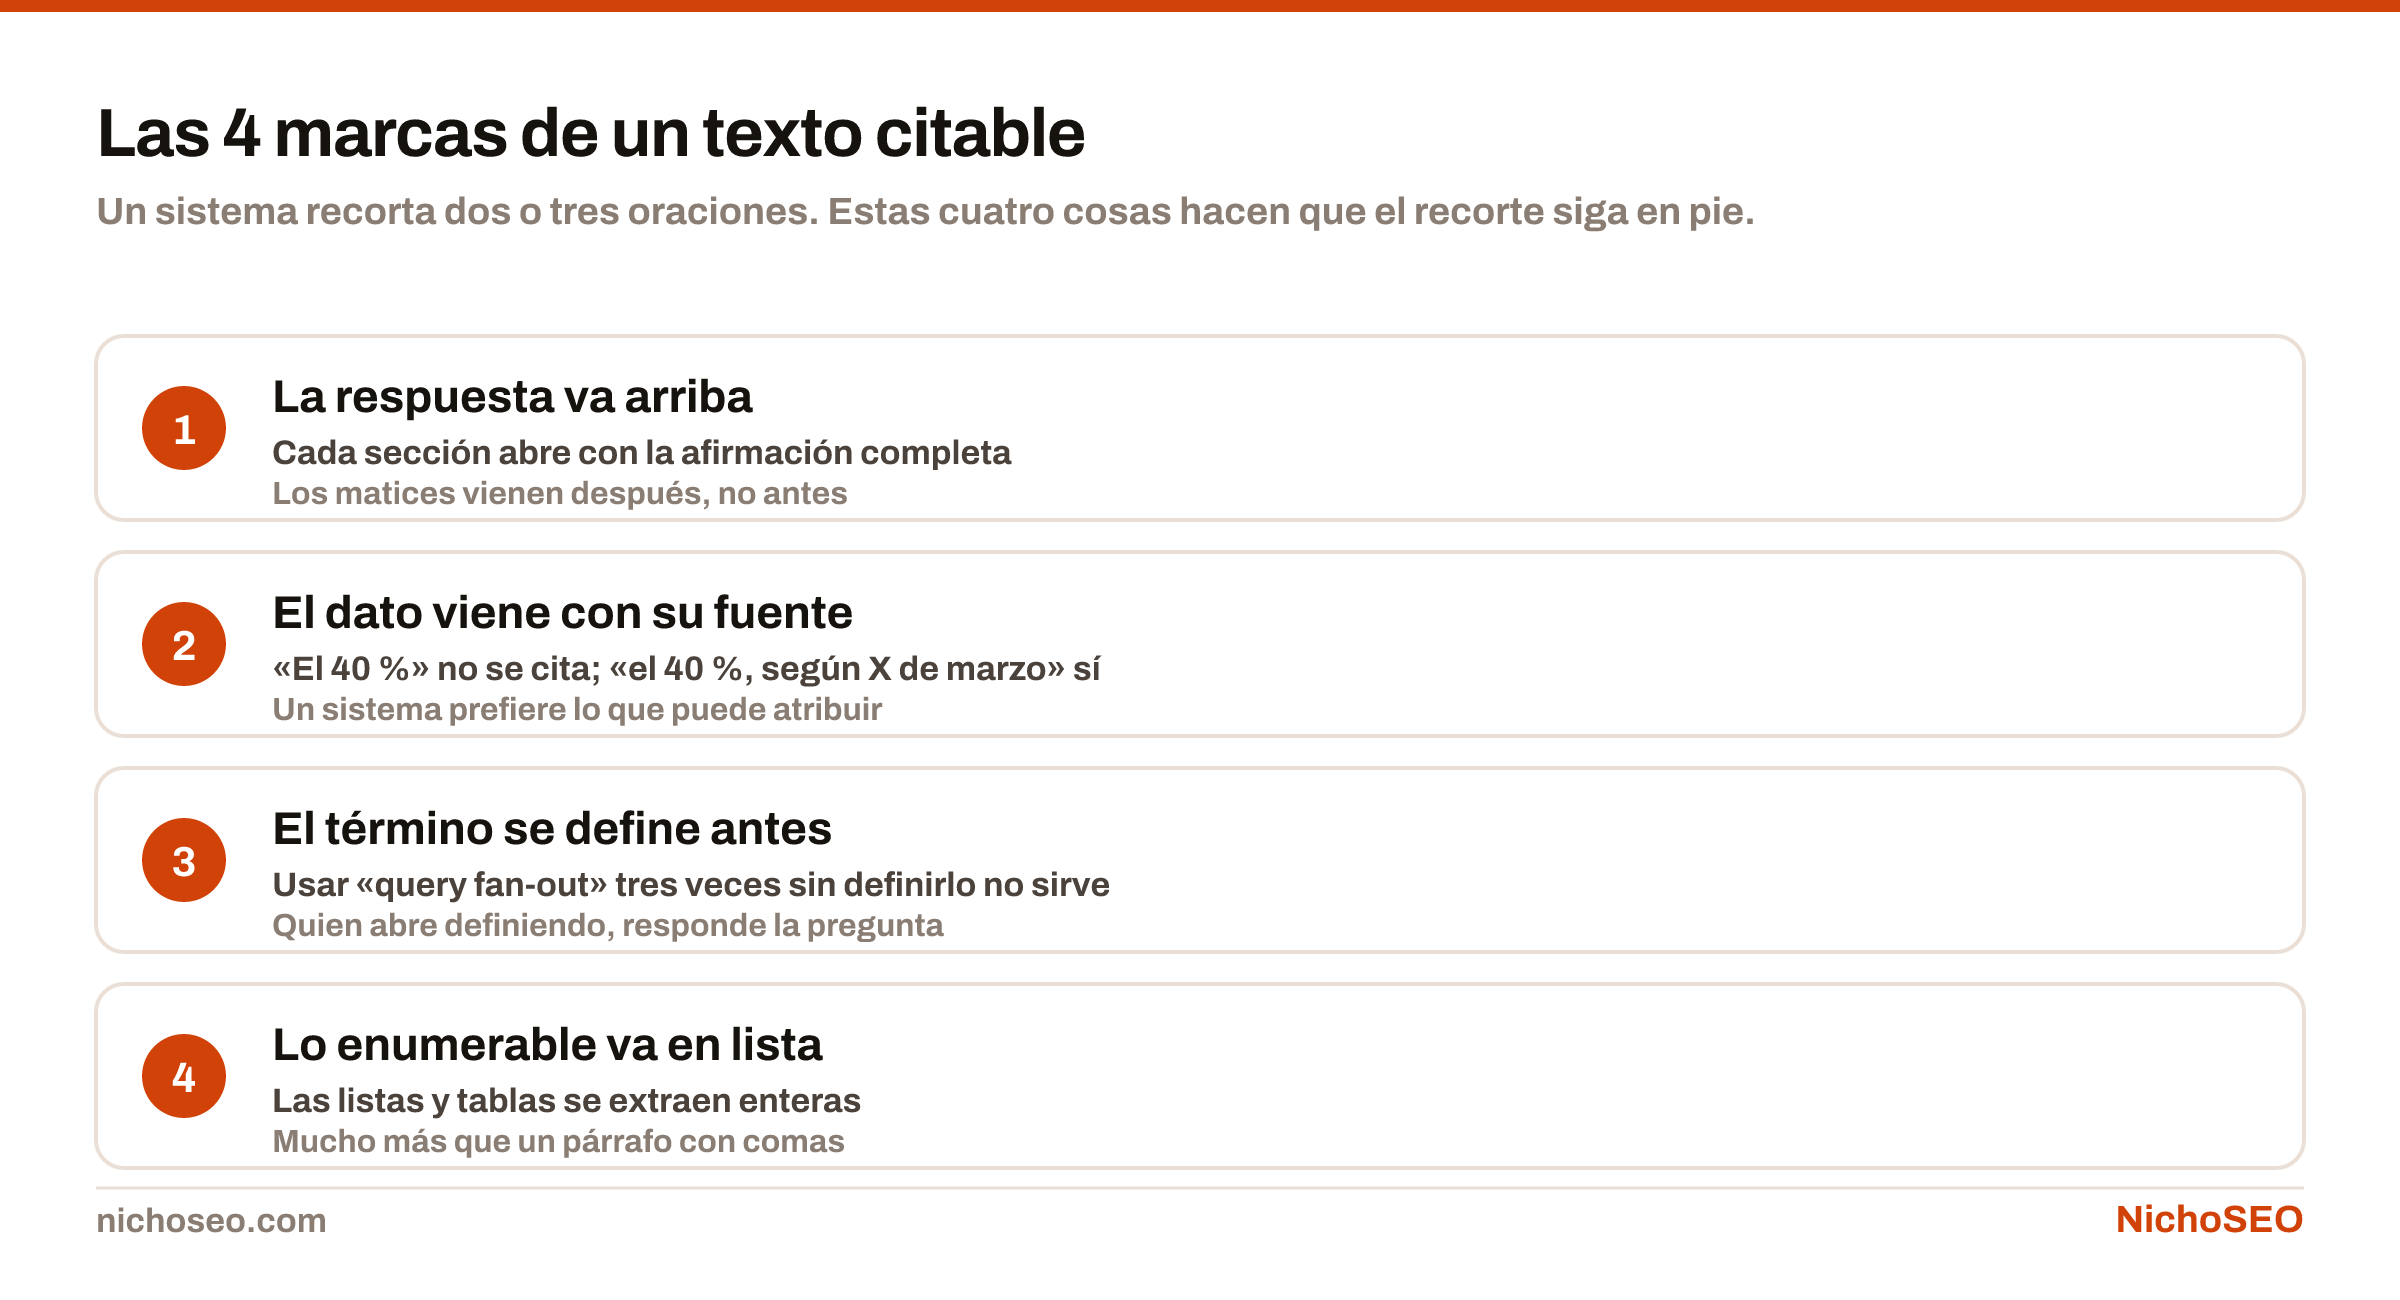
Visto así, una infografía aporta la primera marca —estructura— y se pierde la segunda, que es el dato extraíble. El texto al lado recupera esa segunda.
Cómo publicar datos propios para que se citen está en datos originales.
Qué pasa con los modelos que “ven” imágenes
Es la objeción razonable: varios modelos procesan imágenes directamente.
Es cierto, y cambia menos de lo que parece para este problema. Lo que un modelo puede describir de una imagen cuando alguien se la muestra no es lo mismo que lo que indexa de tu sitio para responder una consulta.
El pipeline que arma la respuesta —recuperar fuentes, leerlas, citarlas— trabaja sobre texto. Cómo funciona ese proceso está en RAG explicado para SEOs.
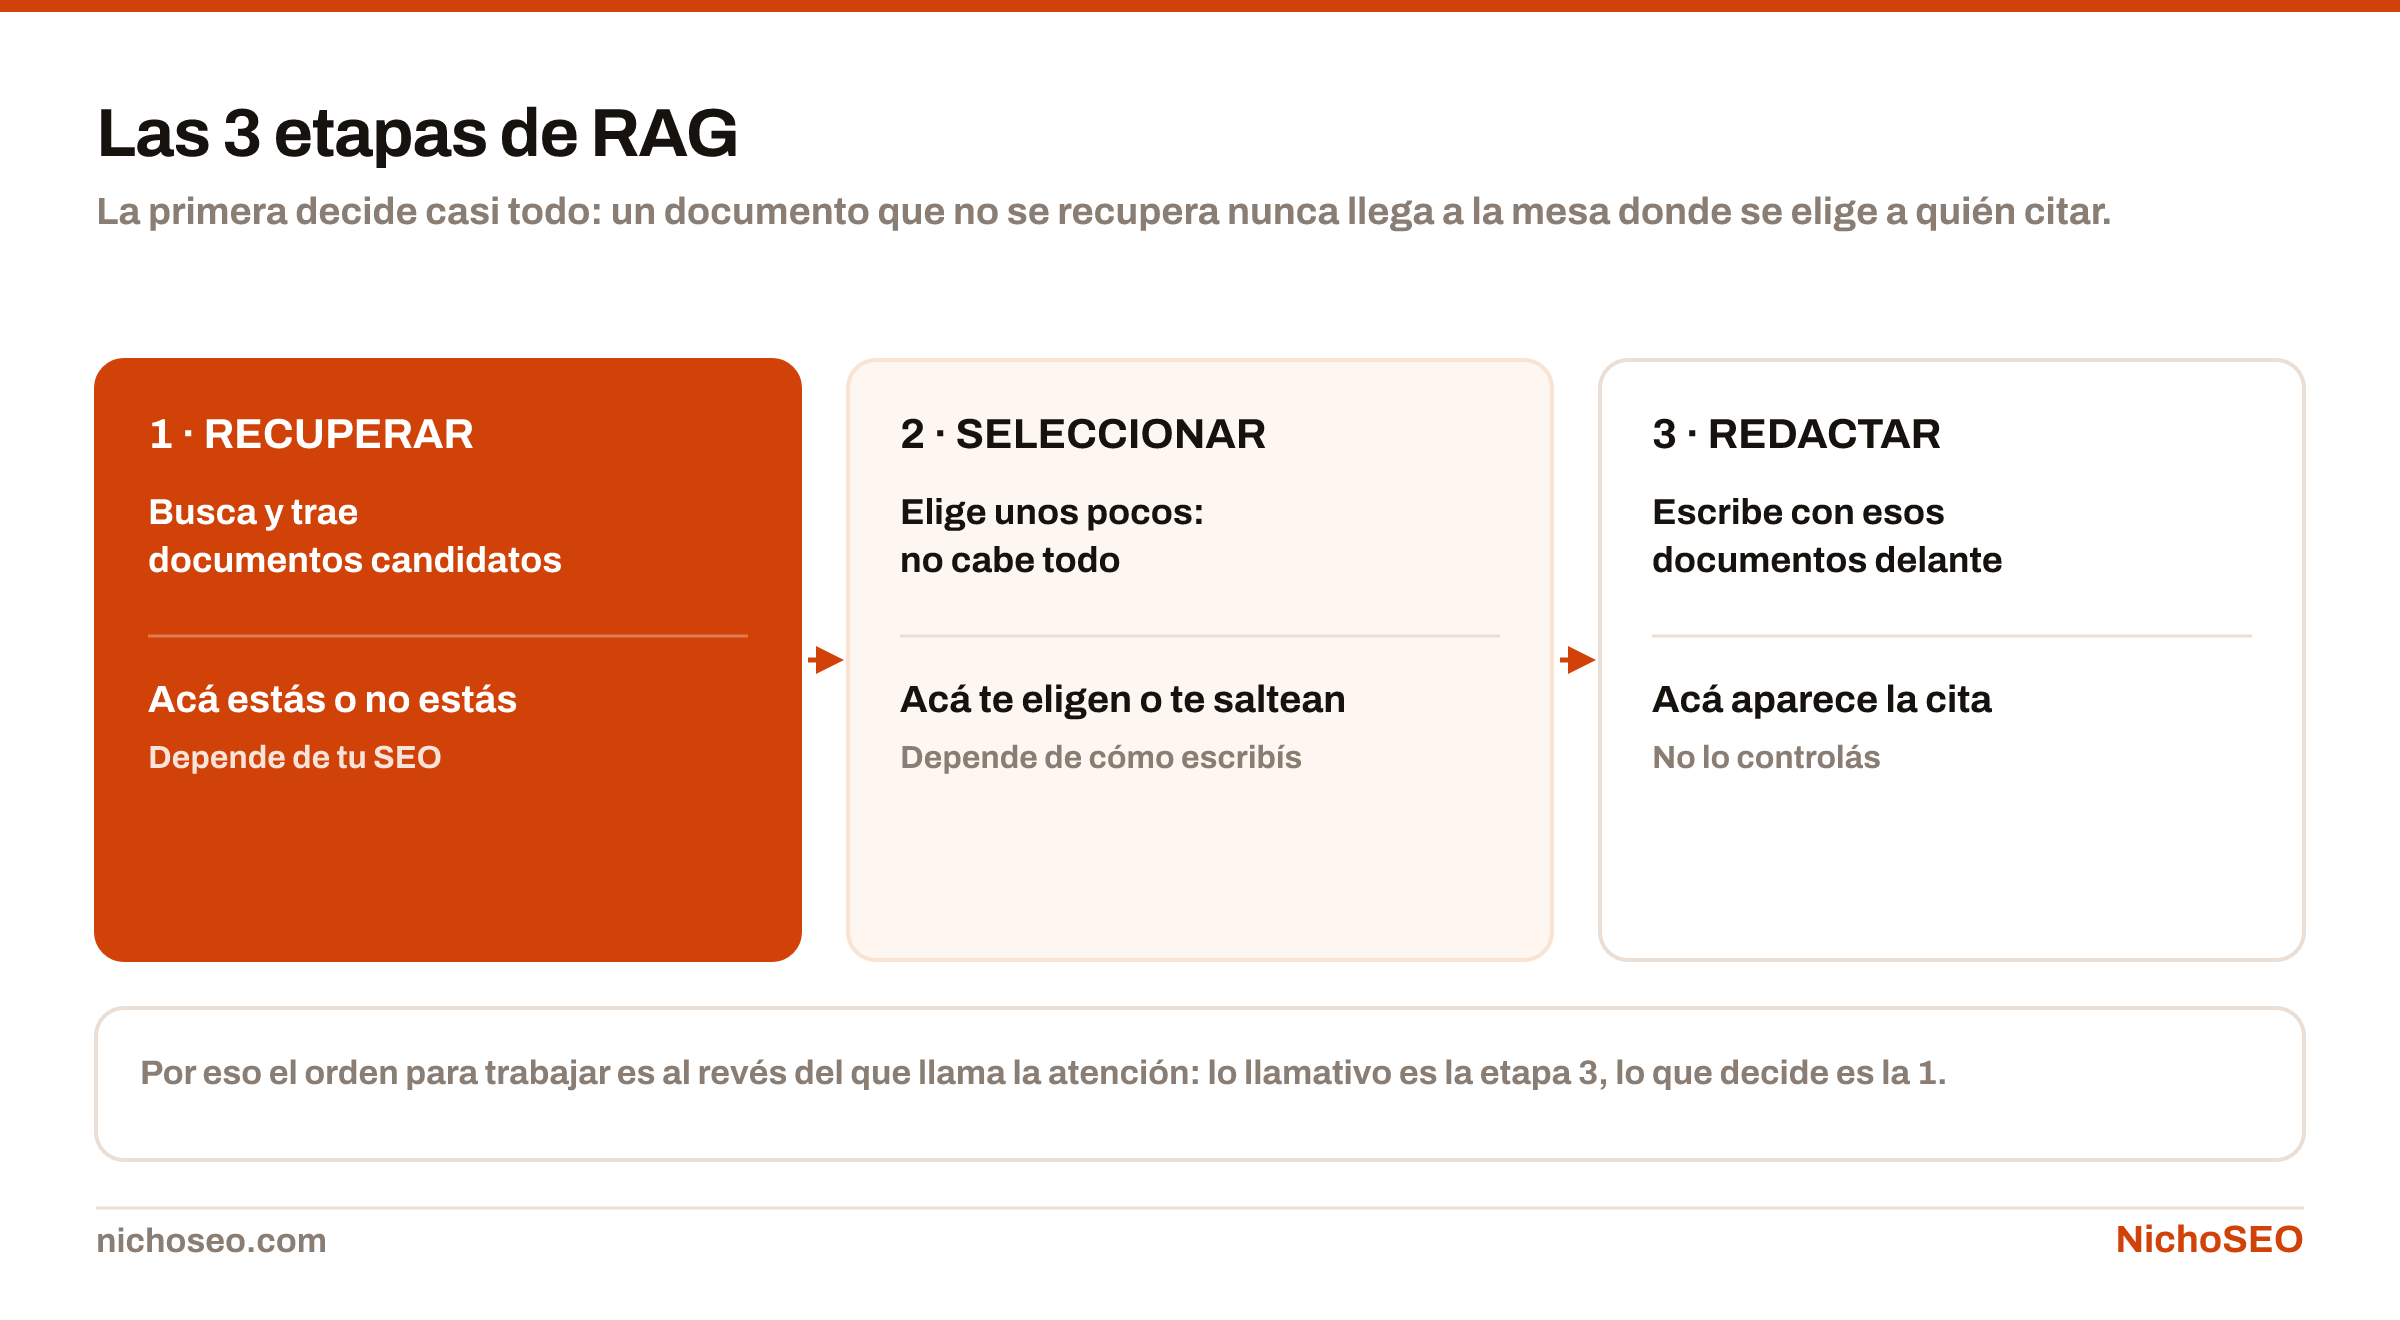
Así que la regla se mantiene, aunque por un motivo distinto del que se suele dar: no es que los modelos no puedan ver imágenes, es que la etapa en la que se decide a quién citar trabaja con texto.
La regla que resume todo
Todo lo que quieras que se cite tiene que existir como texto en una URL tuya.
El video, el podcast y la infografía son para las personas: son mejores que un artículo para explicar algunas cosas y para que alguien las comparta.
La transcripción, la tabla y el párrafo son para que te puedan citar. No compiten: van juntos, en la misma página.
Por dónde empezar
- Tomá tu contenido no textual con más tráfico o más escuchas. Uno solo.
- Publicalo en tu sitio como página, con el texto completo debajo.
- Revisá los nombres propios y las cifras de la transcripción automática. Es donde falla.
- Poné encabezados cada cinco o diez minutos de contenido.
- Repetí las cifras del gráfico en el texto, si hay gráficos.
Para el formato de la página, lo que hace que sea extraíble está en contenido citable, y el panorama de cómo cita cada motor —y cuánto tráfico deja cada formato— en cómo citan las IAs.
La documentación de YouTube sobre cómo subir tus propios subtítulos, que es el paso que más rinde de toda esta entrada, está en su centro de ayuda.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Siguiente en el manual