
Puntos clave
- Google lee una página en dos pasadas: el HTML que llega, y después el JavaScript.
- La segunda pasada entra en una cola sin plazo publicado: puede tardar horas o días.
- Lo que solo exista después de ejecutar JavaScript existe más tarde, o no existe.
- Se comprueba en un minuto con curl: si el texto no está en la respuesta, no está en la pasada 1.
- «Se ve bien en mi navegador» no prueba nada, porque tu navegador siempre ejecuta el JavaScript.
Todo el tema se resume en qué dejás para cada pasada.
Las dos pasadas
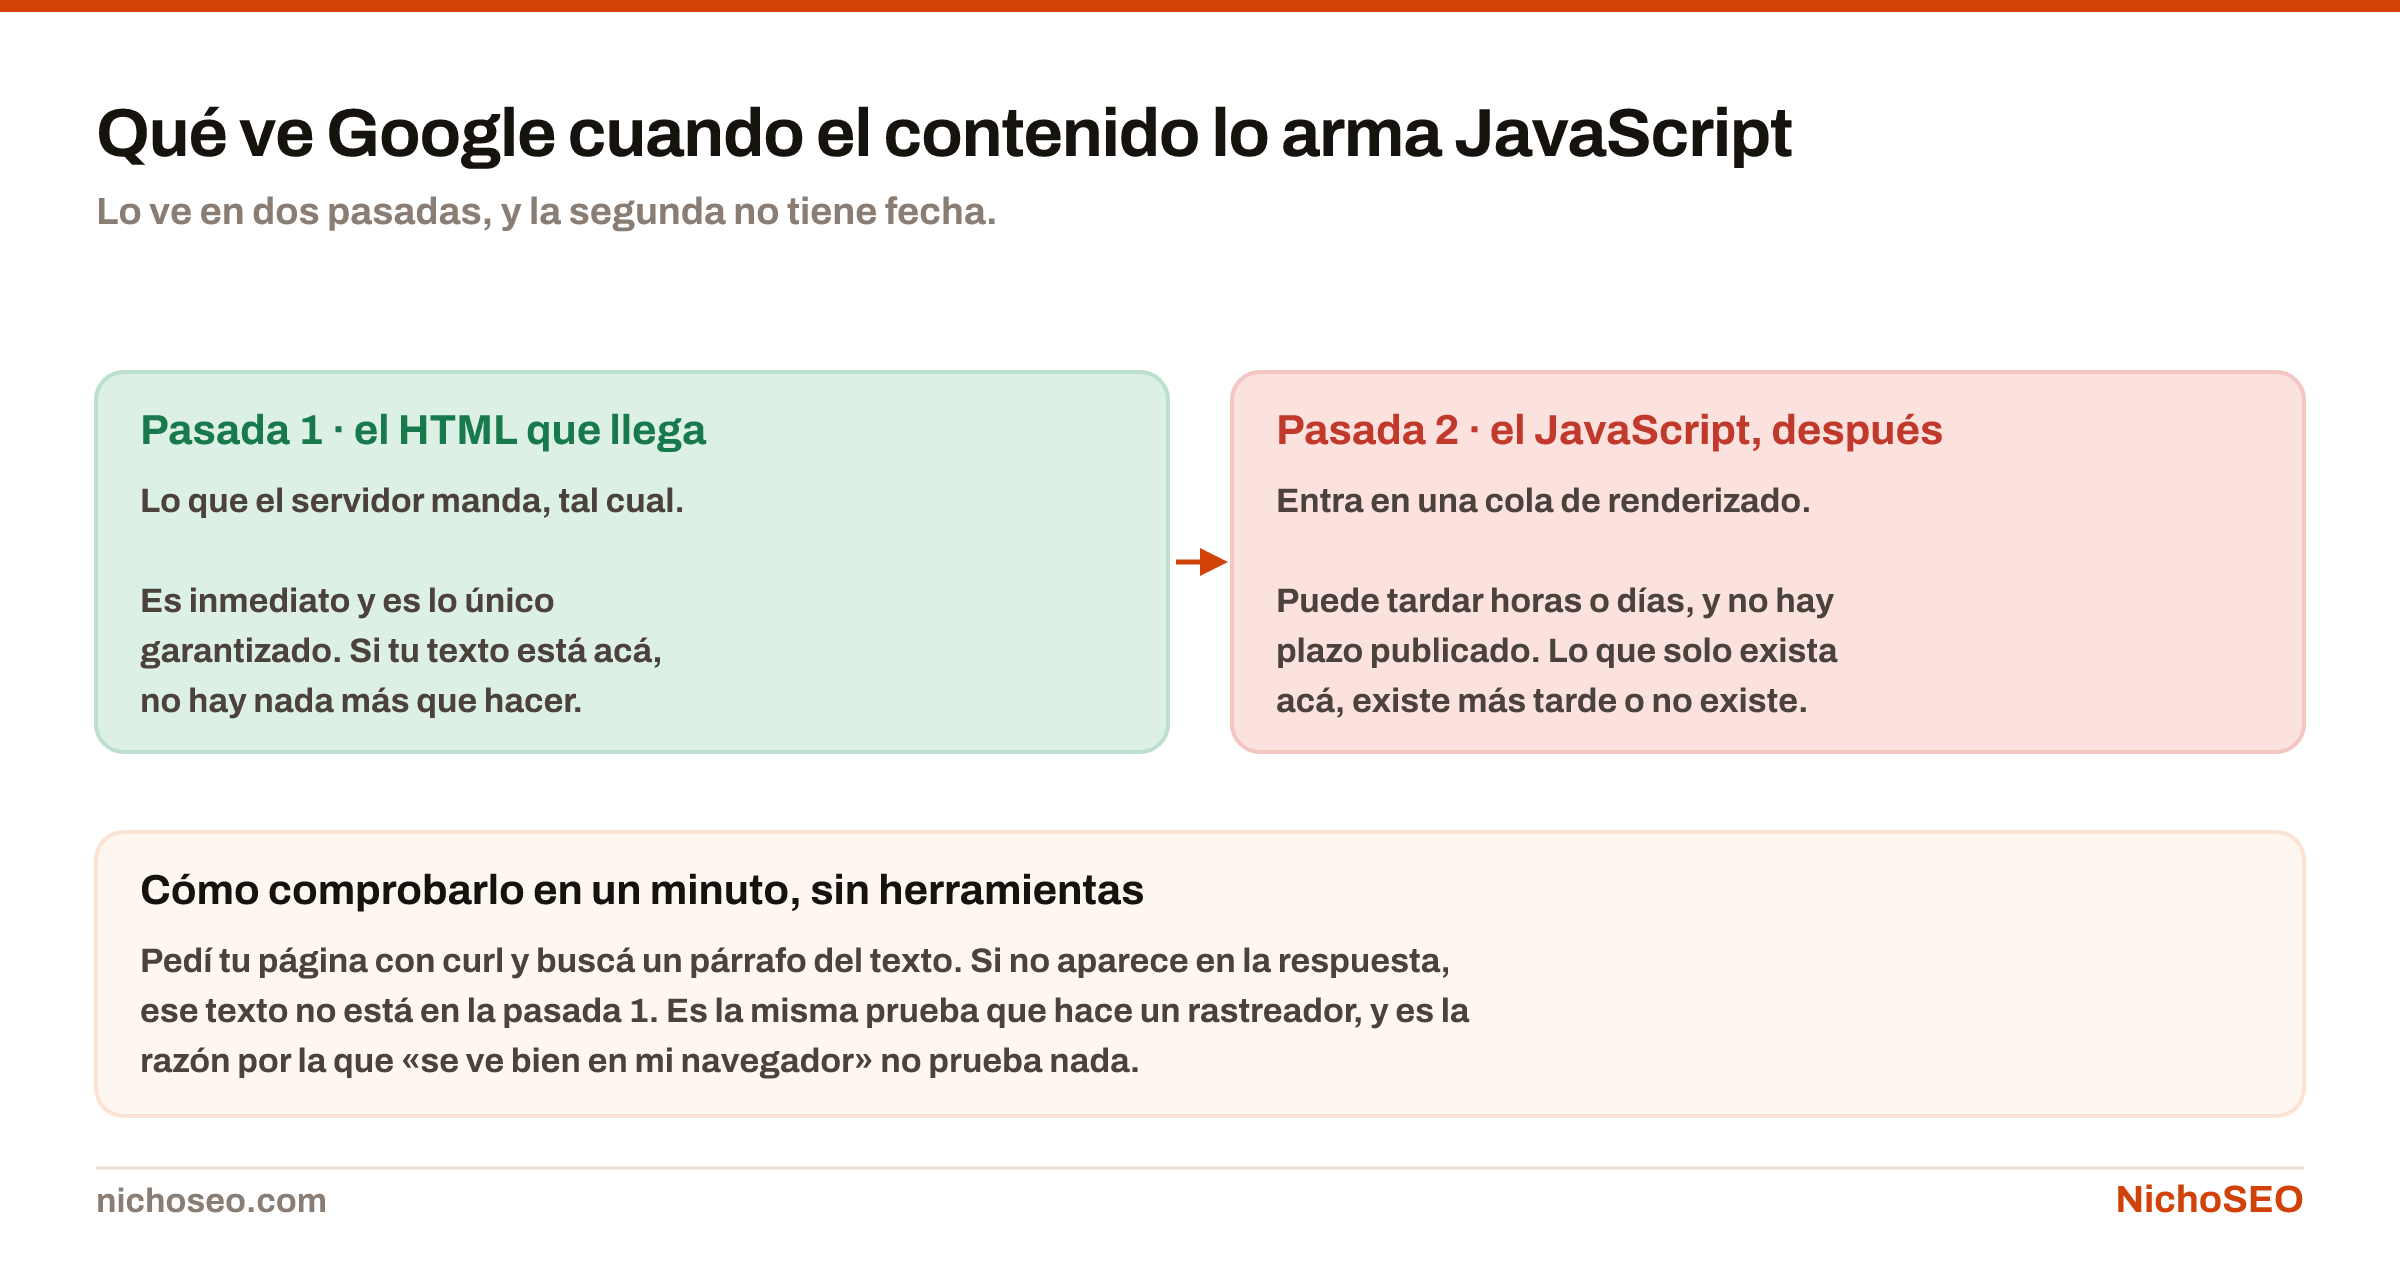
La primera es inmediata y es lo único seguro: el HTML que devuelve tu servidor, tal como llega.
La segunda entra en una cola. Google ejecuta el JavaScript cuando tiene capacidad, y eso puede ser en minutos o en días. No hay un plazo publicado, y depende de cuánta prioridad le dé a tu sitio.
La consecuencia práctica: lo que solo exista después de ejecutar JavaScript, existe más tarde o no existe. Para una página que cambia de precio todos los días, «más tarde» puede equivaler a nunca.
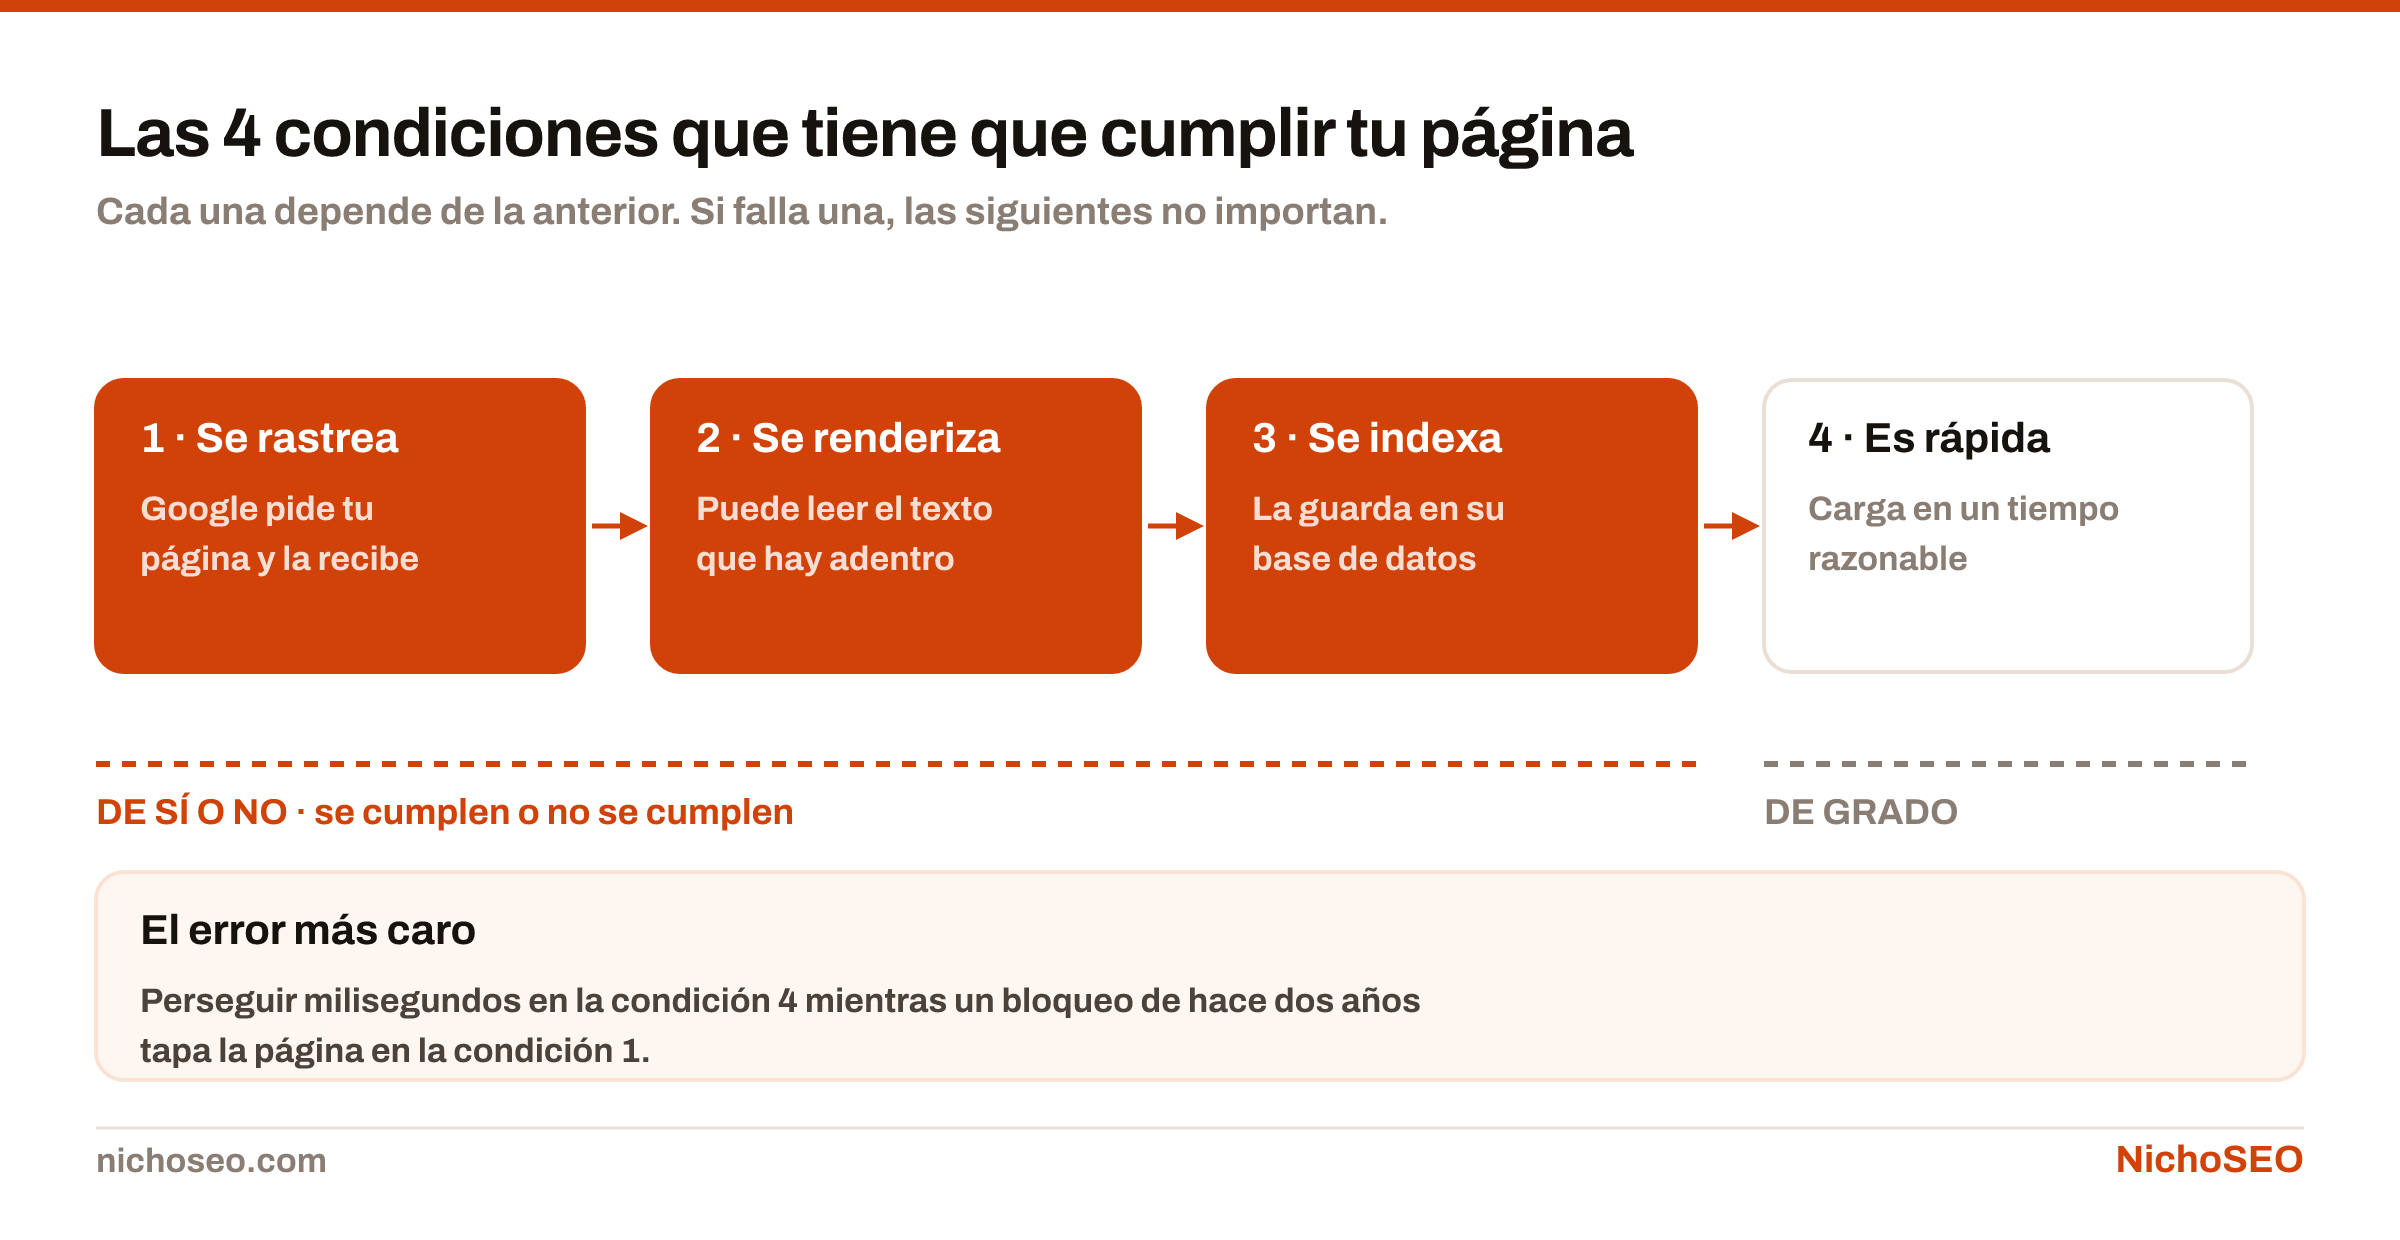
Esto encaja con las cuatro condiciones que tiene que cumplir una página, y es la segunda:
Cómo comprobar qué ve la primera pasada
Un minuto y sin instalar nada:
curl -s https://tudominio.com/tu-pagina/ | grep -c "una frase de tu texto"Si devuelve 0, esa frase no está en el HTML inicial. Es exactamente lo que ve un rastreador en la primera pasada.
Vale la pena insistir en por qué esto no se puede probar en el navegador: tu navegador siempre ejecuta el JavaScript. Ver la página bien en pantalla no dice nada sobre la primera pasada. Ni siquiera «ver código fuente» alcanza en todos los casos.
Pruebas que dicen algo
- curl y buscar el texto en la respuesta
- Desactivar JavaScript en el navegador y recargar
- La herramienta de inspección de URL de Search Console
- Comparar el HTML inicial con lo que ves en pantalla
Pruebas que no
- «Se ve bien cuando entro»
- Inspeccionar elementos, que muestra el DOM ya construido
- Que la página esté indexada, que puede ser de la pasada 2
- Preguntarle al desarrollador si «está bien hecho»
La herramienta de inspección de URL de Search Console muestra las dos cosas —el HTML que recibió y el resultado renderizado—, y es la comprobación más completa que hay gratis. Dónde está y qué más informa está en la guía de Search Console.
Qué conviene que esté en la primera pasada
No hace falta renunciar a JavaScript. Hace falta elegir qué va en cada pasada.
Qué no conviene dejar para la segunda
Los enlaces merecen un párrafo, porque es el error más silencioso. Un menú que se arma con JavaScript y no deja etiquetas <a href> en el HTML inicial significa que, en la primera pasada, tu sitio es una sola página sin salidas.
Y hay una variante peor: los enlaces hechos con onclick sobre un <div>. Esos no son enlaces para nadie, ni en la primera pasada ni en la segunda.
Las tres formas de resolverlo
Ordenadas por lo que cuestan.
Renderizado en el servidor. El servidor arma el HTML completo y lo manda listo. Es la solución que elimina el problema: no hay segunda pasada que esperar. Cualquier marco moderno lo ofrece.
Generación estática. Las páginas se compilan una vez, al publicar, y quedan como archivos. Es lo mismo pero más barato de servir, y sirve cuando el contenido no cambia por visitante.
Renderizado dinámico. Detectar al rastreador y mandarle una versión ya armada. Funciona, es más frágil de mantener y Google lo desaconseja como solución permanente.
Lo que no es solución: pedirle a Google que sea más rápido, o suponer que ya lo resolvió porque la página aparece indexada. Que aparezca puede ser resultado de la pasada 2, con el retraso incluido.
Los 5 síntomas de que hay un problema de JavaScript
Sin mirar código, estos son los que se ven desde afuera:
- Search Console indexa la página pero no recibe impresiones para el contenido que sí está en pantalla.
- El informe de indexación dice «Rastreada, no indexada por ahora» en páginas que tienen contenido bueno.
- Las páginas nuevas tardan semanas en aparecer, cuando las viejas aparecían en días.
- Search Console lista menos páginas de las que existen, porque no encontró los enlaces.
- El title que aparece en los resultados no es el que pusiste, porque el que pusiste se asigna por JavaScript.
El primero y el quinto son los más claros. Para el quinto sirve comparar: lo que Google muestra, contra lo que debería mostrar según el simulador de SERP. Si no se parecen, el title no llegó. El segundo puede tener otras causas, y el diagnóstico completo está en cómo indexar una página.
Qué pasa con los motores de IA
Peor que con Google, y conviene saberlo.
Los rastreadores de los motores generativos, en general, no ejecutan JavaScript. Leen el HTML que llega y con eso trabajan. No hay segunda pasada.
Eso convierte lo que con Google es un retraso en una ausencia total: si tu texto solo existe después de ejecutar JavaScript, para esos sistemas tu página está vacía.
Es una de las comprobaciones de la auditoría de GEO por ese motivo: está en la auditoría de GEO.
El resumen práctico
Una regla que resuelve el 90 % de los casos: si lo pedís con curl y el texto no aparece, hay trabajo.
No significa reescribir el sitio. Significa mover el contenido principal, los enlaces y las etiquetas del <head> a la primera pasada, y dejar en la segunda lo que puede esperar.
La documentación de Google sobre cómo procesa JavaScript, con el detalle de las dos fases, está en su guía de JavaScript SEO.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Siguiente en el manual