

Puntos clave
- El robots.txt dice qué puede pedir un rastreador, no qué puede aparecer en los resultados.
- Bloquear una página no la saca del índice: le impide a Google leer el noindex que sí la sacaría.
- No sirve para esconder nada: el archivo es público y lista justamente lo que ocultás.
- Es una convención de buena fe: los bots que no quieren respetarlo, no lo respetan.
- En la mayoría de los sitios el archivo correcto tiene tres líneas.
Esa distinción parece un tecnicismo y es el origen de casi todos los problemas que causa este archivo.
Qué hace y qué no
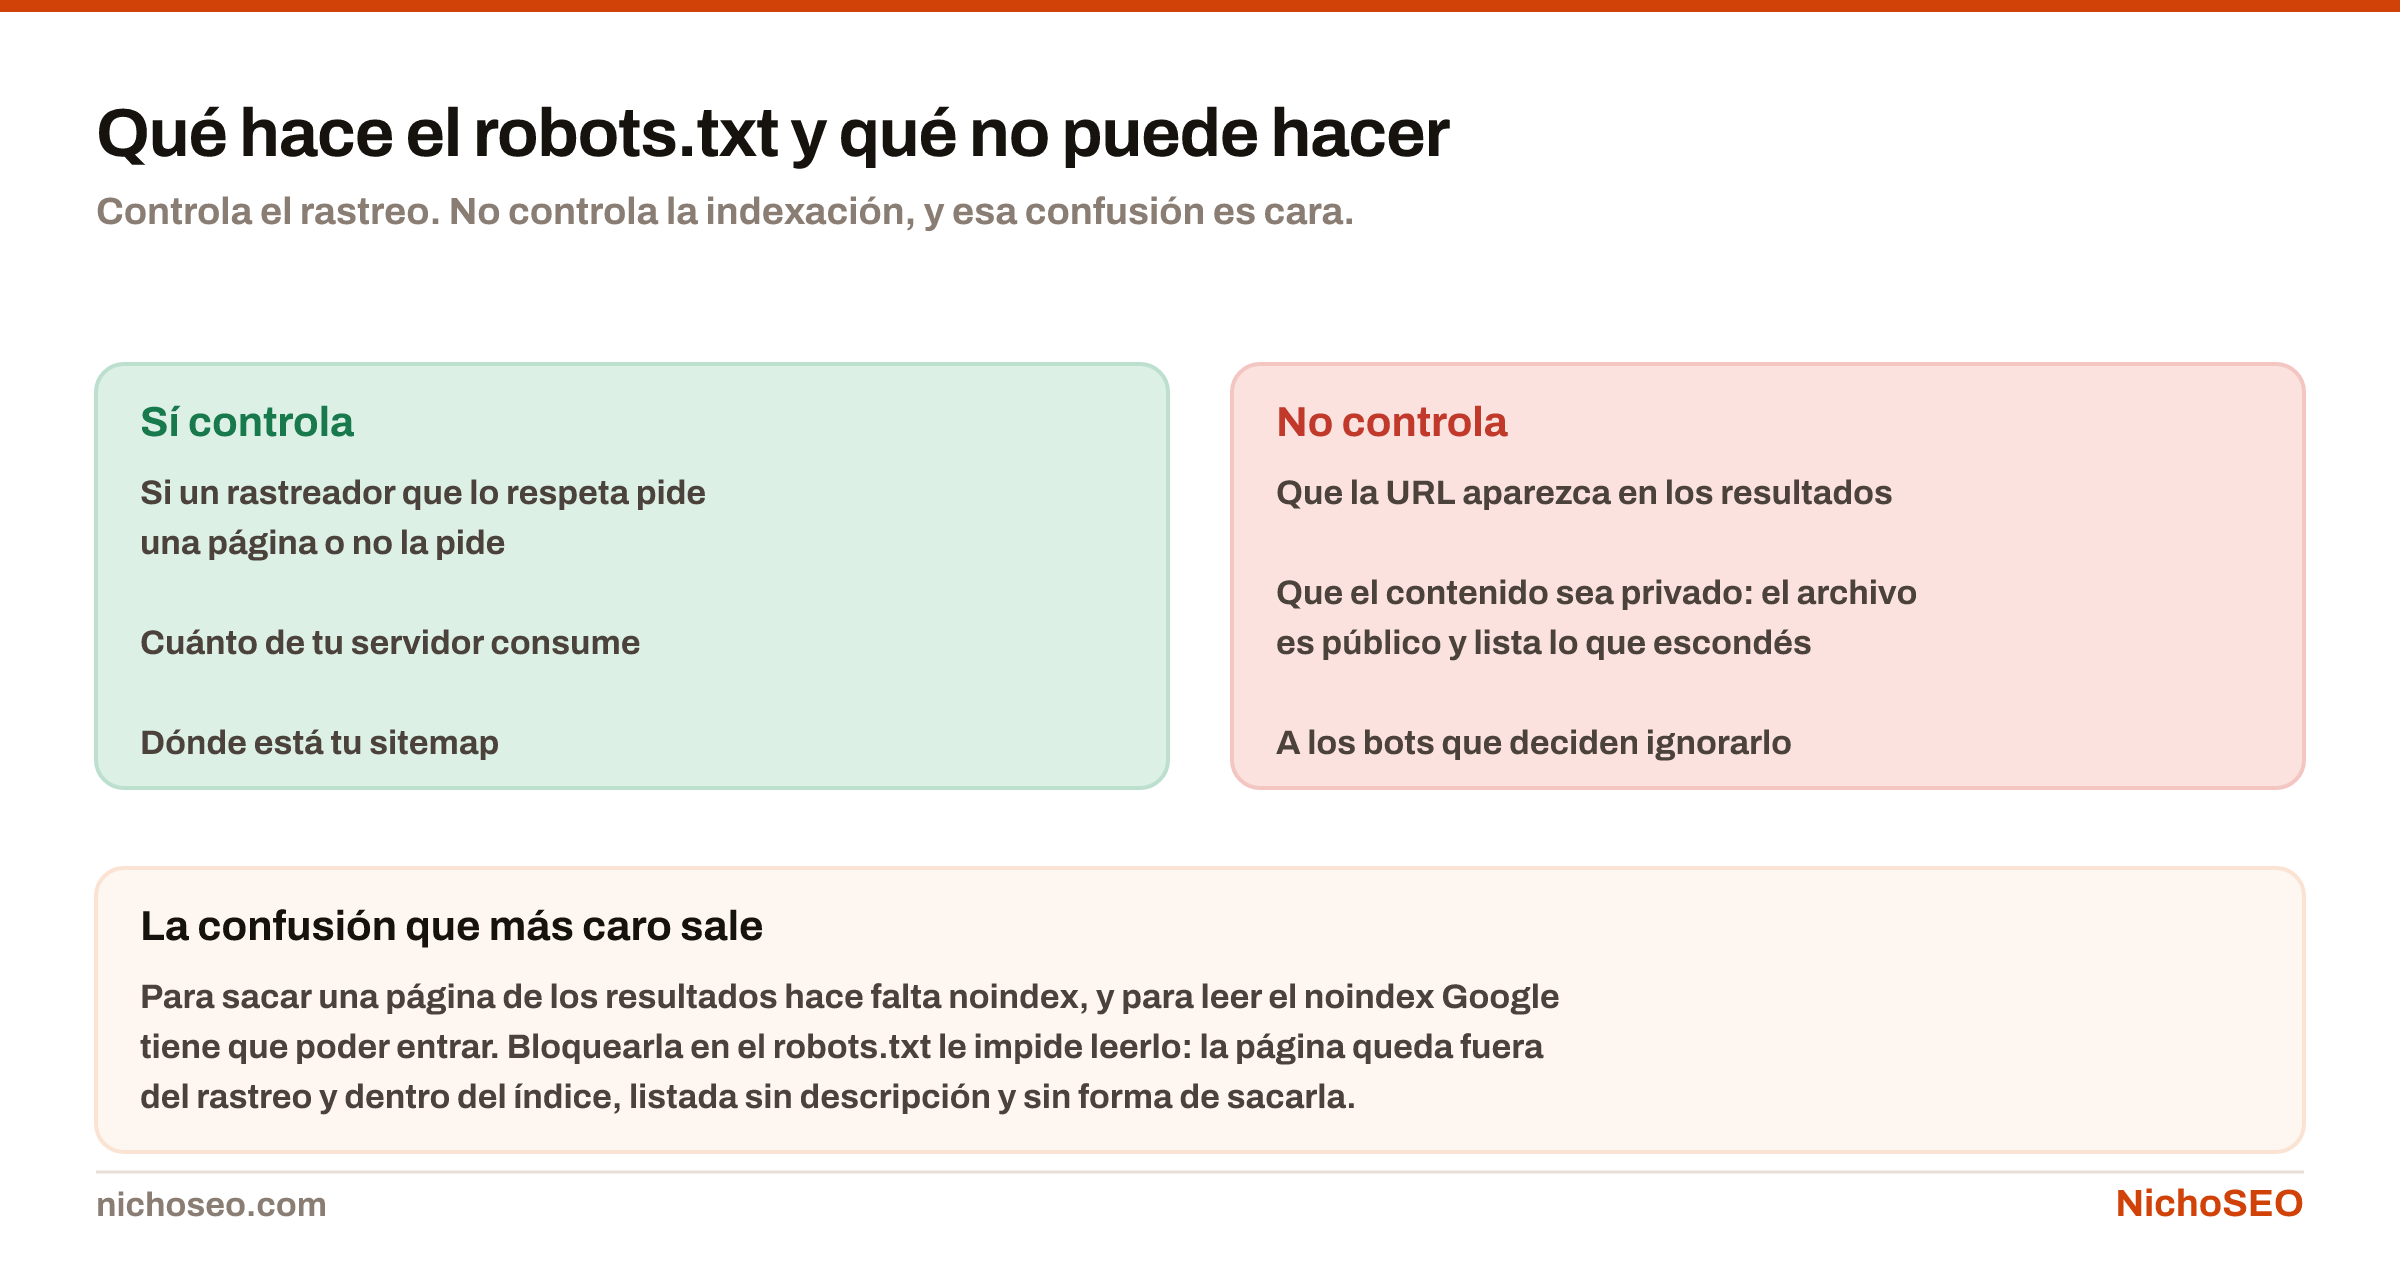
Las tres cosas de la derecha son las que más sorprenden, y conviene tomarlas de a una.
No saca páginas de los resultados. Una URL bloqueada puede seguir apareciendo si algún enlace apunta a ella. Google no puede leer su contenido, así que la muestra sin descripción, con un texto del tipo «No hay información disponible para esta página». Está en el índice y no se puede sacar, porque la instrucción que la sacaría está adentro de una página que Google no puede abrir.
No esconde nada. El archivo vive en tudominio.com/robots.txt y lo puede leer cualquiera. Escribir Disallow: /admin-secreto/ es publicar la dirección de lo que querías ocultar. Lo privado se protege con una contraseña, no con una convención.
No obliga a nadie. Es un acuerdo de buena fe. Los buscadores grandes lo respetan; un raspador que copia contenido, no. Si algo no puede leerse, no alcanza con pedirlo.
Lo que sí resuelve
Dos cosas, y las dos importan en sitios grandes.
Ahorrar rastreo donde no aporta. Un listado con veinte filtros combinables genera miles de URLs con el mismo contenido. Bloquear ese patrón evita que el rastreador gaste tiempo ahí en lugar de en tus páginas nuevas.
Declarar dónde está el sitemap. Una línea, y es la forma más simple de que cualquier buscador lo encuentre sin que se lo envíes. Qué incluir en él está en sitemap.xml.
Bloquear o desindexar: el árbol de decisión
Es la pregunta práctica, y tiene una respuesta corta.
Querés que no aparezca en los resultados
- Poné noindex en la página
- Dejala accesible al rastreador
- Esperá a que la vuelva a visitar
- Recién ahí, si querés, bloqueala
Querés que no la rastreen
- Bloqueala en el robots.txt
- Sirve para ahorrar rastreo, no para ocultar
- Solo si no te importa que la URL siga listada
- Nunca sobre una página que ya está indexada
El orden de la izquierda es lo que casi nadie hace. Poner noindex y bloquear al mismo tiempo parece más seguro y es lo contrario: el bloqueo impide leer el noindex, así que la página queda listada para siempre.
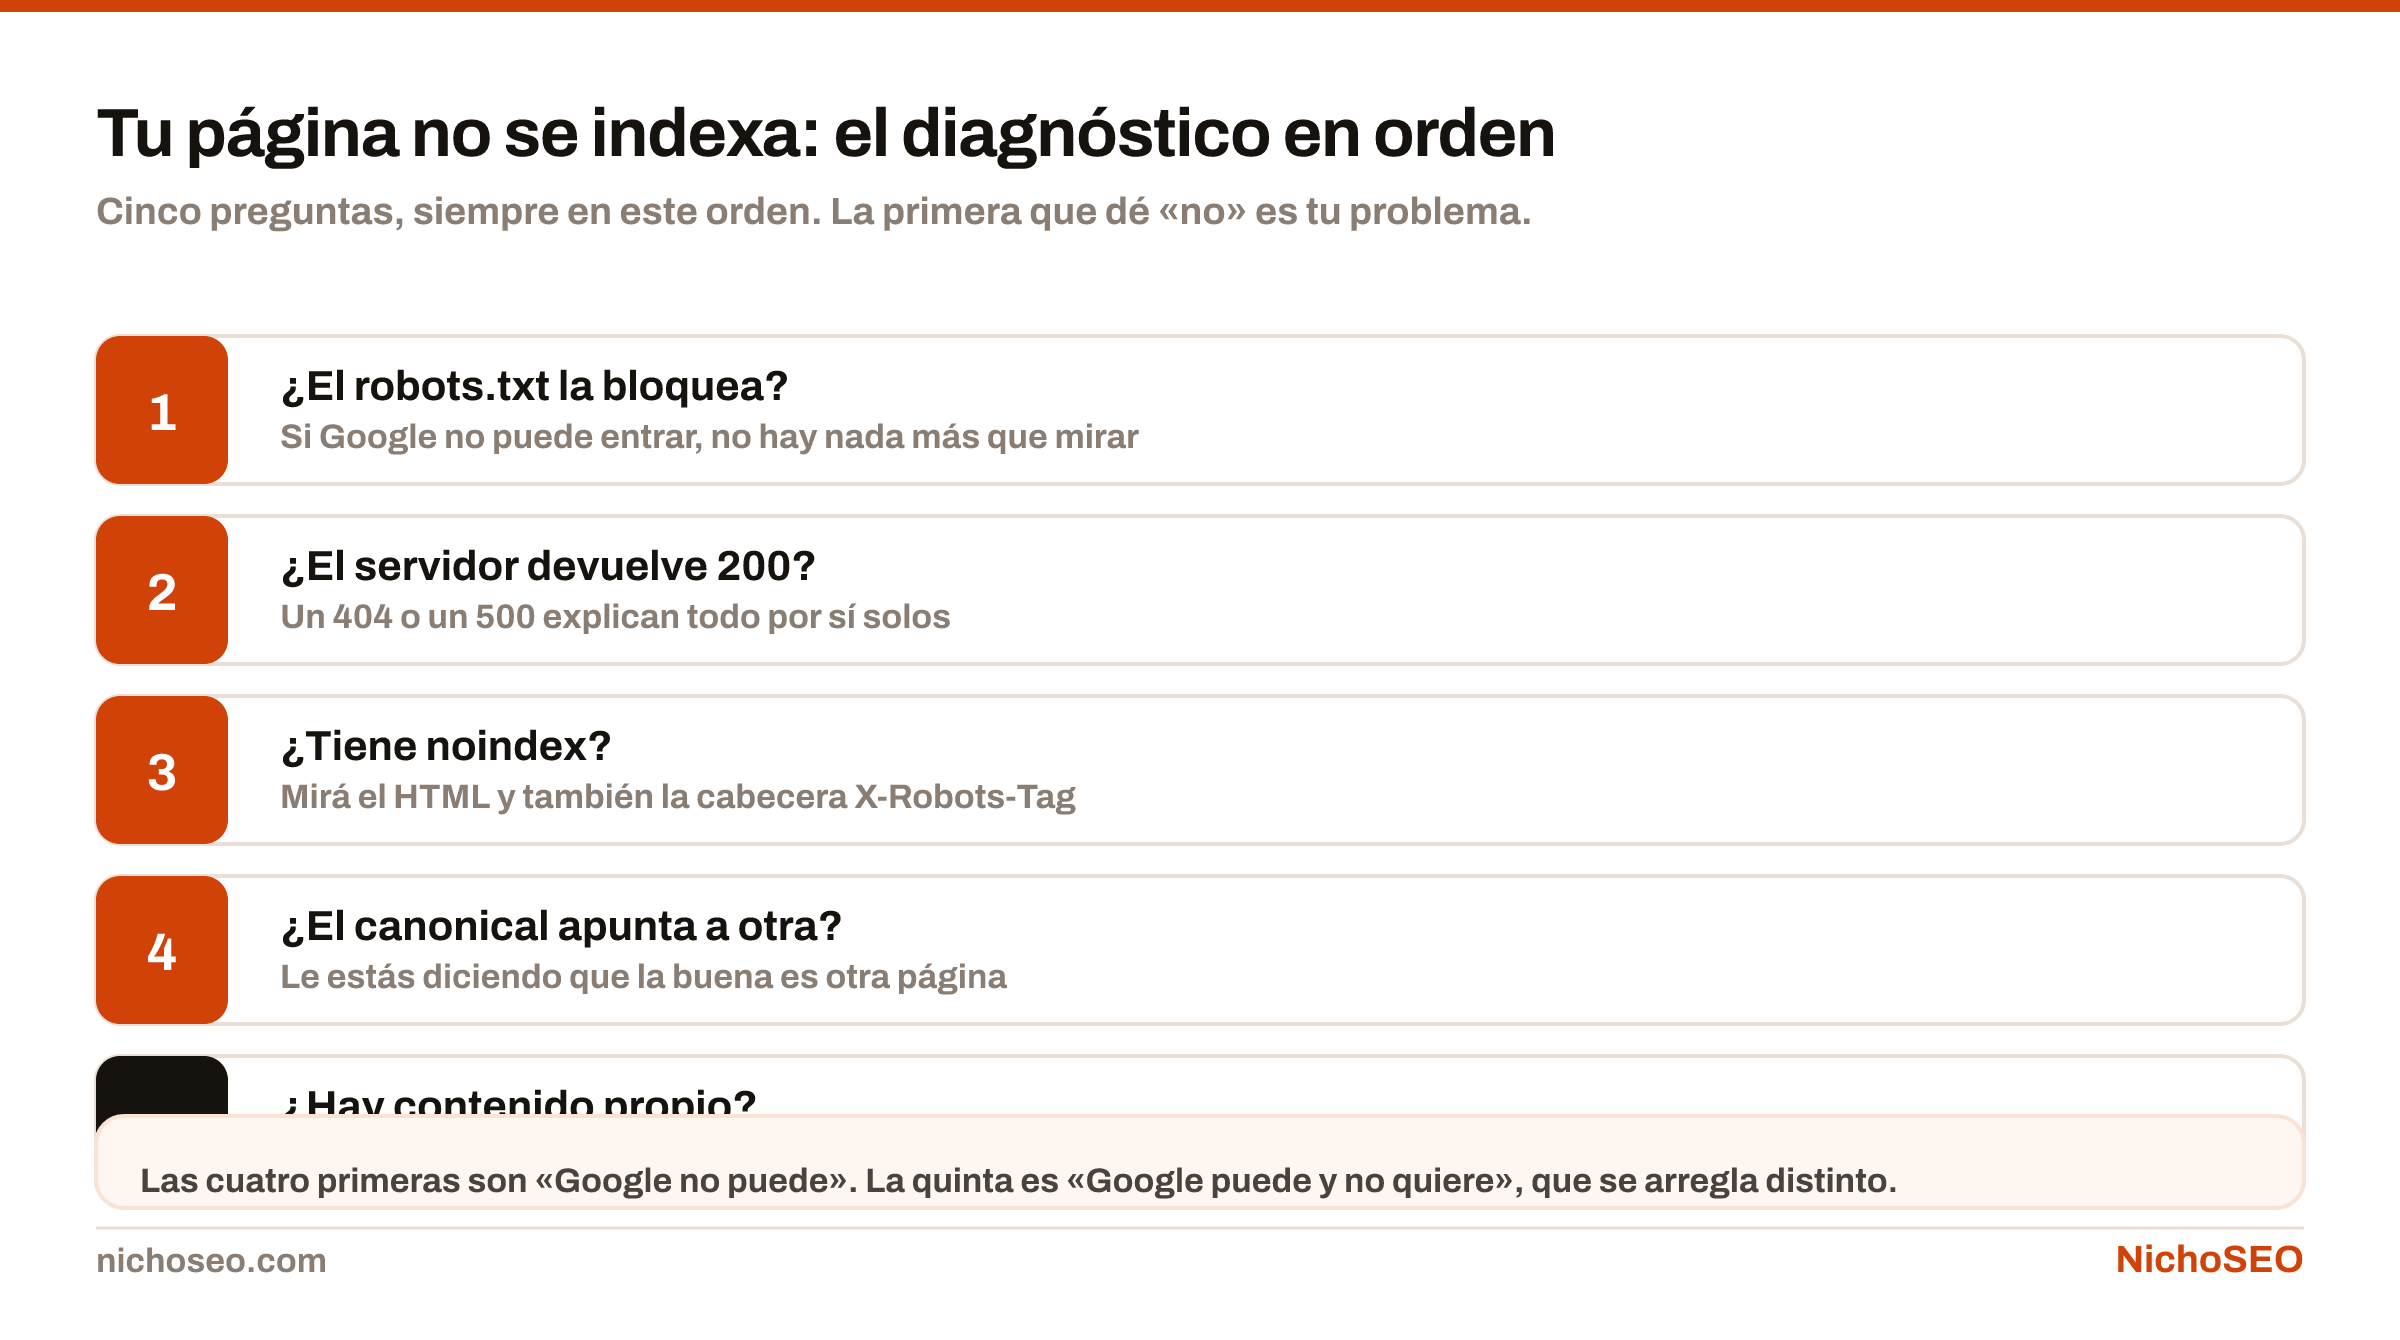
El diagnóstico completo de una página que no se indexa —o que se indexa cuando no querías— está en cómo indexar una página.
El archivo que sirve para casi cualquier sitio
Tres líneas y no hace falta más:
User-agent: *
Allow: /

Sitemap: https://tudominio.com/sitemap.xml
Eso es todo. Un sitio chico no gana nada bloqueando cosas, y cada línea de más es una oportunidad de bloquear sin querer algo que importaba.
Si tenés un panel de administración o un carrito, se agregan las rutas concretas:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /carrito/
Disallow: /*?filtro=

Sitemap: https://tudominio.com/sitemap.xml
Un detalle que se pasa por alto: las reglas se evalúan por especificidad, no por orden. Una Allow más específica gana sobre una Disallow más general, en todos los buscadores grandes.
Los rastreadores de IA son un caso aparte
Acá el archivo sí decide algo importante, y decide mal por omisión.
Los rastreadores de los motores generativos se controlan con este mismo archivo, pero no todos hacen lo mismo: unos se llevan texto para entrenar modelos futuros y otros leen tu página para responder una pregunta ahora.
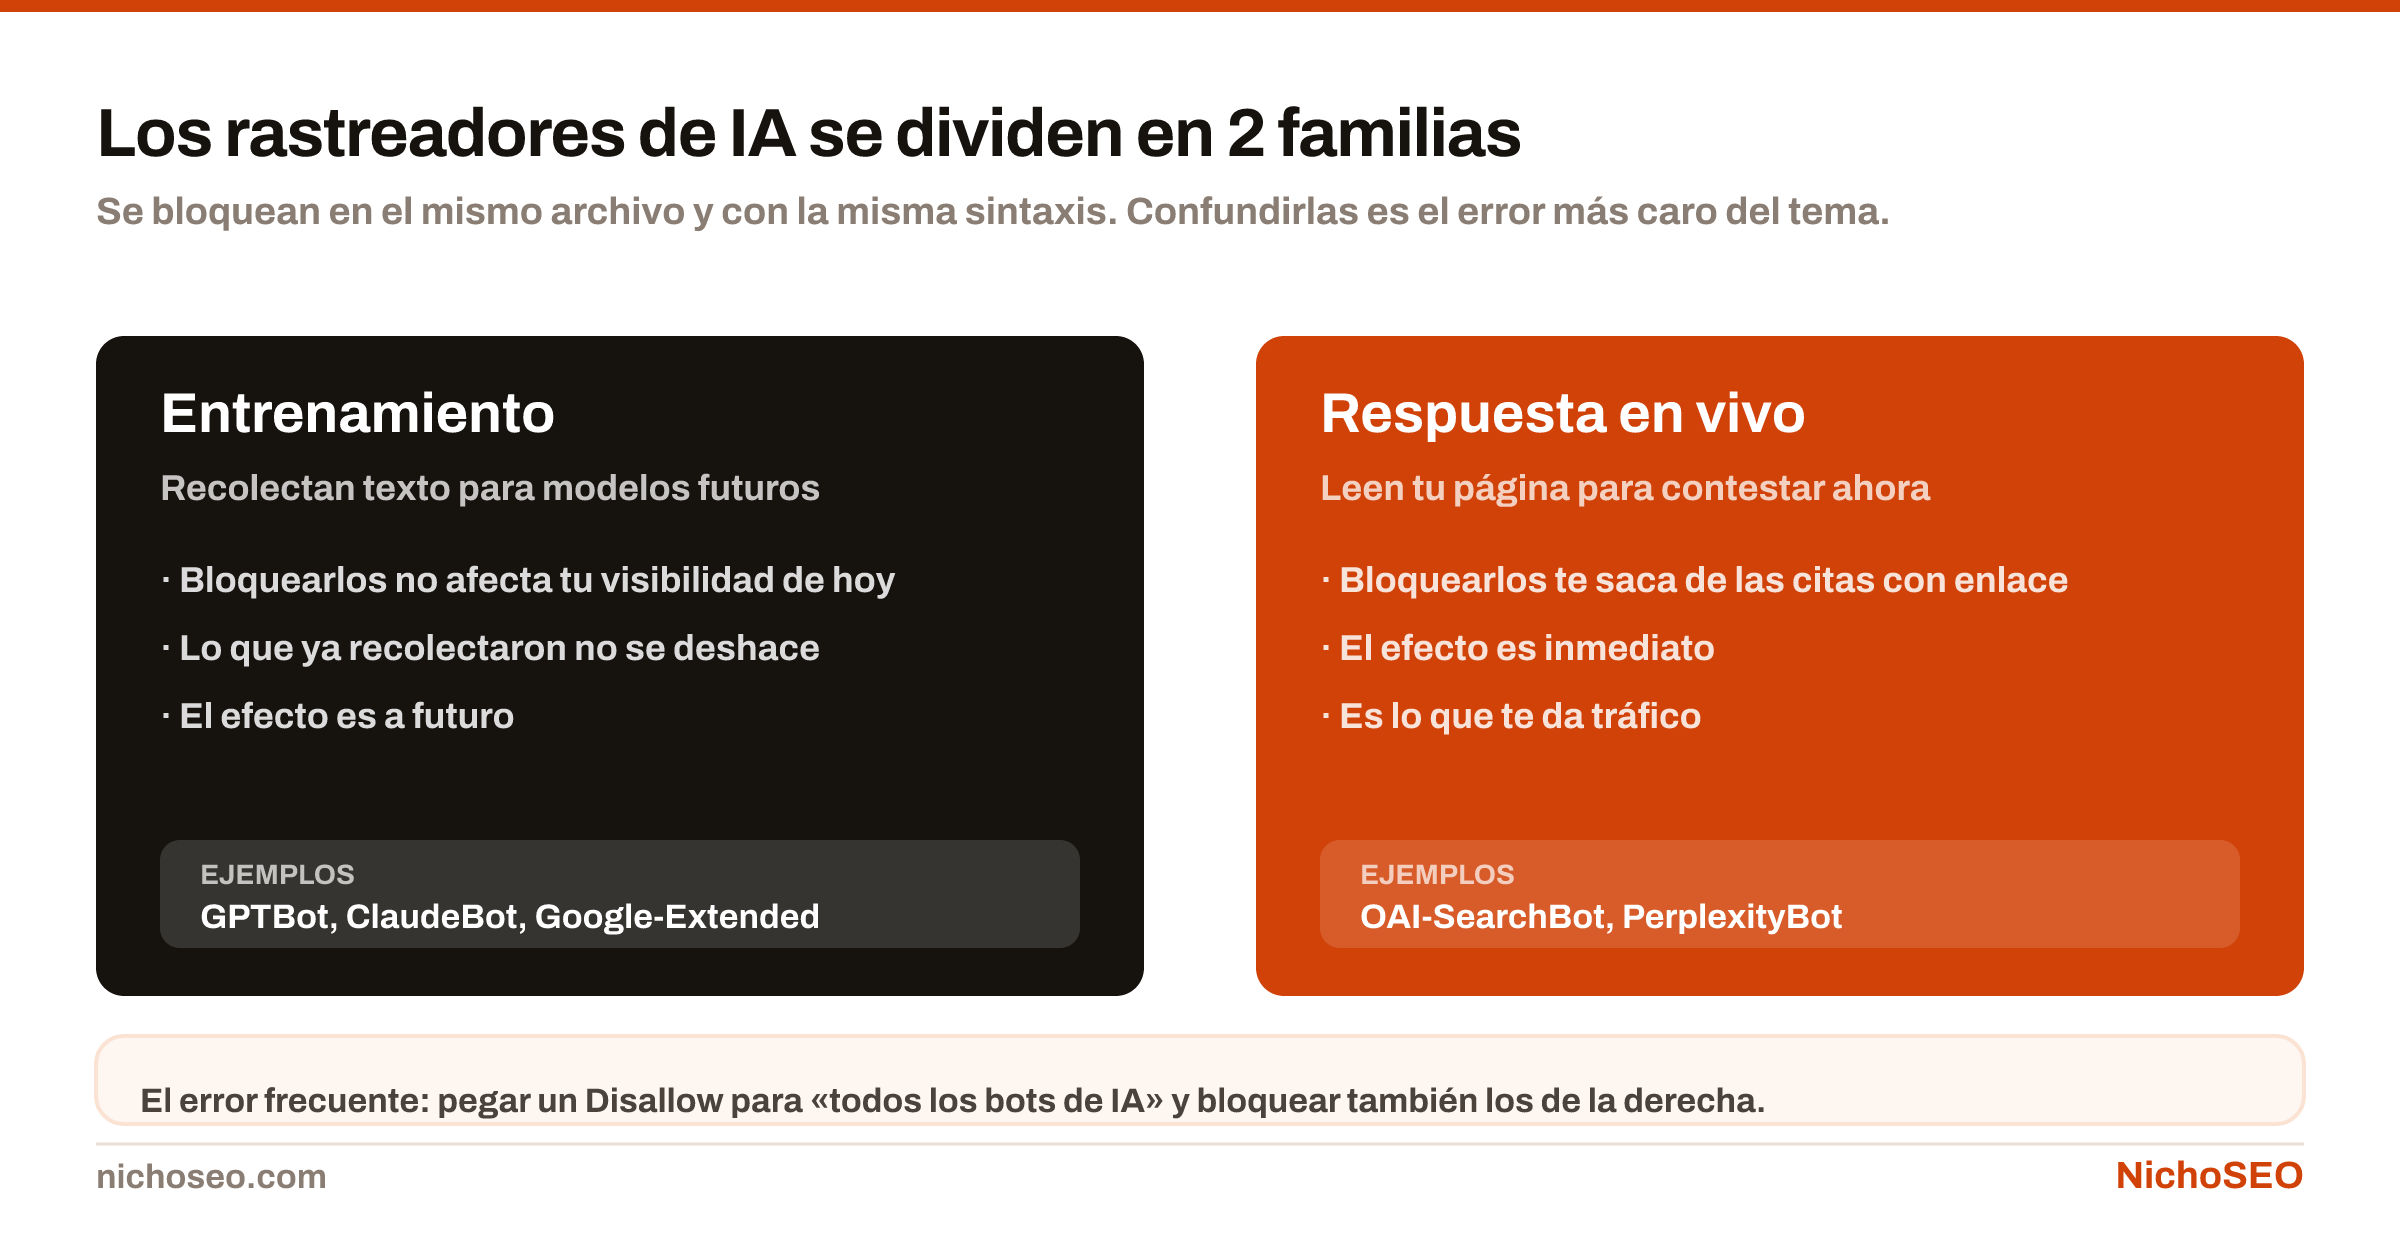
Bloquear a todos por igual con una regla genérica es la decisión más cara que se puede tomar acá, porque los segundos son los que te citan. Qué conviene permitir a cada familia está en crawlers de IA.
Y hay una trampa adicional: Gemini no se controla desde acá. Usa el rastreador de Google, y el permiso es otra directiva. La diferencia está en ChatGPT vs Claude vs Gemini.
Cómo comprobar qué está pasando de verdad
El archivo declara una intención. Lo que pasó está en otro lado.
Tres comprobaciones, de la más barata a la más útil
La tercera es la que descubre el problema que ninguna de las otras dos ve: un rastreador que el robots.txt permite y que el firewall rechaza igual. Cómo leer eso está en análisis de logs para SEO.
Los 4 errores más caros
- El
Disallow: /del entorno de pruebas sale a producción. Es el clásico de toda migración, y tumba un sitio entero en días. La lista de comprobaciones del día del cambio está en migración SEO. - Bloquear el CSS y el JavaScript. Google necesita esos archivos para ver la página como la ve una persona. Bloquearlos le da una versión rota.
- Bloquear para desindexar. Ya explicado arriba: hace exactamente lo contrario.
- Bloquear a todos los bots de IA con una regla genérica, sin distinguir entre los que entrenan y los que responden.
La especificación del protocolo, que desde 2022 es un estándar y no una convención suelta, está en el RFC 9309, y la documentación de Google sobre cómo interpreta el archivo, en su guía de robots.txt.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Siguiente en el manual