Contenido e IA

El capítulo completo, para imprimir

Las 4 entradas de Contenido e IA en una sola página: 22 minutos de lectura. El botón abre el diálogo de impresión de tu navegador, donde podés elegir «Guardar como PDF».

Volver al capítulo

NichoSEO · Manual de SEO y GEO

Contenido e IA

La discusión sobre si se puede escribir con IA está mal planteada casi siempre. Este capítulo separa lo que dicen las políticas de lo que se observa, explica por qué los detectores fallan y muestra qué hace que un contenido se vuelva citable.

4 entradas · 22 minutos de lectura · última revisión del capítulo: 26 de sept de 2026

nichoseo.com/manual/contenido-e-ia/

1 de 4

Detectores de IA: por qué no sirven para lo que creés

Un detector no mide quién escribió un texto: mide qué tan previsible es. Por qué eso produce falsos positivos contra gente que escribe bien.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

De esa diferencia salen todos los problemas que tiene la categoría.

Qué mide en realidad

Para entender por qué falla hay que entender qué mira, y es más simple de lo que parece.
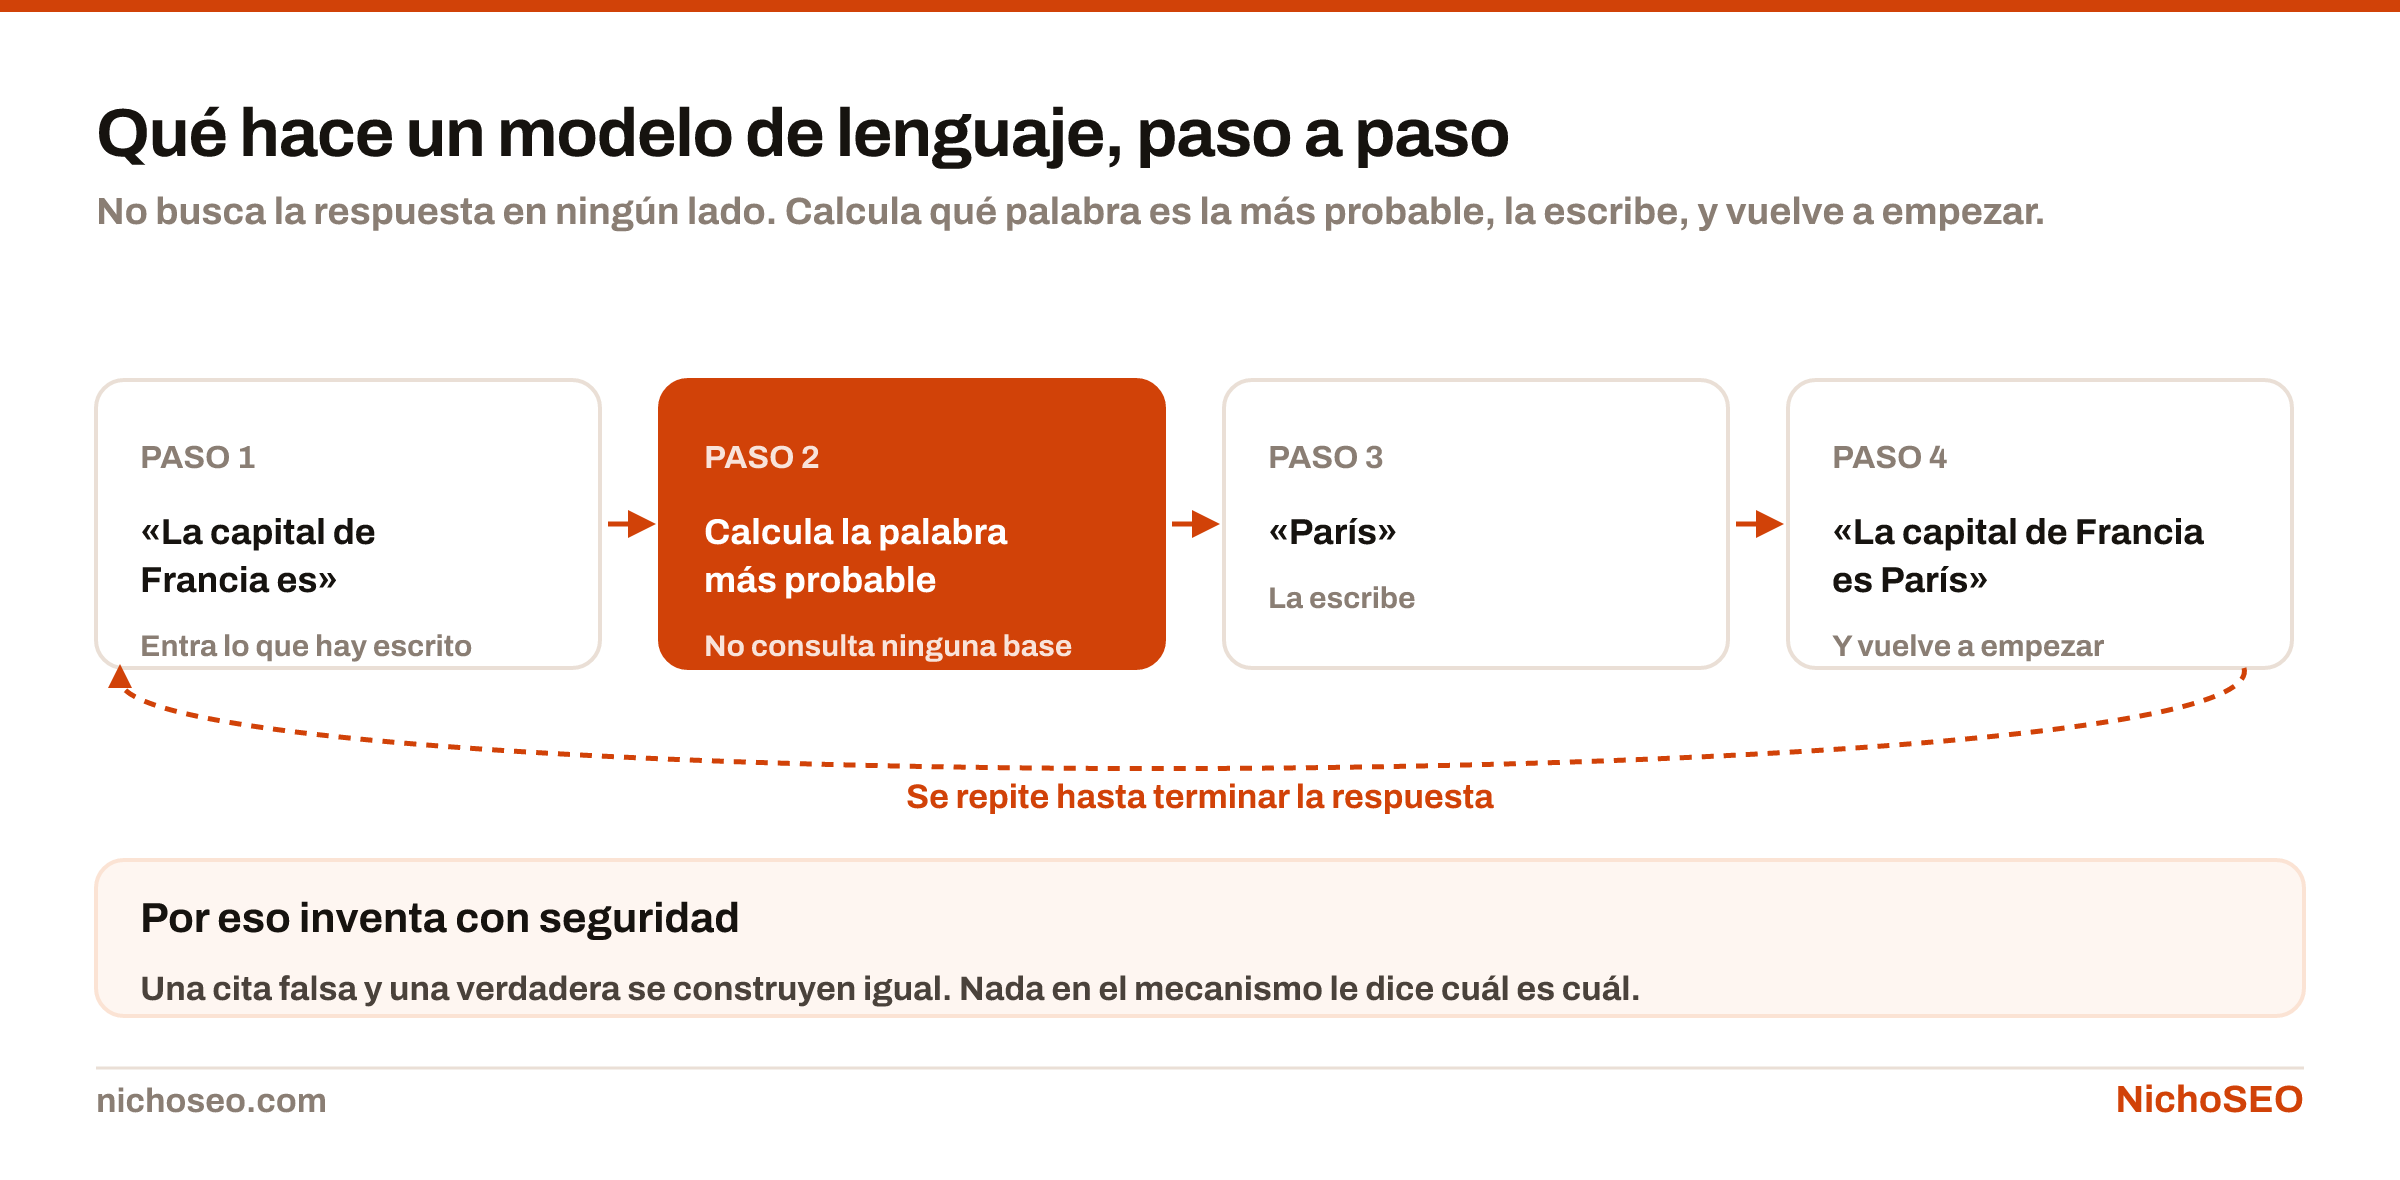
El mecanismo de un modelo de lenguaje: toma el texto escrito hasta ahora, calcula la palabra más probable, la agrega y repite el ciclo.
No busca la respuesta en ningún lado. Calcula qué palabra es la más probable, la escribe, y vuelve a empezar.Descargar imagen

Un modelo de lenguaje elige cada palabra según qué tan probable es después de las anteriores. Tiende a elegir lo probable, y eso produce texto previsible.

Un detector invierte el cálculo: toma un texto y mide qué tan previsible es. Si cada palabra es la que un modelo habría elegido, sube el porcentaje.

El problema es que “previsible” no es sinónimo de “generado”. Hay escritura humana muy previsible y la hay muy poco previsible, y eso depende de cómo escribe la persona, no de si es una persona.

Los dos errores, y cuál es el caro
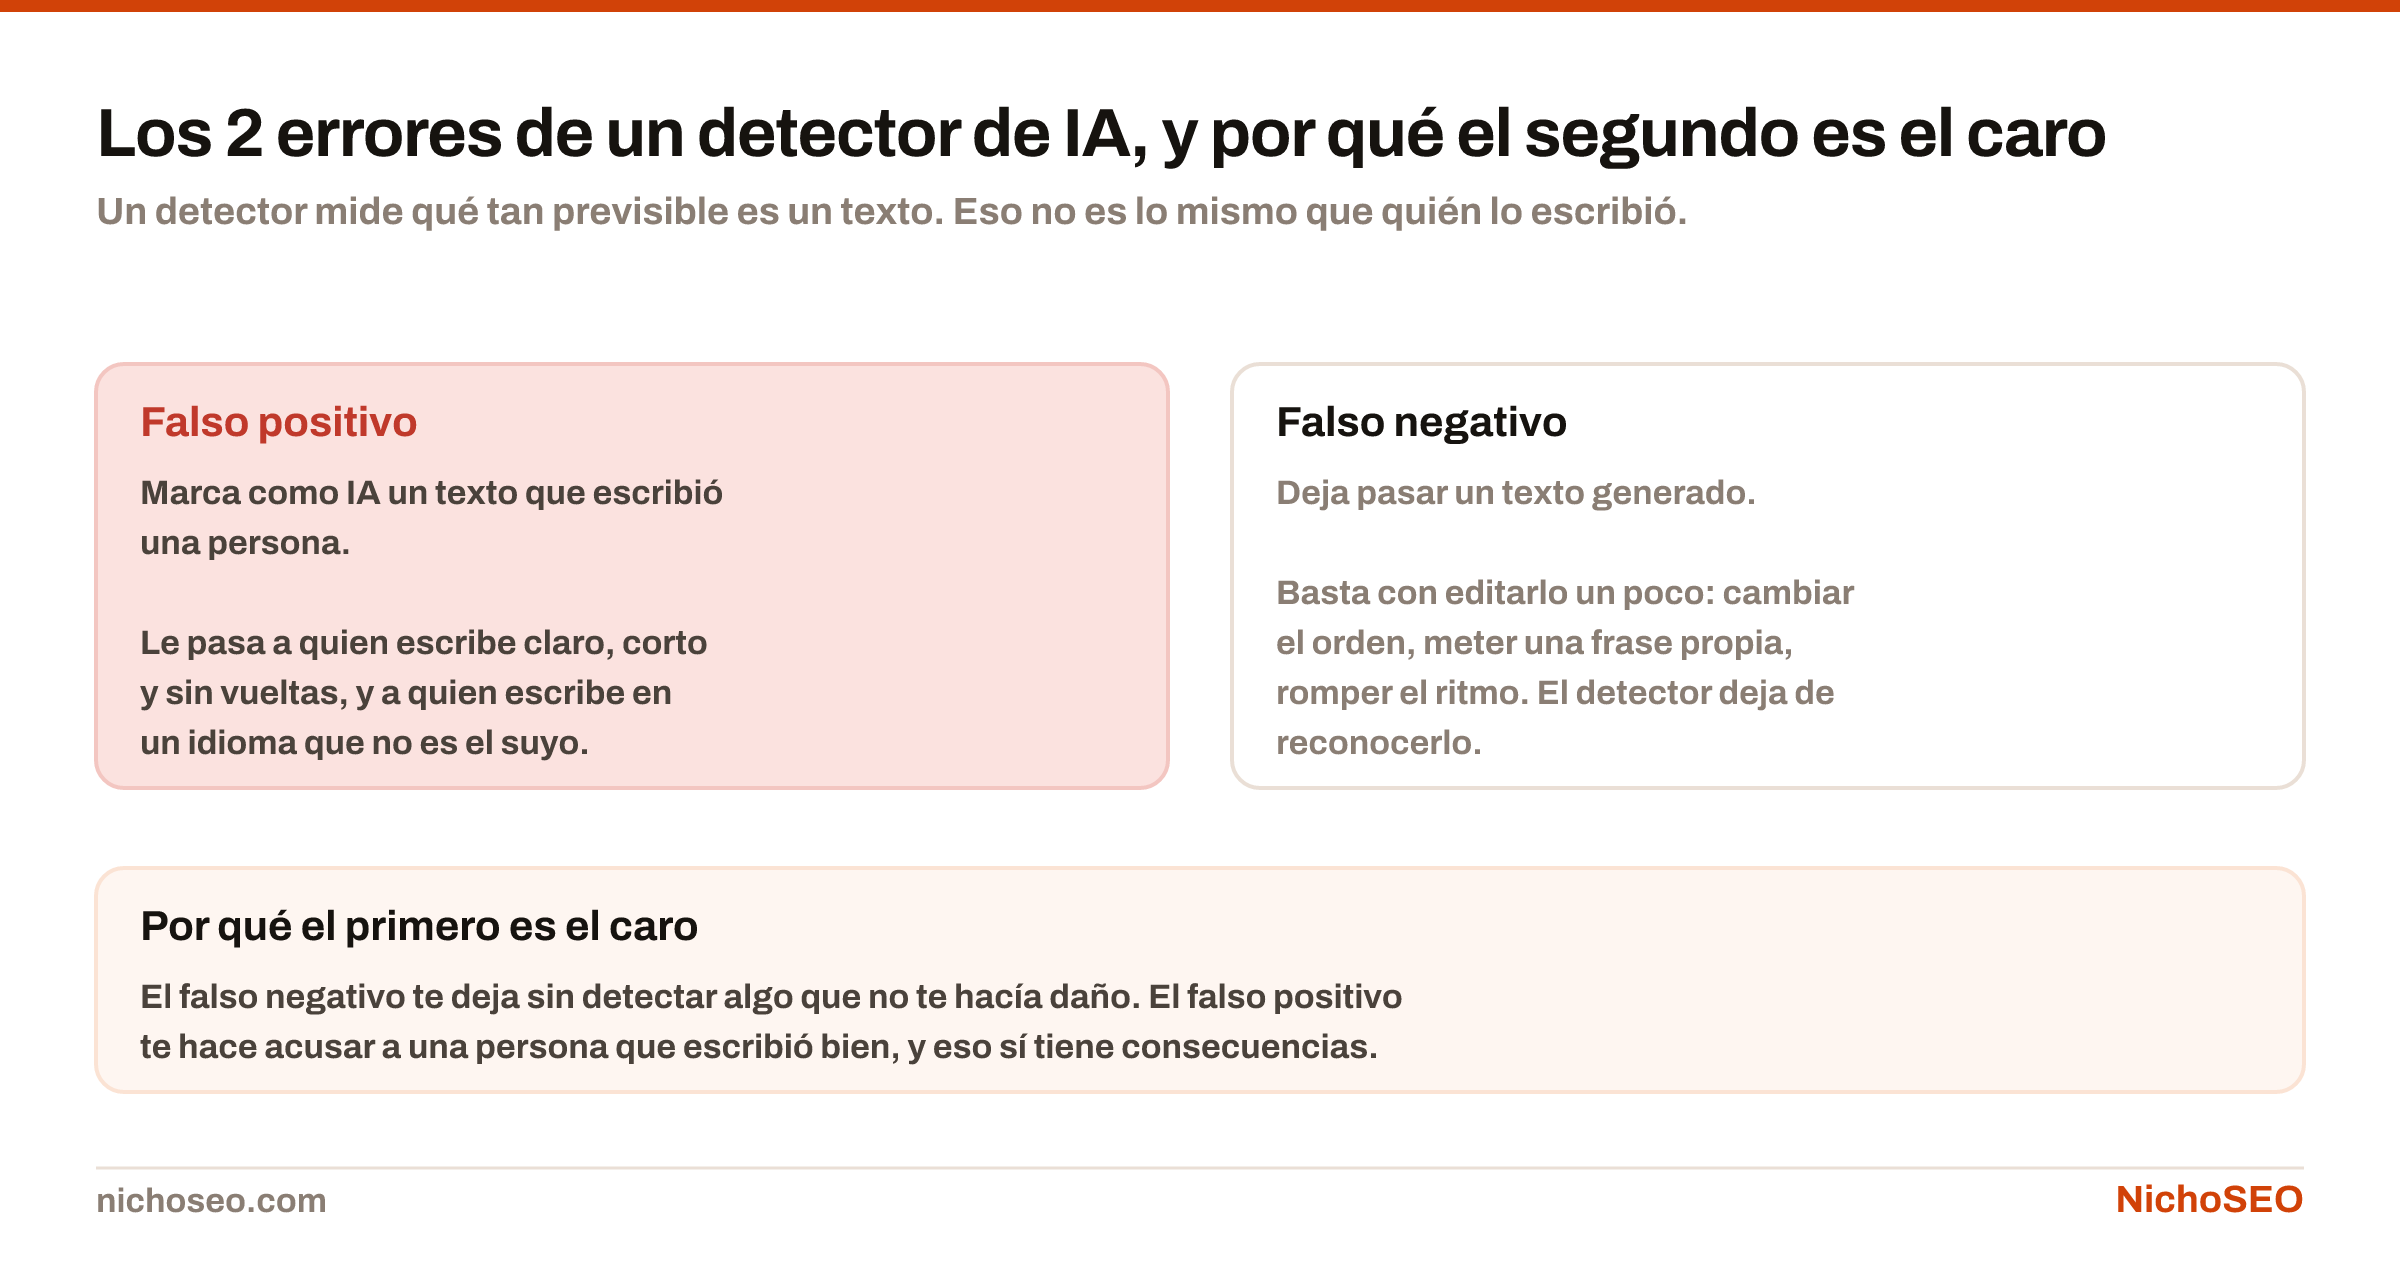
Los dos errores de un detector de texto generado por IA: el falso positivo, que acusa a una persona que escribió claro, y el falso negativo, que deja pasar texto generado y luego editado.
Un detector mide qué tan previsible es un texto. Eso no es lo mismo que quién lo escribió.Descargar imagen

El falso negativo —dejar pasar texto generado— es el error que todo el mundo teme y el menos costoso. Basta con editar un poco el texto: cambiar el orden de dos oraciones, meter una frase propia, romper el ritmo. El detector deja de reconocerlo.

O sea: el detector es fácil de evadir a propósito. Como control, eso ya lo vuelve poco útil.

El falso positivo es el que hace daño. Marca como IA a una persona que escribió el texto, y quien recibe el resultado actúa como si tuviera una prueba.

Escritura que pasa el detector

  • Frases largas con subordinadas
  • Vocabulario variado, a veces raro
  • Cambios bruscos de registro
  • Errores y repeticiones

Escritura que lo hace saltar

  • Frases cortas y directas
  • El mismo término para la misma cosa
  • Estructura consistente de principio a fin
  • Un texto limpio, editado y revisado
La columna derecha describe buena escritura técnica. Es la que más se marca.

Ahí está lo incómodo: las marcas de un texto bien editado son las mismas que las de un texto generado. Claridad, consistencia, frases cortas, un término por concepto. Es lo que pide cualquier manual de redacción.

Y hay un sesgo documentado adicional: los textos escritos por personas en un idioma que no es el suyo tienden a usar construcciones más simples y vocabulario más restringido. Eso los hace más previsibles y sube su puntaje de detección.

Por qué el porcentaje no significa lo que parece

“87 % de probabilidad de IA” se lee como una confianza. No es eso.

Es una salida de un clasificador entrenado con ejemplos, y el número depende del umbral que su autor eligió. Dos detectores distintos dan porcentajes distintos para el mismo texto, por el mismo motivo por el que dos herramientas de keywords dan volúmenes distintos.

Qué se puede concluir de un porcentaje alto

NadaSobre quién escribióEl detector no ve al autor, ve el texto
AlgoSobre qué tan previsible esQue es lo que efectivamente mide
0Como pruebaNo hay forma de verificar el resultado
Ningún detector publica su tasa de error sobre textos de tu tipo. Sin eso, el número no se puede calibrar.

Un dato que conviene pedirle a cualquier detector antes de usarlo: cuál es su tasa de falsos positivos, medida sobre qué corpus. Casi ninguno lo publica, y los que lo hacen suelen medirlo sobre textos genéricos, no sobre escritura técnica editada.

Qué hacer en lugar de detectar

La pregunta útil no es “¿esto lo escribió una IA?”. Es “¿esto aporta algo que se pueda verificar?”.

Qué señales de EEAT son verificables desde la página —quién firma, qué hizo, de dónde sale un dato, cuándo se revisó— y cuáles no lo son directamente.
Todo el trabajo de EEAT consiste en mover cosas de la mitad de abajo a la de arriba.Descargar imagen

Esa segunda pregunta se puede contestar leyendo, no midiendo:

  1. ¿Hay algún dato que no esté en otros diez artículos? Un número propio, un caso, un procedimiento que alguien siguió.
  2. ¿Las afirmaciones tienen de dónde salieron? Fecha, fuente, muestra.
  3. ¿Hay alguien que se haga responsable? Un nombre con una trayectoria comprobable, no una firma genérica.
  4. ¿Dice algo que no diría cualquiera? Una opinión, un límite, un “esto no funcionó”.

Un texto que pasa esas cuatro sirve, lo haya escrito quien lo haya escrito. Uno que no las pasa no sirve, aunque lo haya escrito una persona a mano.

El criterio completo de qué se puede demostrar está en E-E-A-T, y qué hace que un texto sea citable, en contenido citable.

El caso particular de Google

Conviene separarlo, porque es la pregunta que hay detrás de casi todas las consultas sobre detectores.

Google no dice que detecte contenido generado ni que lo penalice por serlo. Lo que su política sanciona es producir a escala con el fin principal de manipular el ranking, y eso aplica igual si el texto se generó, se hiló a mano o se tradujo en masa.

El detalle de qué dice la política y qué se observa en la práctica está en ¿Google penaliza el contenido hecho con IA?.

Dónde sí tienen algún uso

No son inútiles; son mal usados.

Como señal entre varias, nunca como veredicto. Si un texto da alto en el detector y además no tiene ningún dato propio y además no tiene autor, hay algo. El detector solo no dice nada.

Para revisar lo propio. Si pasás tu propio texto y da muy alto, puede ser una pista de que quedó genérico. No porque lo haya escrito una máquina, sino porque no dice nada que otro no pudiera decir. Esa es una señal de edición útil.

Nunca para acusar a una persona. Ni a un redactor, ni a un proveedor, ni a un estudiante. El falso positivo existe, no es raro, y quien lo sufre no tiene forma de demostrar lo contrario.

Lo que sí se puede exigir

Si el problema real es la calidad de lo que entrega un proveedor, el contrato es mejor herramienta que el detector.

Pedir el dato propio, la fuente de cada cifra, el nombre de quien firma y una entrevista a alguien que sepa del tema resuelve el problema de fondo. Un texto con esas cuatro cosas es difícil de producir sin trabajo, se haya usado o no un modelo en el camino.

Un texto con esas cuatro cosas es difícil de producir sin trabajo, se haya usado o no un modelo en el camino.

La política de Google sobre contenido generado, que es el documento que más se cita mal en esta discusión, está publicada en su guía sobre contenido creado con IA.
2 de 4

¿Google penaliza el contenido hecho con IA?

La política no habla del método de producción: habla de la intención. Qué dice exactamente, qué sanciona de verdad y qué se observa en los sitios que cayeron.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

La distinción no es un tecnicismo: cambia por completo qué hay que revisar antes de publicar.

Qué dice exactamente, y qué no dice

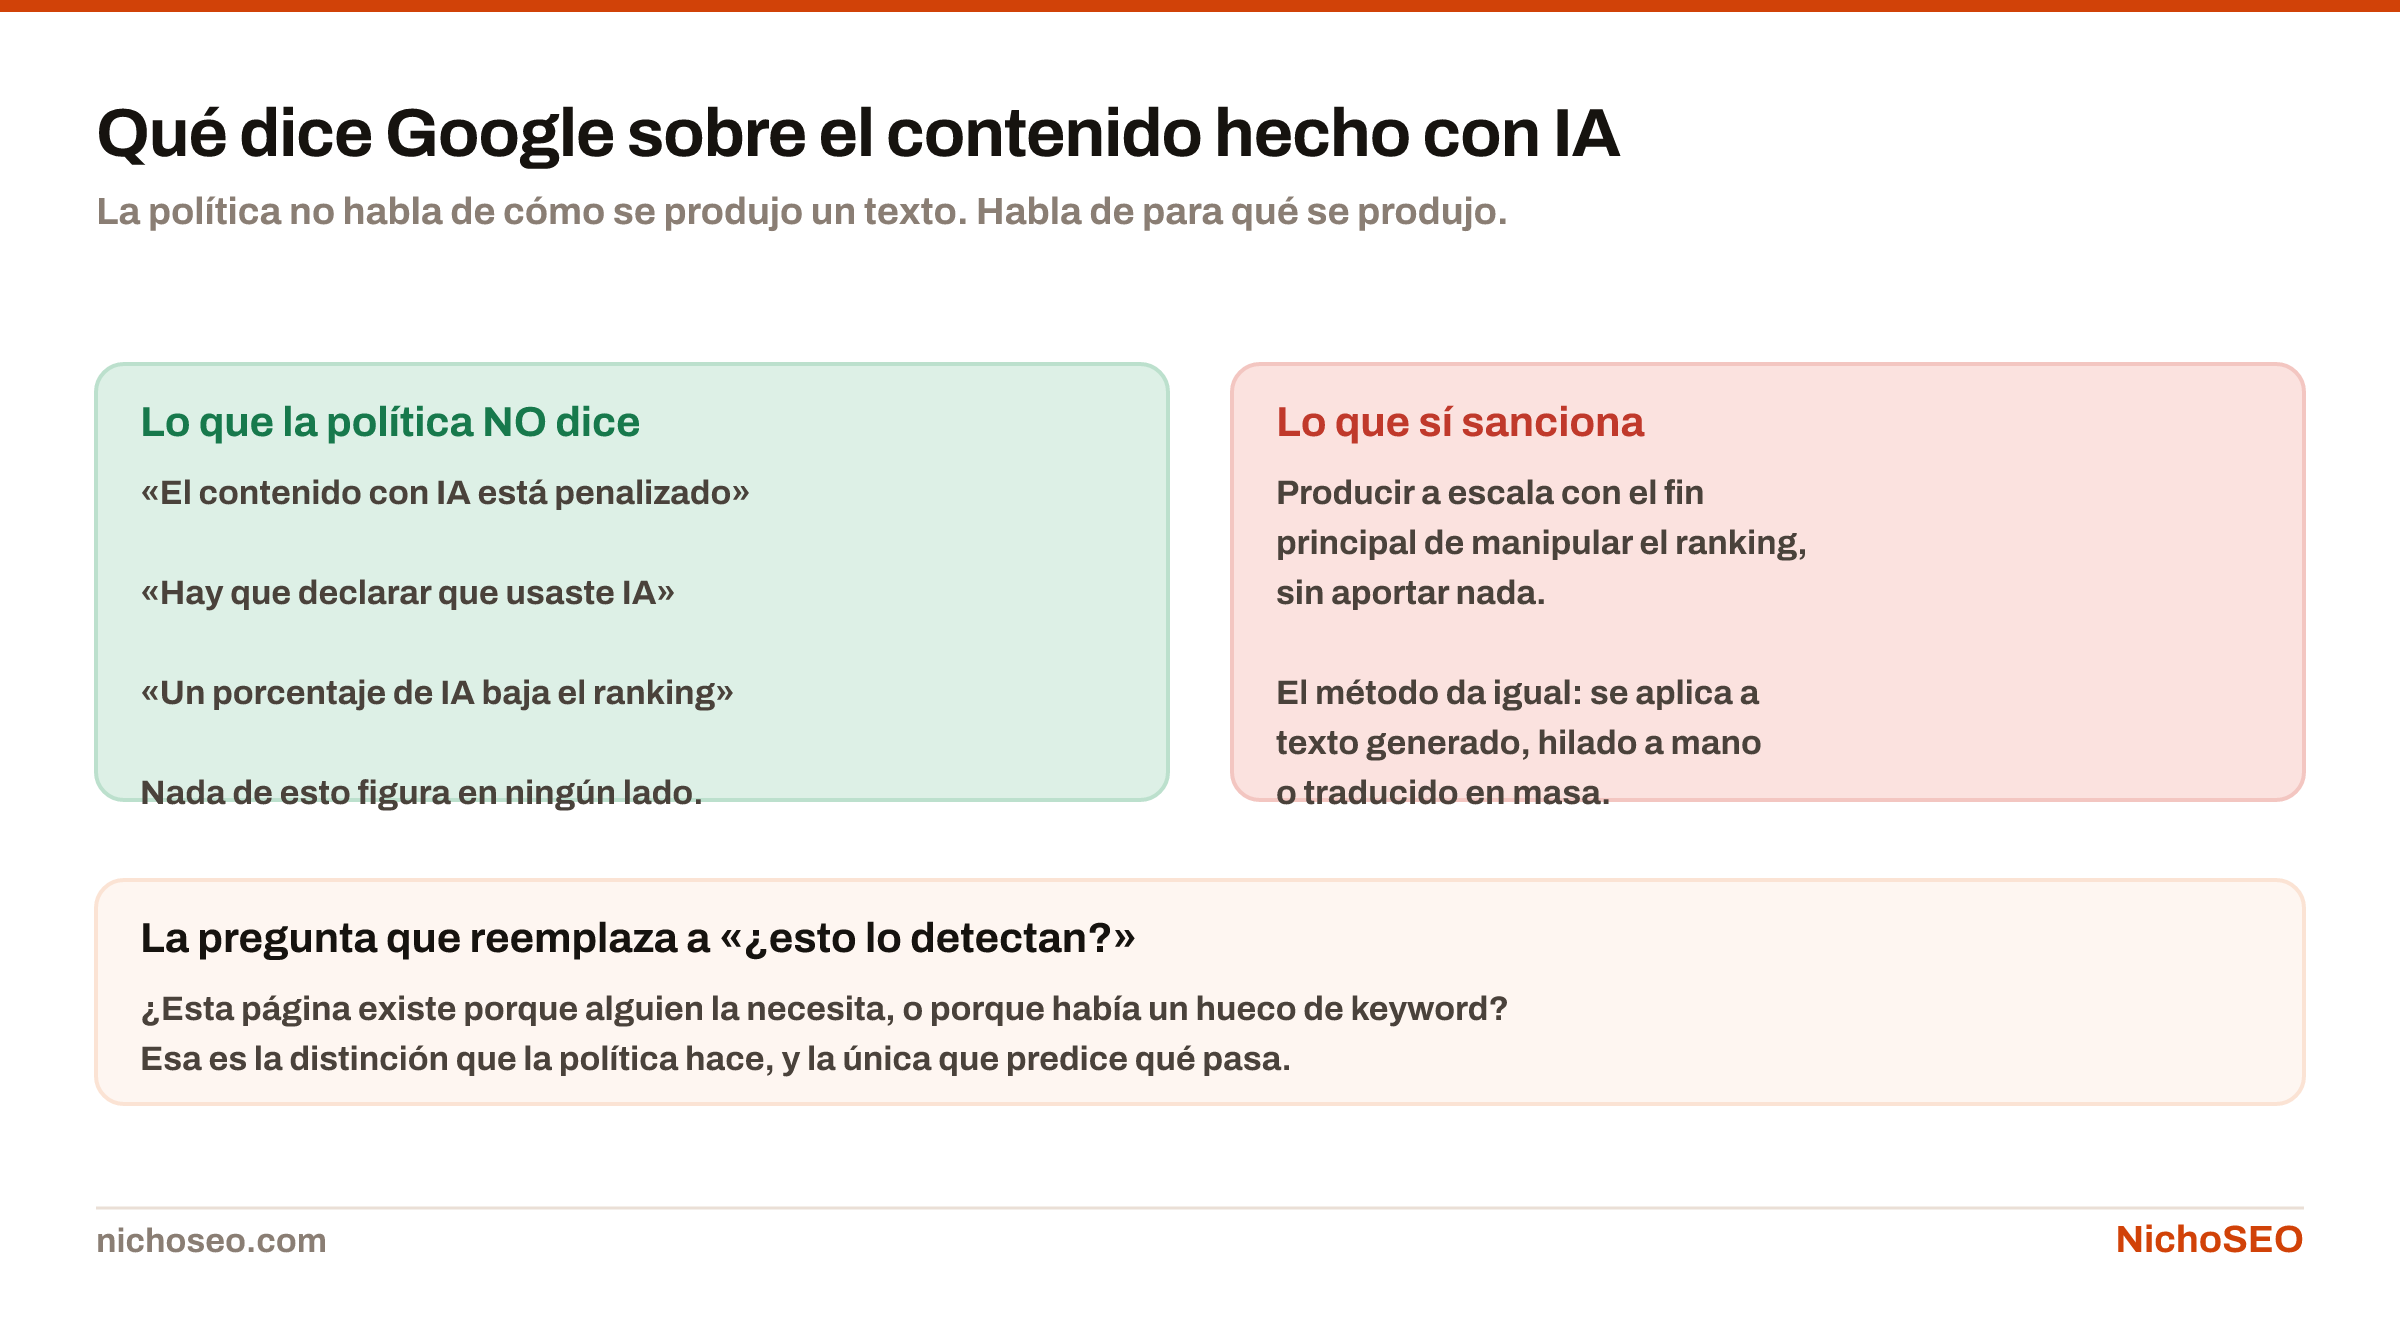
La política de Google sobre contenido generado con IA: no penaliza por el método de producción sino por la intención, y lo que sanciona es producir a escala para manipular el ranking sin aportar valor.
La política no habla de cómo se produjo un texto. Habla de para qué se produjo.Descargar imagen

Las tres afirmaciones de la izquierda circulan como si fueran política y no están en ningún documento.

No existe una penalización por usar IA. No existe la obligación de declararlo. No existe un umbral de porcentaje por encima del cual un texto sea problemático.

Lo que sí existe es una categoría de spam —producción a escala para manipular el ranking— que es anterior a la IA generativa y que se aplicaba igual a las granjas de contenido hiladas a mano y a las traducciones automáticas en masa.

La IA no creó la regla. Cambió el costo de infringirla.

Por qué la política está escrita así

Porque Google no puede verificar el método de producción, y lo sabe.

No hay forma confiable de determinar si un texto se generó. Los detectores fallan en las dos direcciones, y una política que dependiera de ellos sería inaplicable. La propia lógica de un detector está explicada en detectores de IA.

Lo que sí se puede evaluar es el resultado: si la página aporta algo, si alguien se hace responsable, si existe porque alguien la necesitaba o porque había un hueco de keyword.

Lo que la política evalúa

  • Si la página aporta algo que no estuviera ya
  • Si hay alguien identificable detrás
  • Si la escala es desproporcionada respecto del valor
  • Si el propósito principal es rankear

Lo que no puede evaluar

  • Con qué herramienta se escribió
  • Qué porcentaje del texto generó un modelo
  • Cuánto tardó una persona en editarlo
  • Si hubo un redactor o un prompt
La columna de la derecha no es verificable, y por eso no está en ninguna política.

Qué se observa en los sitios que cayeron

Acá conviene separar lo que dice la política de lo que se ve en la práctica, porque no son lo mismo.

Muchos sitios que publicaron contenido generado en volumen perdieron visibilidad. Eso es cierto y está documentado. La lectura fácil es “Google detectó la IA”, y no es lo que muestran los casos.

Lo que comparten esos sitios es otra cosa:

  1. Cientos o miles de páginas publicadas en poco tiempo, sin historia previa.
  2. Ninguna información que no estuviera ya en otros diez sitios. Sin datos propios, sin casos, sin procedimiento.
  3. Sin autor identificable, o con autores inventados.
  4. Plantillas visibles: la misma estructura y las mismas frases con la variable cambiada.
  5. Cero señales de terceros. Nadie los cita, nadie los menciona, nadie los busca por su nombre.

Un sitio con esas cinco características habría tenido problemas en 2015 también. La IA solo permitió llegar a ese estado en semanas en lugar de años.

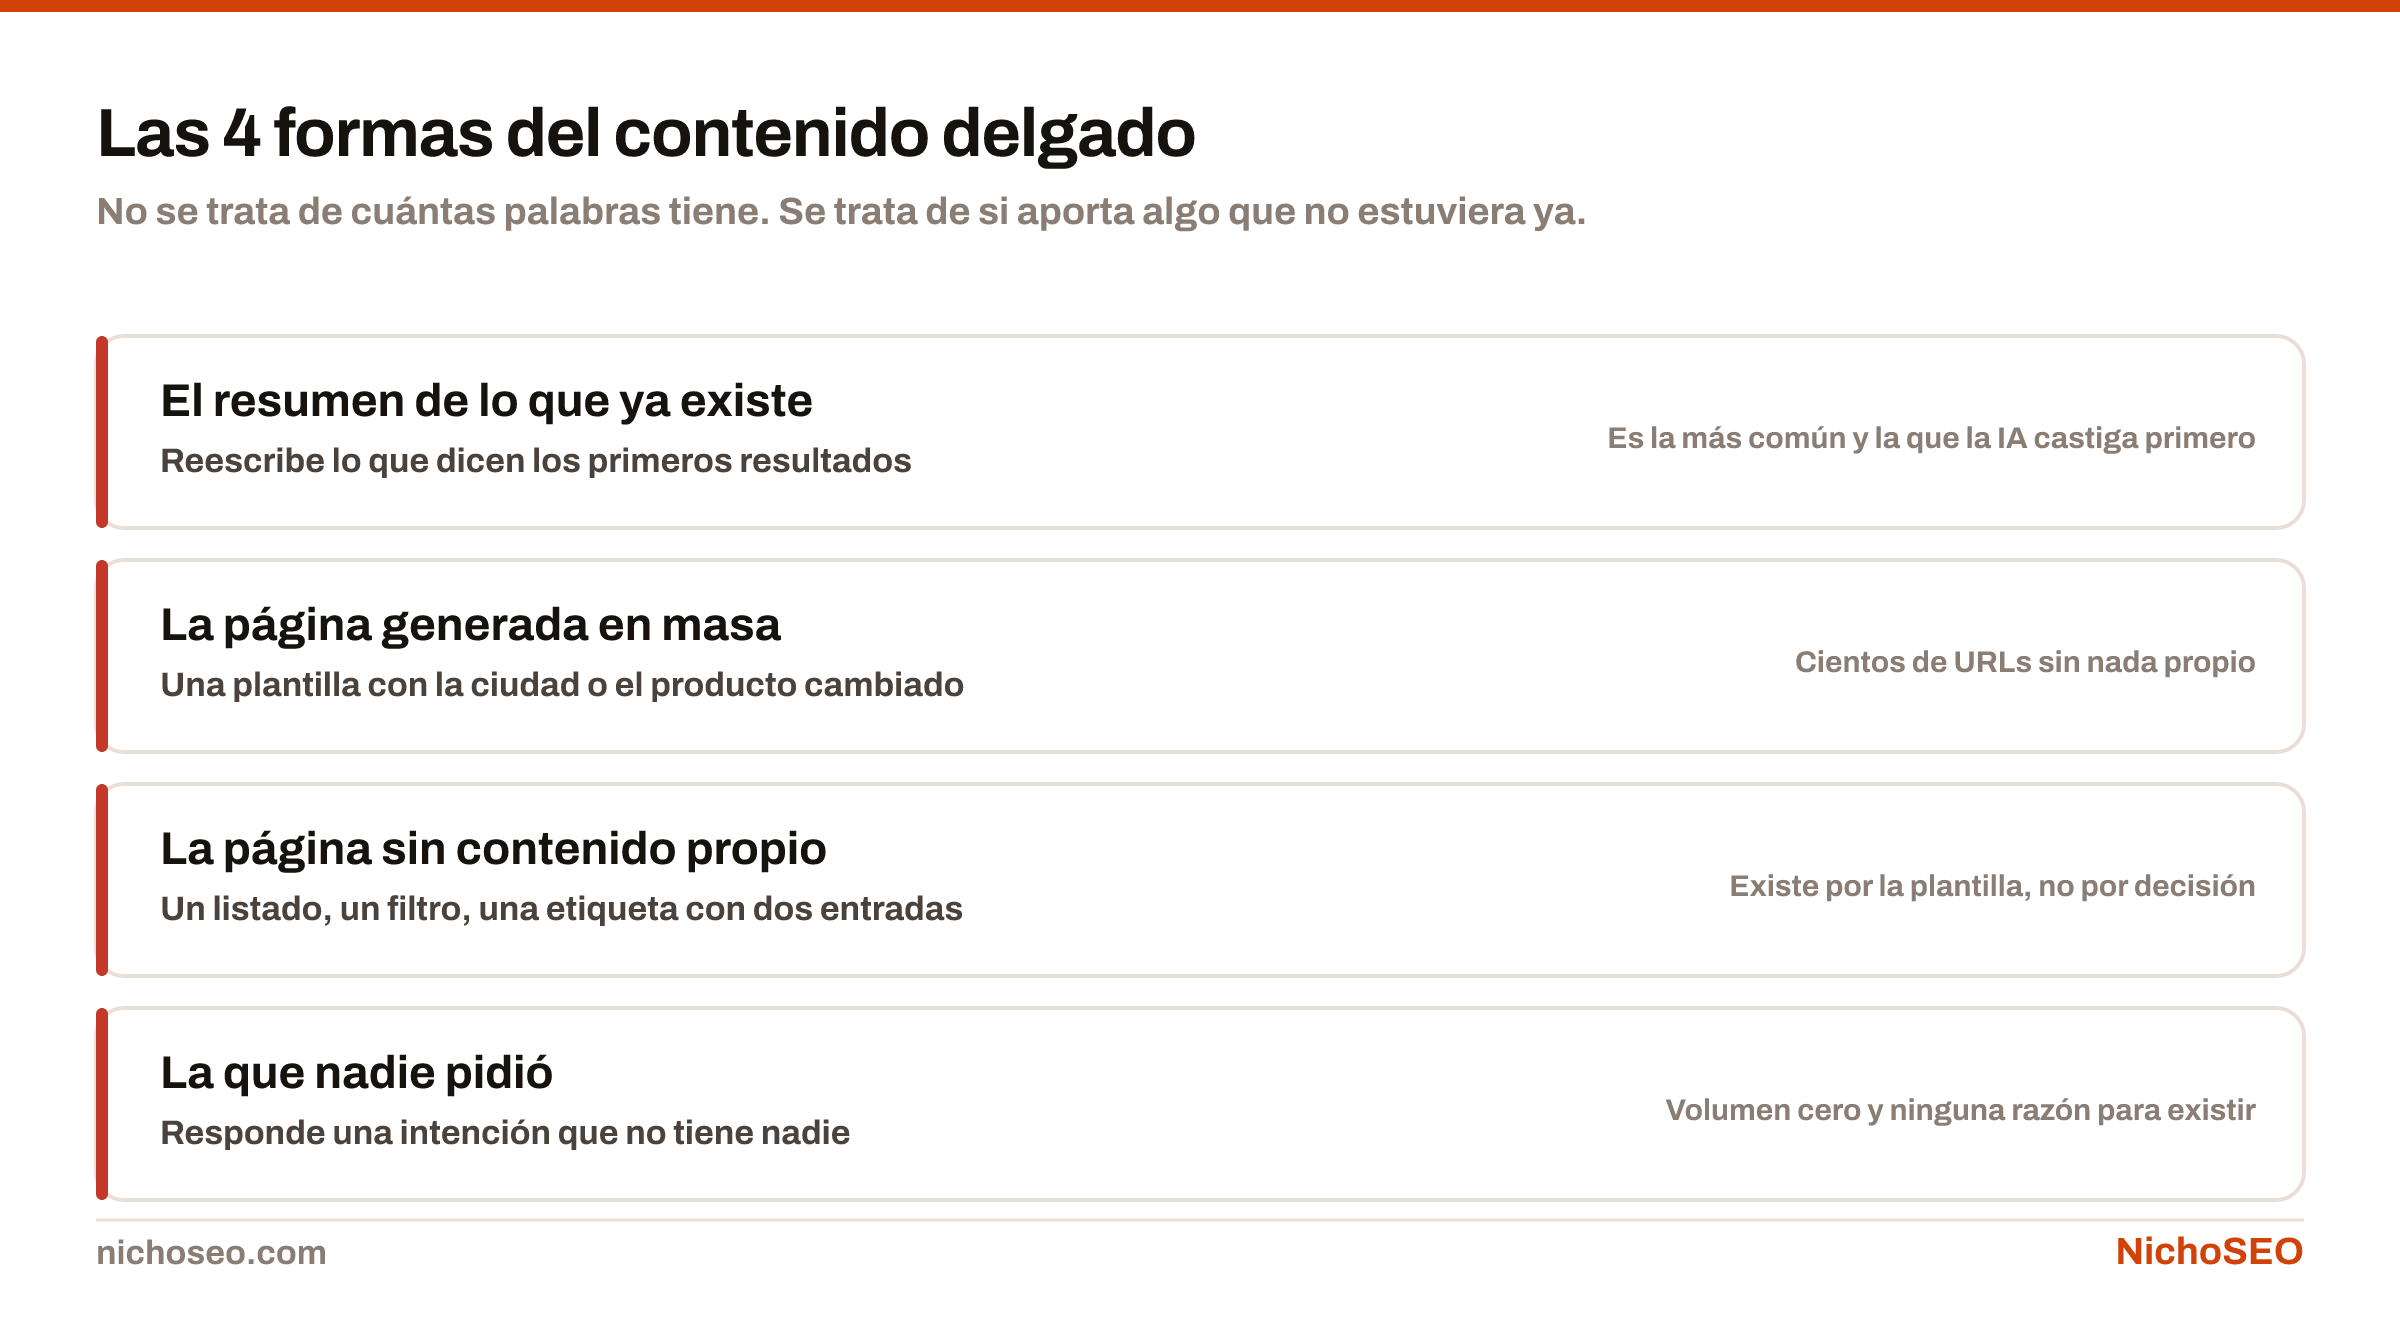
Las cuatro formas del contenido delgado: el resumen de lo que ya existe, la página generada en masa, la página sin contenido propio y la que responde una intención que nadie tiene.
No se trata de cuántas palabras tiene. Se trata de si aporta algo que no estuviera ya.Descargar imagen

Las cuatro formas que toma el contenido vacío están en thin content, y son las mismas con o sin IA de por medio.

La pregunta que reemplaza a «¿esto lo detectan?»

Es la única que predice algo: ¿esta página existe porque alguien la necesita, o porque había un hueco de keyword?

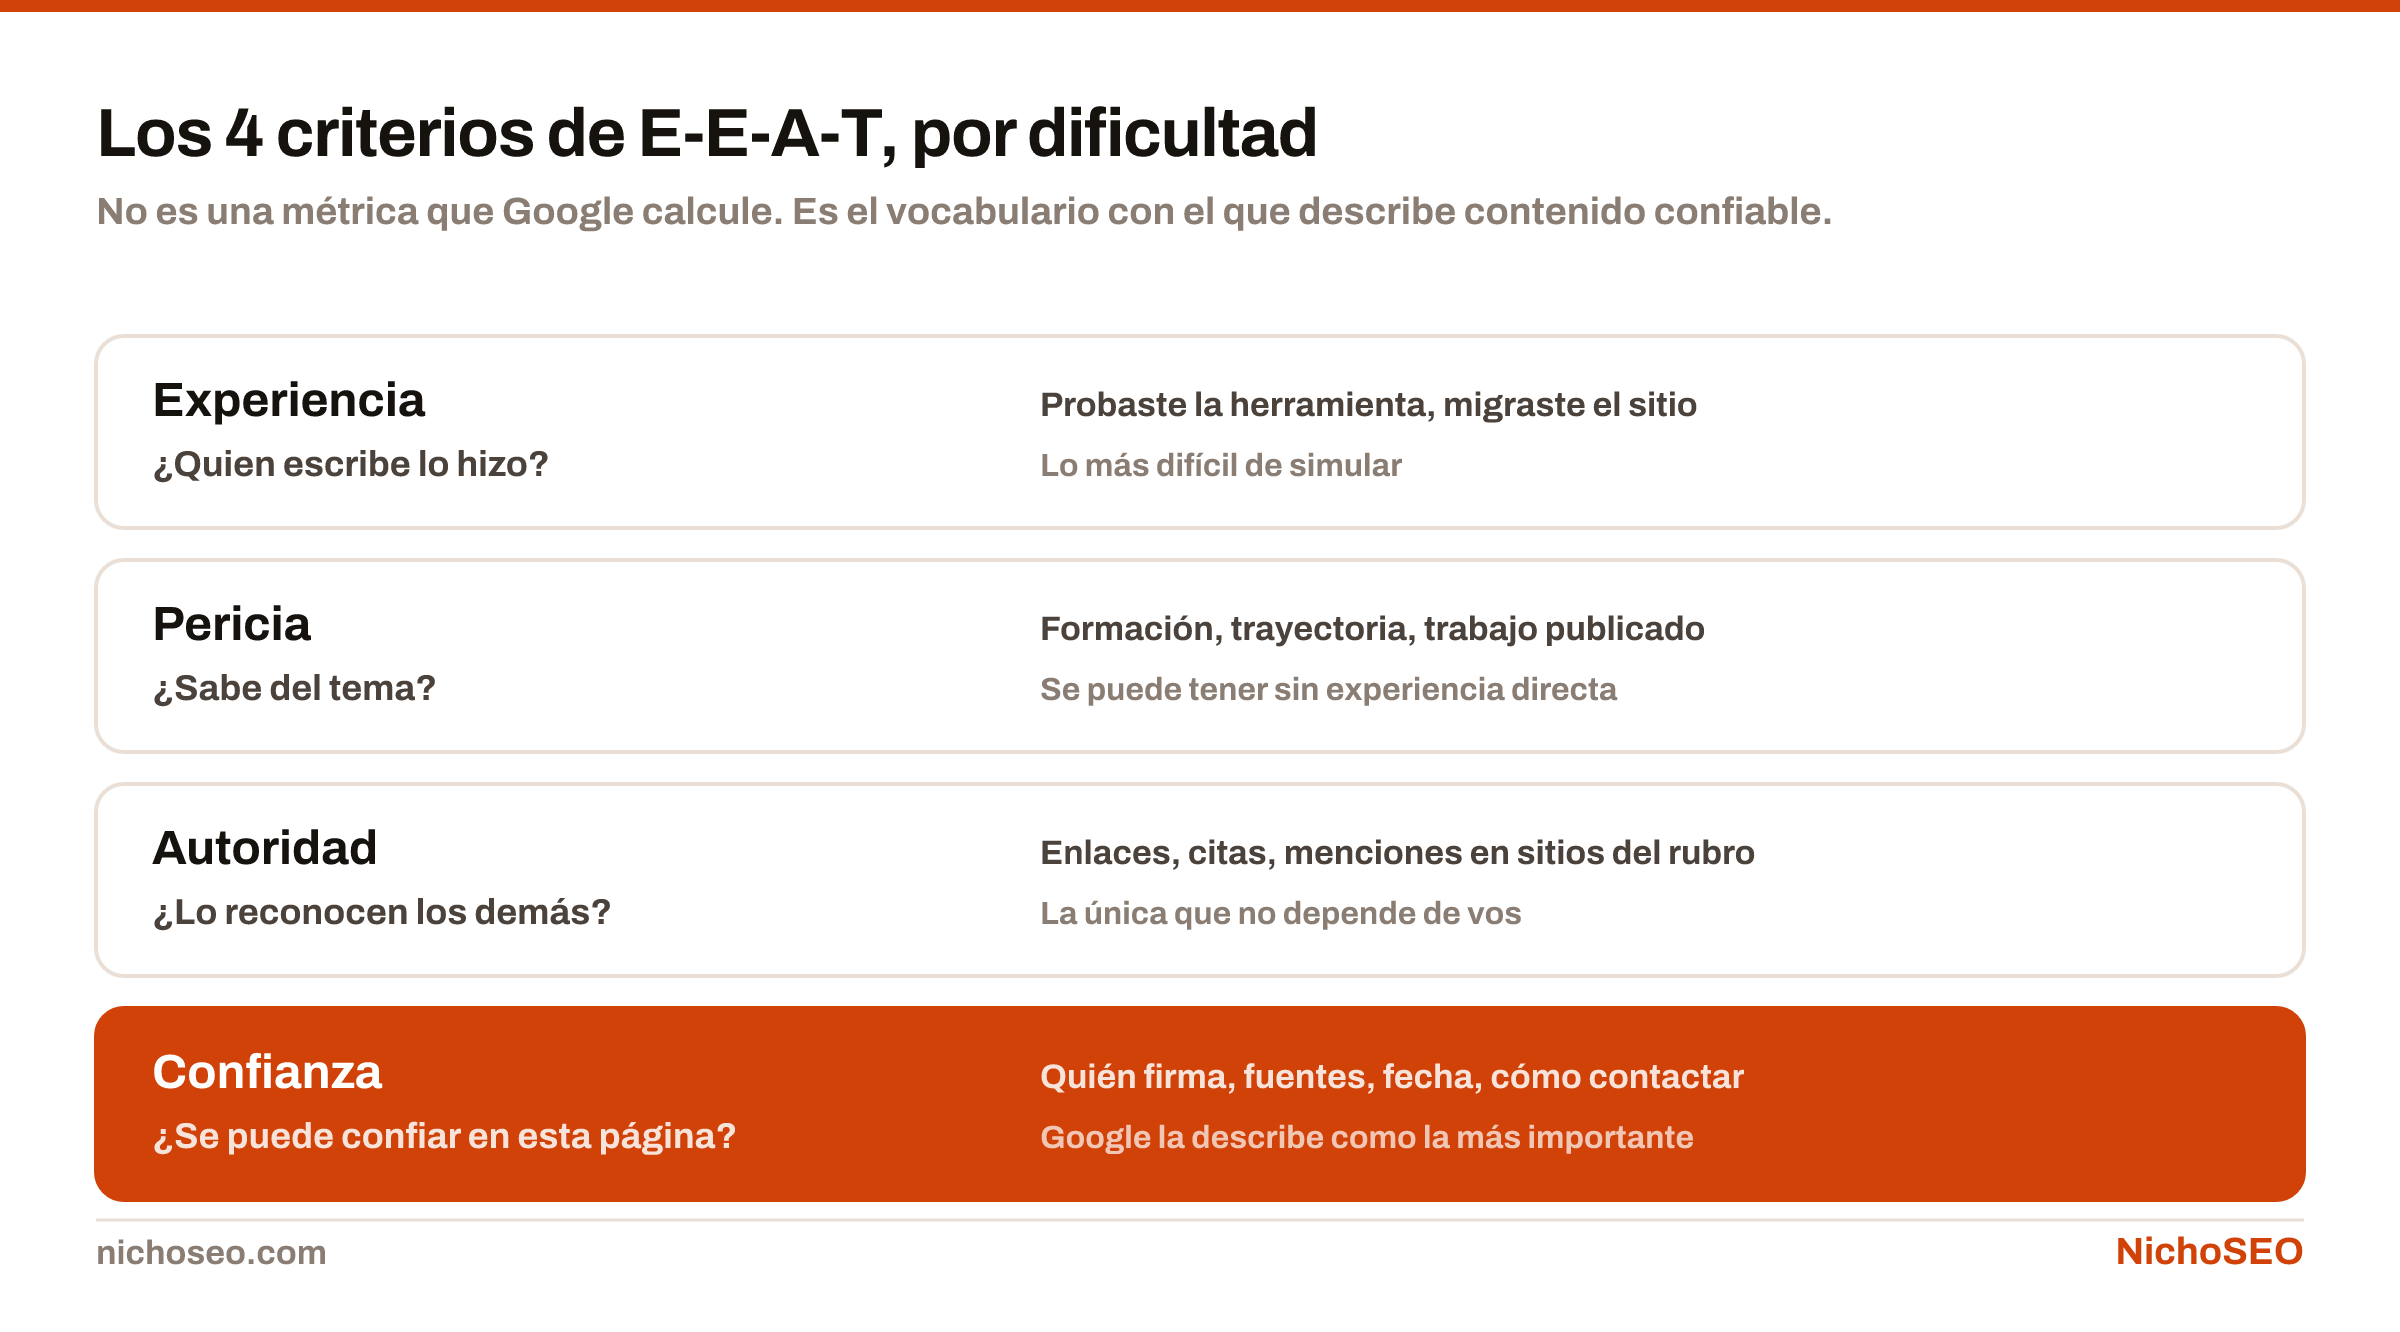
Los cuatro criterios de E-E-A-T ordenados por dificultad: experiencia, pericia, autoridad y confianza, con qué pregunta responde cada uno.
No es una métrica que Google calcule. Es el vocabulario con el que describe contenido confiable.Descargar imagen

Si la respuesta es la primera, el método de producción no cambia el resultado. Si es la segunda, tampoco lo cambia: la página va a tener el mismo problema escrita a mano.

Los cuatro criterios de E-E-A-T son la forma larga de esa misma pregunta, y el que más pesa —la experiencia de primera mano— es justamente el que un modelo no puede aportar solo. El detalle está en E-E-A-T.

Qué hacer si publicás con IA en el proceso

No hay nada que declarar ni nada que esconder. Hay cosas que agregar.

Lo que convierte un borrador en una página que se sostiene

1Dato propioUn número, un caso, un procedimiento que seguiste
1Autor realCon nombre y trayectoria comprobable
1Límite honestoQué no sabés, o qué no funcionó
Las tres cosas son difíciles de producir sin trabajo, que es exactamente el punto.

Ese tercer punto es el más subestimado. Decir “esto no lo probamos” o “acá los datos no alcanzan” es algo que un borrador genérico nunca hace, y es una de las marcas más claras de que hubo alguien pensando.

Las tres juntas son lo que separa una página que se sostiene de un borrador publicado.

Cómo saber si te penalizaron de verdad

Conviene distinguir dos cosas que se confunden siempre.

Una acción manual es una sanción aplicada por una persona. Aparece en Search Console, con el motivo, y se puede pedir revisión. Si no hay nada ahí, no hay sanción.

Una caída por una actualización del núcleo no es una sanción: es un cambio en cómo se ordenan los resultados. No hay nada que apelar, y se recupera mejorando lo que la actualización pasó a valorar.

La mayoría de los casos que se cuentan como “me penalizó Google por usar IA” son lo segundo. Cómo se distinguen las dos cosas, y qué hacer con cada una, está en penalizaciones de Google. Lo primero deja rastro y el rastro es consultable en cinco minutos: cómo mirarlo está en la guía de Search Console.

El resumen

No hay una penalización por usar IA. Hay una política contra producir a escala sin aportar nada, y esa política es vieja.

Lo que cambió es que ahora es barato llegar a ese estado sin darse cuenta. Publicar cuarenta artículos por mes es posible; que los cuarenta digan algo que no esté en otro lado, no tanto.

La política completa, en su redacción oficial, está en la guía de Google sobre contenido creado con IA, y las políticas de spam en su documentación de spam.

3 de 4

Datos originales: publicar estudios que la IA cite

Un número que nadie más tiene es la forma más directa de volverse citable. Las tres maneras de conseguirlo y qué hay que escribir al lado para que valga.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Cualquiera puede explicar mejor que vos lo que ya se sabe. Nadie puede publicar tu número sin nombrarte.

Por qué un dato propio se cita distinto

Un artículo explicativo compite con otros cien que explican lo mismo. La elección entre ellos depende de cuál está mejor escrito, mejor posicionado o mejor enlazado.

Un dato propio no compite: o se cita, o no se usa. Si alguien quiere decir “el 38 % de los sitios de X hace Y”, tiene que decir de dónde salió ese 38 %.

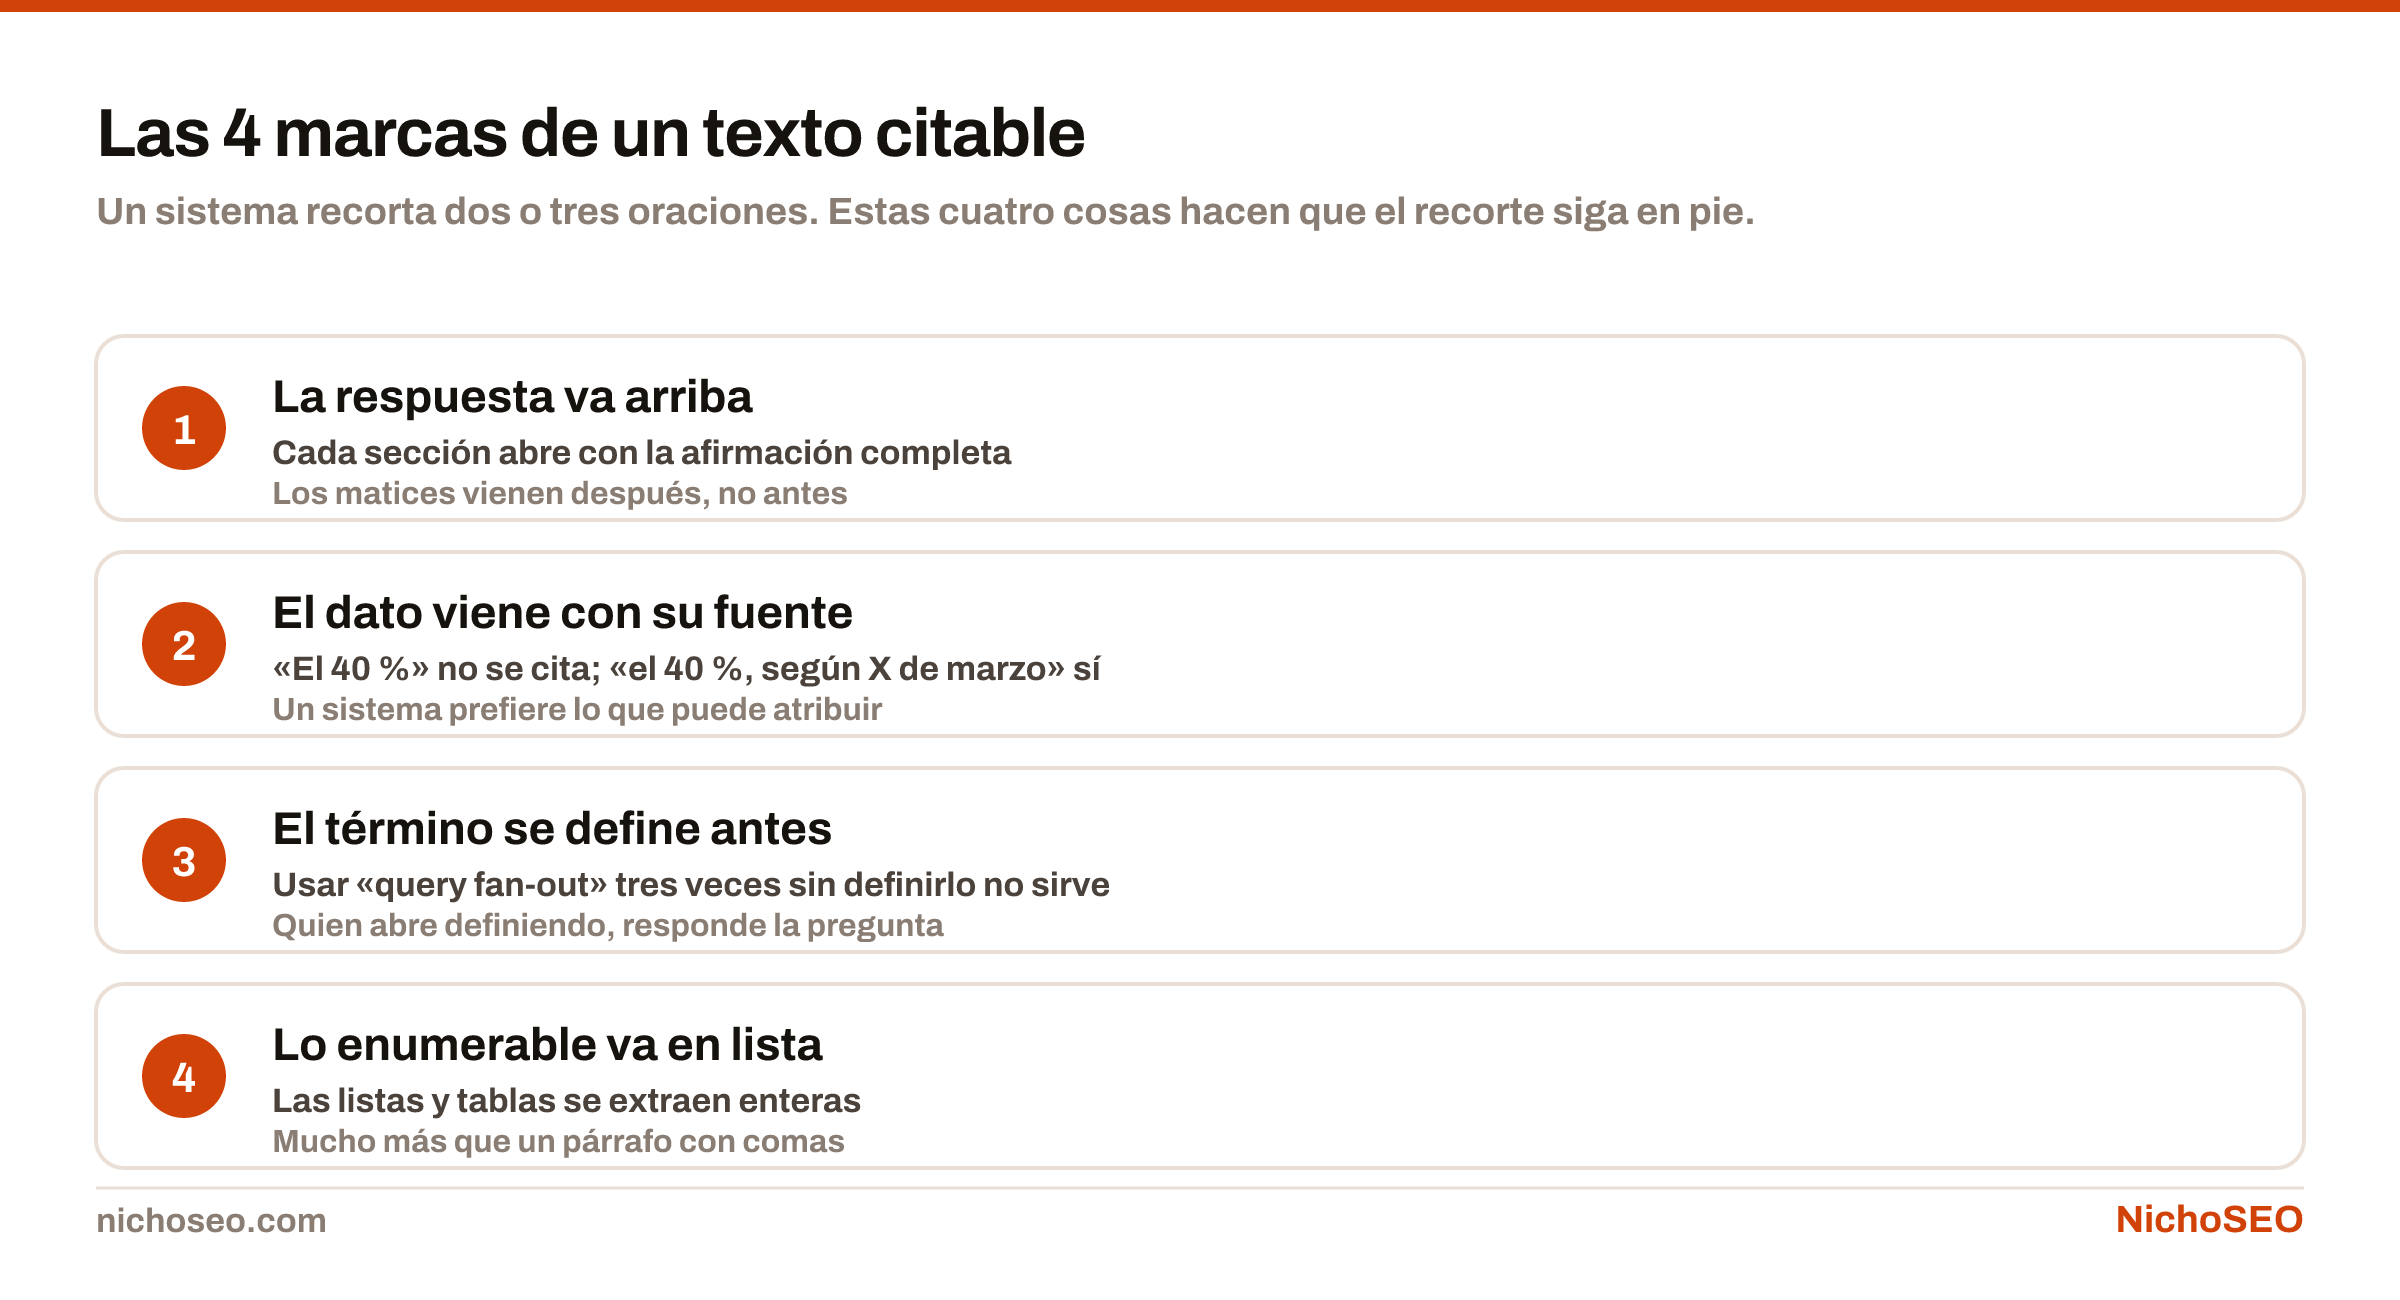
Las cuatro marcas de un texto citable: la respuesta arriba, el dato con su fuente, el término definido antes de discutirlo y lo enumerable en lista.
Un sistema recorta dos o tres oraciones. Estas cuatro cosas hacen que el recorte siga en pie.Descargar imagen

Es la segunda de las cuatro marcas de un texto citable, y la que más pesa de las cuatro. El desarrollo completo está en contenido citable.

Hay un efecto adicional que conviene conocer: un dato se cita en cadena. Alguien lo usa en una nota, otro cita esa nota, y el modelo ve tu número en varias fuentes distintas que coinciden. Eso es mucho más fuerte que una sola página tuya diciéndolo.

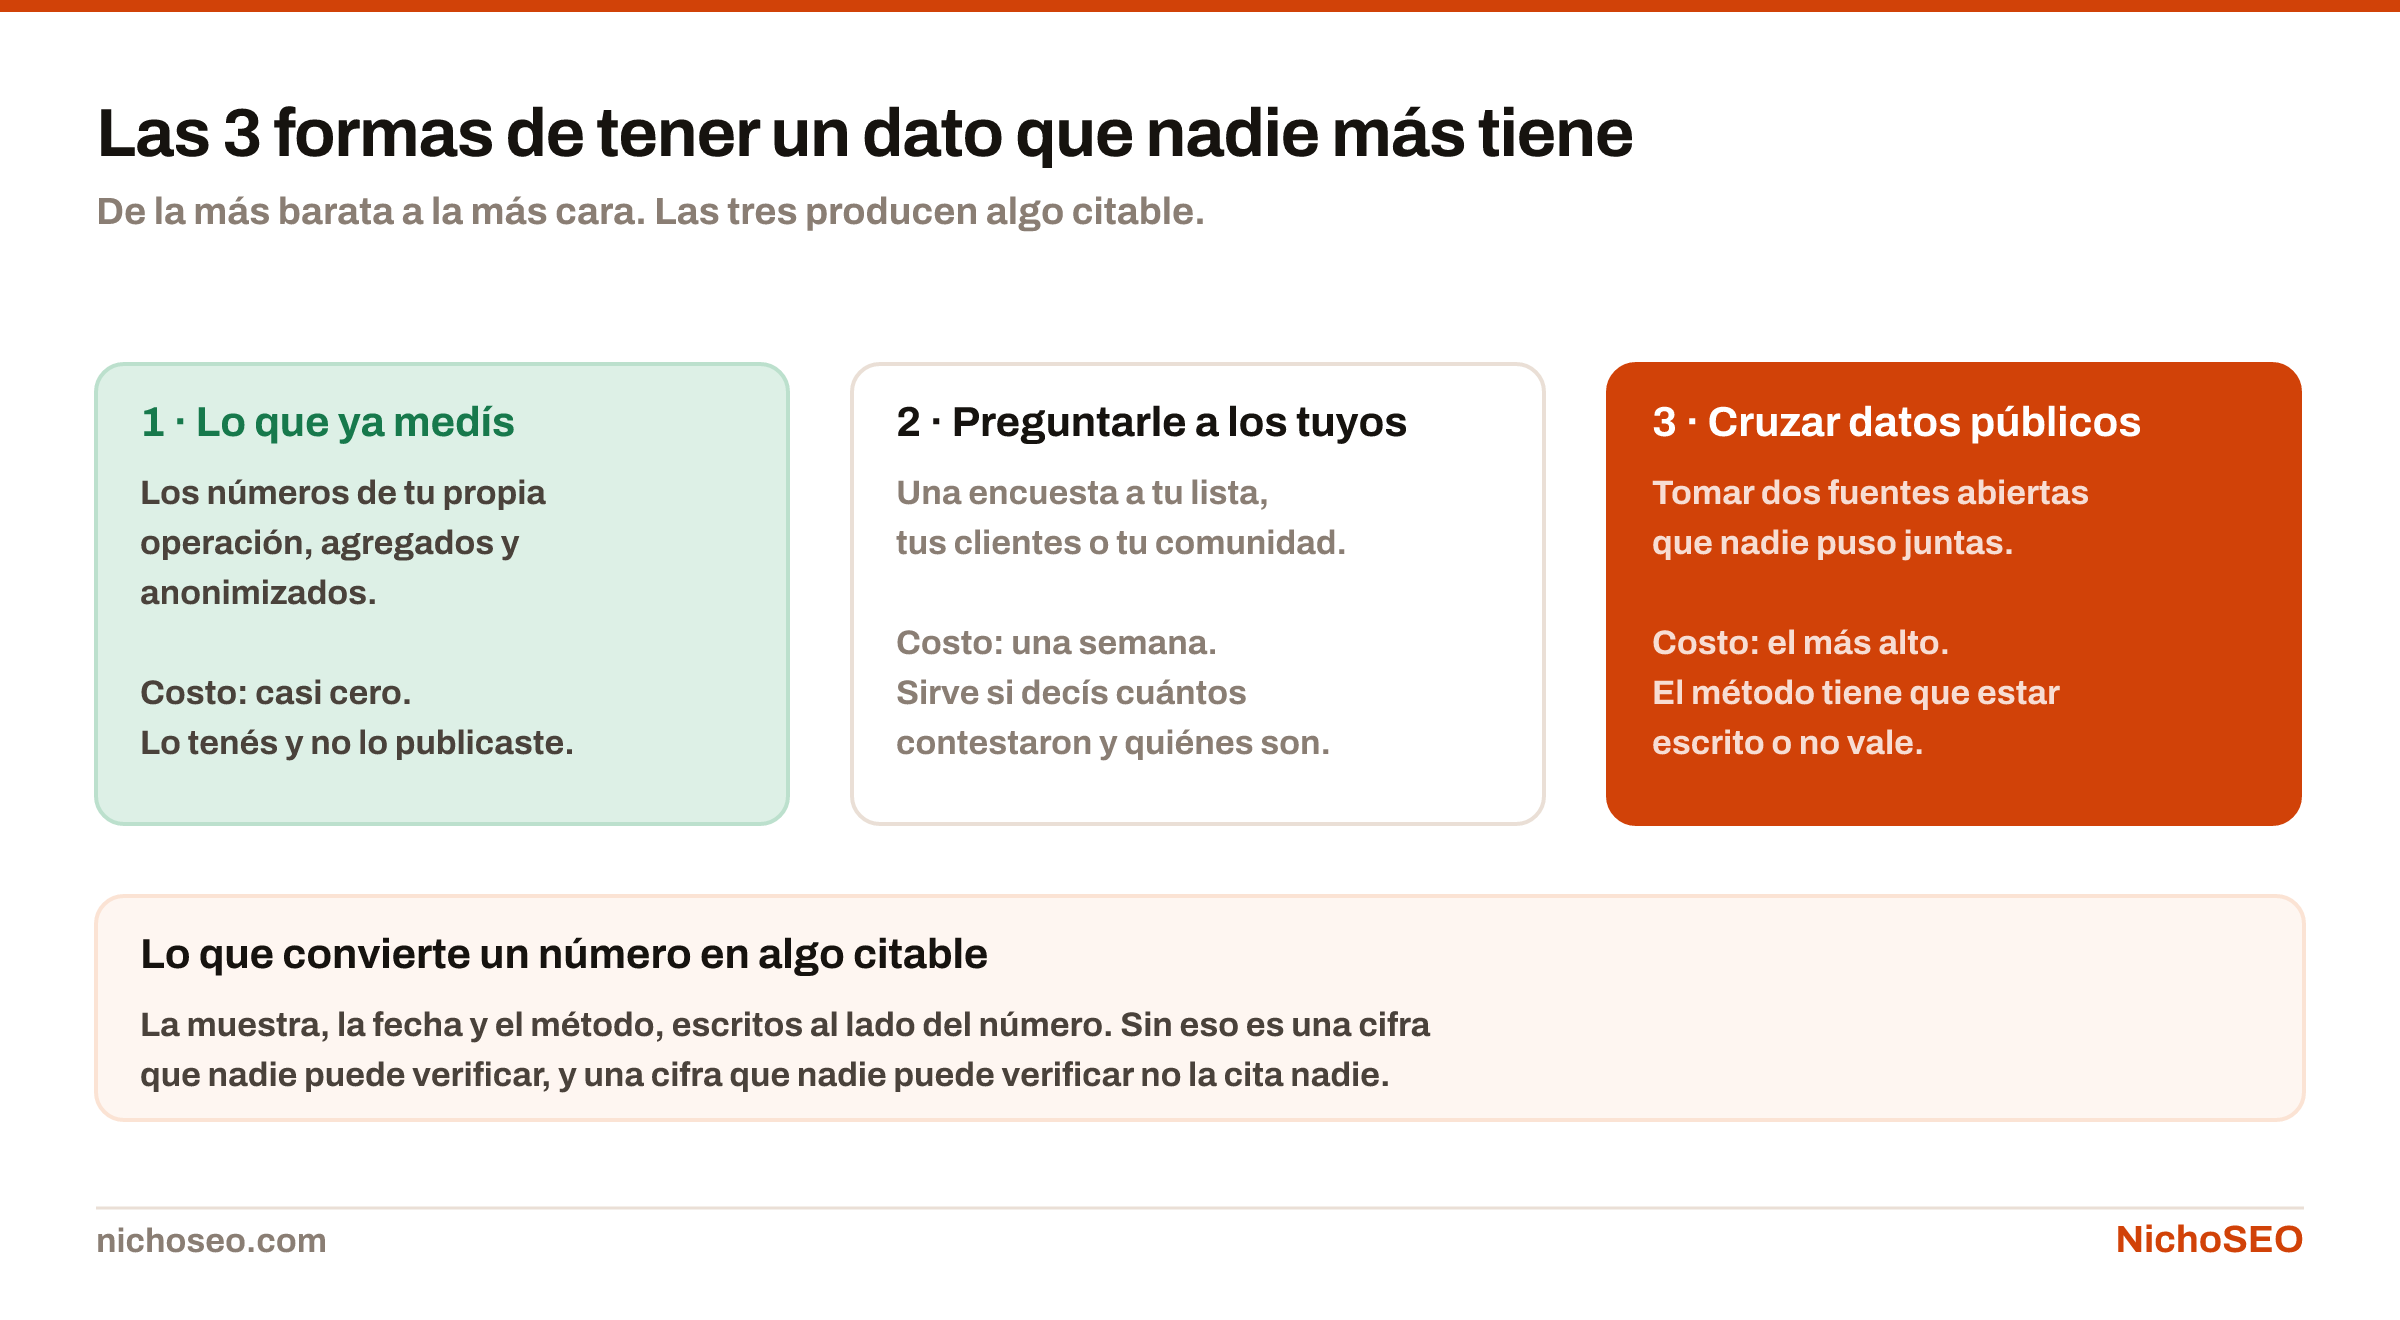
Las 3 formas de tener un dato que nadie más tiene

Las tres formas de producir datos originales citables: lo que ya medís en tu operación, una encuesta a tu propio público, y un análisis de datos públicos que nadie cruzó.
De la más barata a la más cara. Las tres producen algo citable.Descargar imagen

1. Publicar lo que ya medís

Es la más barata y la que casi nadie usa, porque no se siente como un estudio.

Cualquier operación produce números: cuánto tarda un proceso, qué proporción de los pedidos pide tal cosa, cuántas veces por mes aparece un problema. Agregados y anonimizados, esos números son datos que no existen en ningún otro lado.

Un ejemplo de la forma que toma: “de los 340 sitios que auditamos en 2025, 61 tenía el firewall bloqueando a OAI-SearchBot sin saberlo”. Ese número no está en internet, y quien quiera usarlo te va a nombrar.

El requisito es honestidad sobre la muestra: son tus clientes, no el universo. Decirlo no debilita el dato, lo vuelve usable.

2. Preguntarle a los tuyos

Una encuesta a tu lista, tus clientes o tu comunidad.

Es una semana de trabajo y produce algo publicable. Tiene el mismo límite que la anterior —tu público no representa a nadie más— y la misma solución: decirlo.

Lo que la arruina es fingir representatividad. “El 72 % de las pymes argentinas cree que…” cuando contestaron 40 personas de tu newsletter no es un dato, es una invención con decimales.

3. Cruzar datos públicos que nadie puso juntos

La más cara y la que más rinde cuando sale.

Hay muchísimos datos abiertos que nadie cruzó: registros públicos, bases de organismos, precios listados, resultados de búsqueda. Tomar dos fuentes y ponerlas en relación produce algo nuevo sin necesidad de medir nada.

Acá el método es todo. Si no está escrito cómo se hizo, el resultado no se puede verificar y no vale.

Lo que hay que escribir al lado del número

Un número solo no es un dato: es una afirmación.

Un dato que se puede citar

  • «De 340 sitios auditados entre enero y junio de 2026»
  • «Medido con los registros de acceso de cada sitio»
  • «Clientes propios, de 8 rubros, en Argentina y Uruguay»
  • «La tabla completa, abajo, en texto»

Un número que nadie va a usar

  • «Según nuestros estudios»
  • «Se sabe que la mayoría...»
  • «Un 61 % de los sitios» (¿cuáles?)
  • El número solo dentro de una infografía
Sin muestra, fecha y método, el número no es verificable ni por una persona ni por un modelo.

Las cuatro cosas que tienen que estar, siempre:

  1. Cuántos casos. El tamaño de la muestra, en números absolutos.
  2. De dónde salieron. Quiénes son, de qué rubro, de qué país.
  3. Cuándo se midió. Con mes y año, no “recientemente”.
  4. Cómo se midió. En dos o tres oraciones, o con un enlace al detalle.

Ese cuarto punto es el que separa un dato de una afirmación de marketing, y es el que más se omite.

Cómo publicarlo para que se pueda citar

Tres decisiones de formato que deciden si el trabajo sirve.

Como página, no como PDF. Un PDF descargable es texto que la mayoría de los rastreadores lee peor o no lee. El estudio va en una URL, en HTML.

El número en texto, no solo en el gráfico. Una infografía preciosa con el dato dibujado adentro es un dato que un modelo no puede leer. La cifra tiene que estar escrita en un párrafo, aunque también esté en la imagen.

La tabla completa, si la hay. Publicar los datos en bruto, o al menos la tabla agregada, multiplica la probabilidad de que alguien los use.

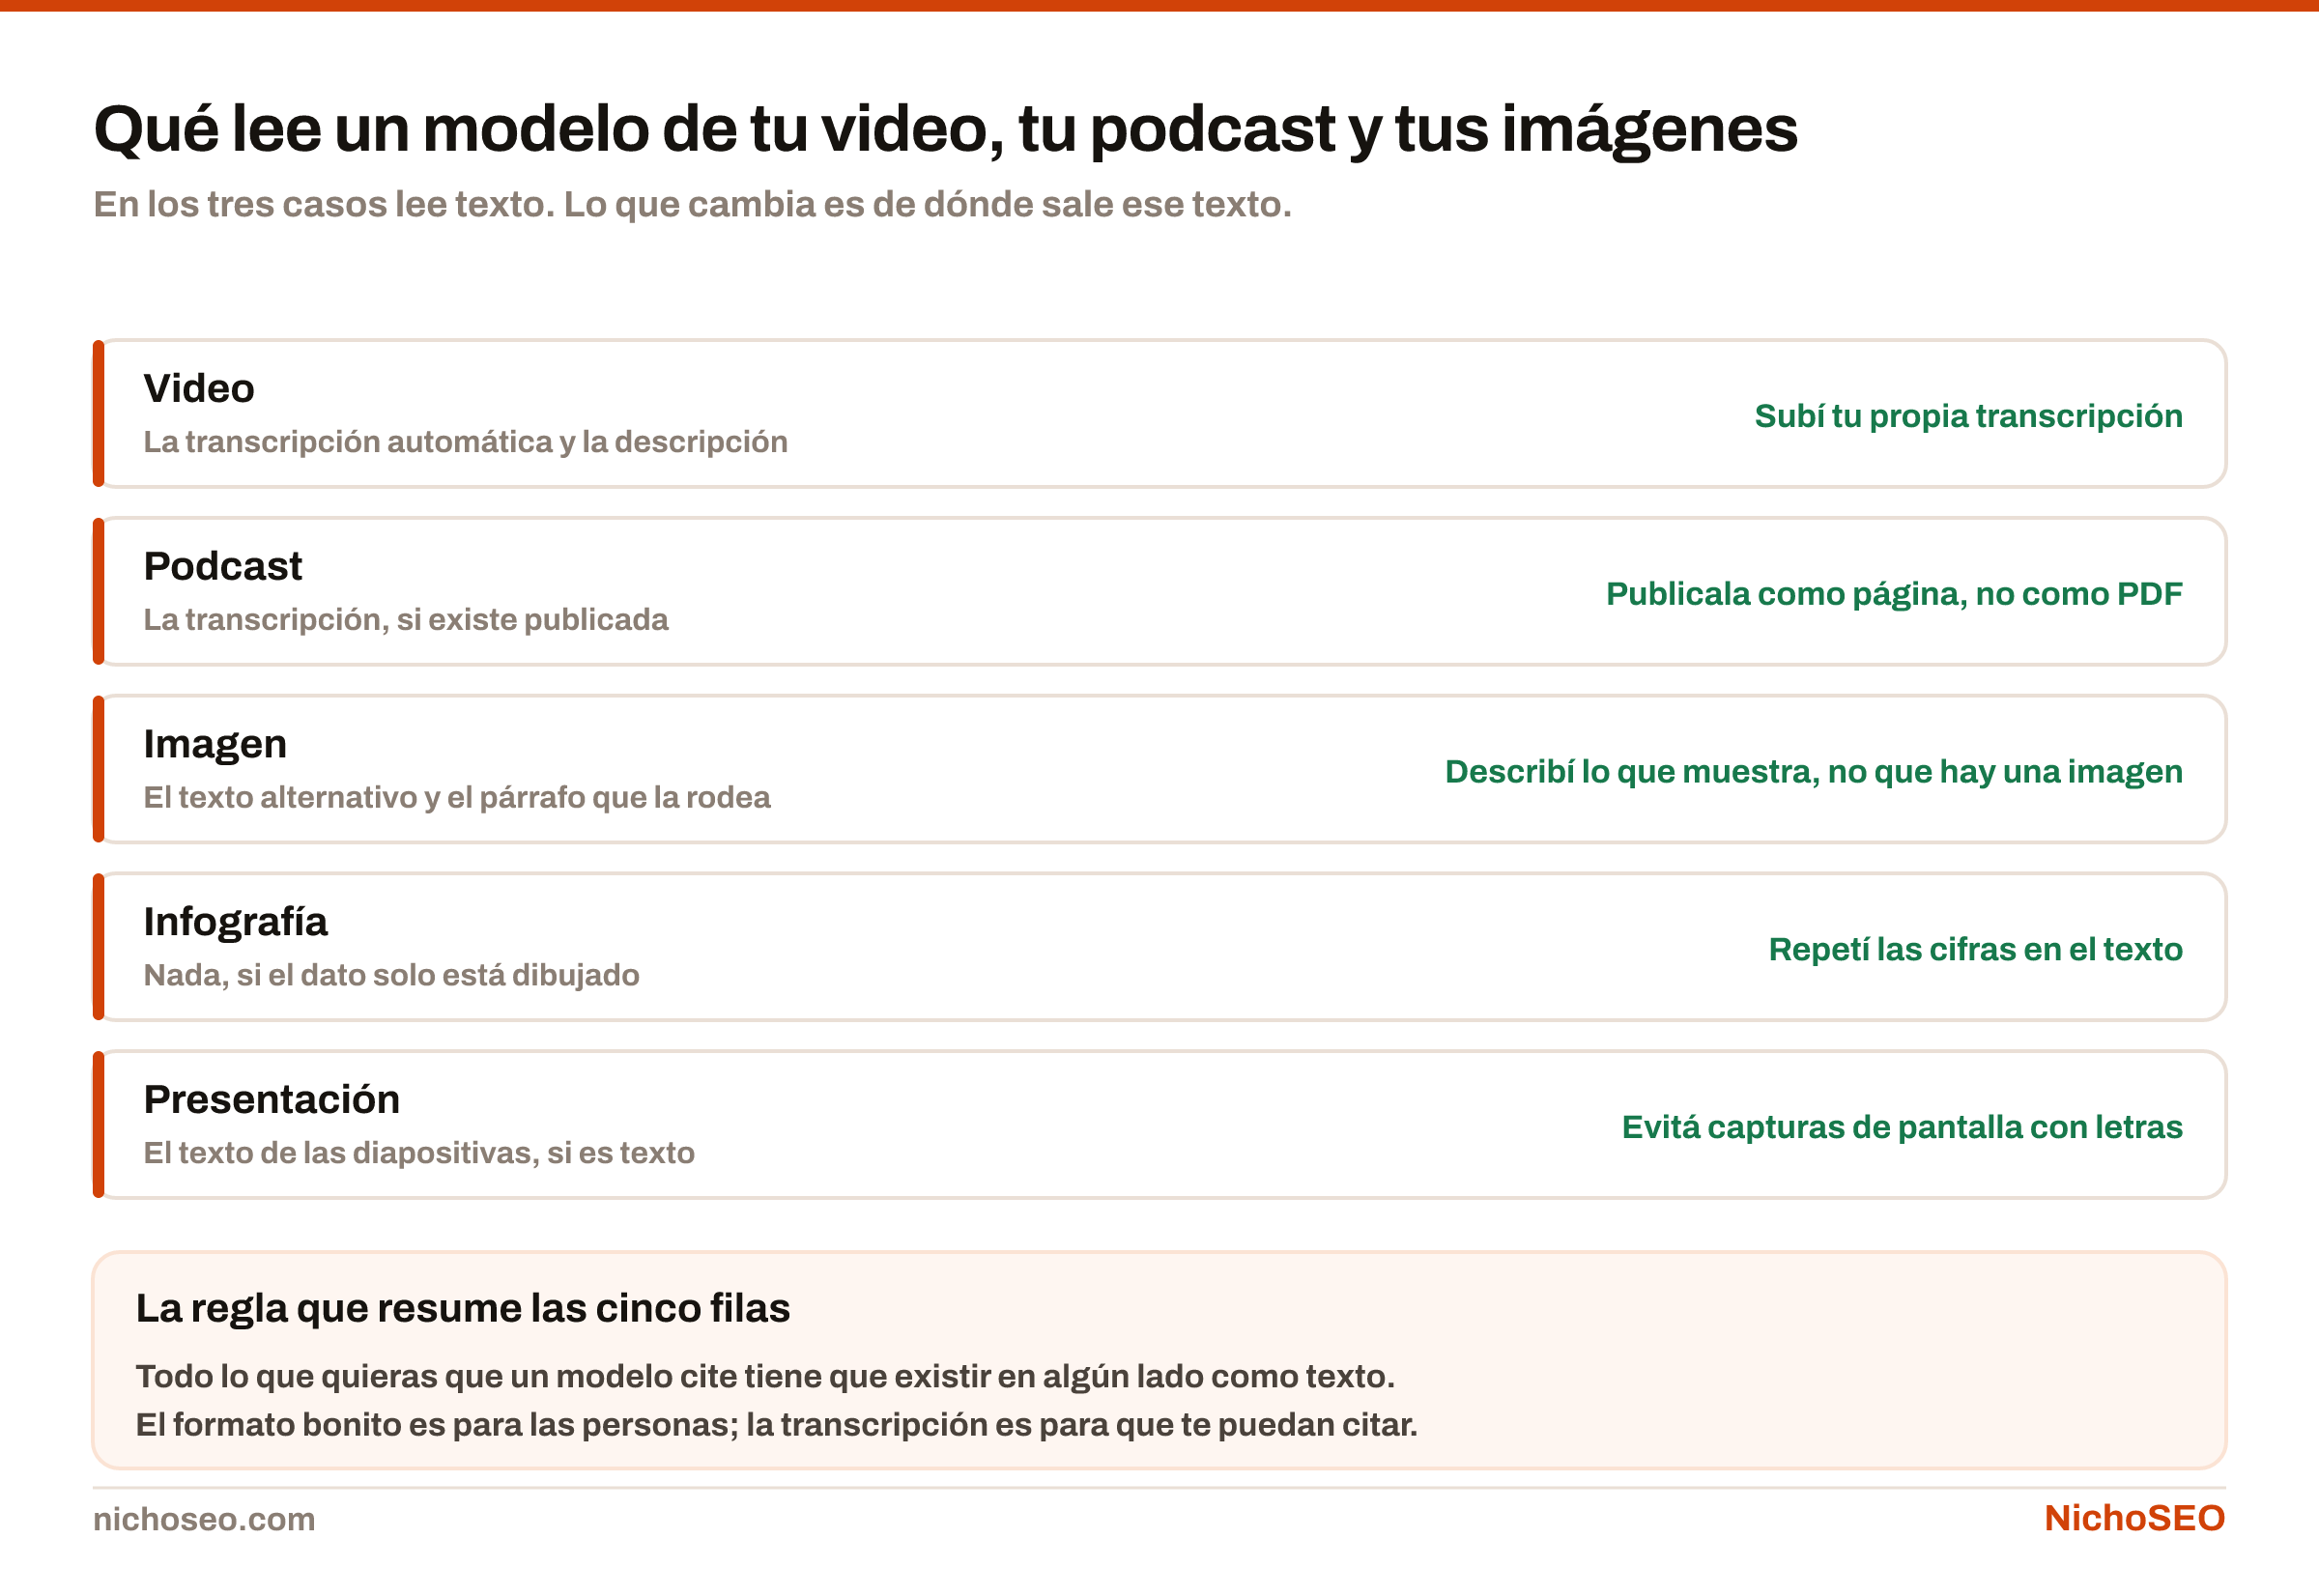
Qué extrae un modelo de cada formato no textual: del video la transcripción y la descripción, del podcast la transcripción publicada, y de las imágenes el texto alternativo y el que las rodea.
En los tres casos lee texto. Lo que cambia es de dónde sale ese texto.Descargar imagen

Es la misma regla que se aplica a cualquier formato que no sea texto: si querés que te citen, tiene que existir como texto en algún lado. El desarrollo está en GEO multimodal.

El detalle que multiplica el efecto: repetirlo cada año

Un estudio publicado una vez es una cifra. El mismo estudio repetido tres años es una serie, y una serie es mucho más citable que un número suelto.

Qué gana un estudio que se repite

Año 1Un datoSe cita si a alguien le sirve
Año 2Una comparación«Subió del 61 % al 68 %» ya es una noticia
Año 3Una referenciaPasa a ser la fuente del tema
El costo del año 2 y del 3 es mucho menor: el método ya está hecho.

El trabajo pesado es el primero. A partir de ahí, repetir la medición con el mismo método cuesta una fracción y cada edición vale más que la anterior.

El error de inventar el dato

Hay que decirlo porque pasa: la tentación de redondear, de estimar y presentarlo como medido, o de citar “nuestros estudios” sin que haya ninguno.

No funciona por dos motivos. El primero es que un número inventado suele ser el único que dice eso, y cuando alguien intenta verificarlo no encuentra nada. El segundo es que arruina lo único que hace valioso el método: que tu nombre quede asociado a datos confiables.

La distinción entre lo que se puede verificar y lo que no está en E-E-A-T, y la diferencia entre un dato medido y uno estimado —que también vale para las herramientas que usás— en herramientas de keywords.

Por dónde empezar

Lo más rápido es la forma 1, y casi siempre ya tenés el dato.

  1. Escribí qué medís sin darte cuenta. Tiempos, proporciones, frecuencias, motivos de consulta. Cinco minutos de lista.
  2. Elegí el que le sirva a alguien que no sos vos. El criterio es si responde una pregunta que te hacen.
  3. Agregalo y anonimizalo. Nada que identifique a un cliente.
  4. Publicalo como página, con muestra, fecha y método al lado.
  5. Anotá en el calendario repetirlo en un año.

Para el formato en que conviene publicarlo y qué estructura lo hace extraíble, el criterio está en contenido citable; y si querés declararlo también en el marcado, qué hace y qué no está en el marcado Schema.

Un ejemplo público de esta práctica, hecha bien y repetida todos los años, es el informe de transparencia de Cloudflare sobre el tráfico de bots, que se cita en todas partes justamente porque publica el método.

4 de 4

GEO multimodal: qué lee la IA de tu video y tu podcast

En los tres casos lee texto; lo que cambia es de dónde sale. Qué hay que publicar para que un contenido que no es texto pueda citarse.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Esa frase resume el capítulo entero: todo lo demás son formas de asegurarse de que ese texto exista.

Qué extrae de cada formato

Qué extrae un modelo de cada formato no textual: del video la transcripción y la descripción, del podcast la transcripción publicada, y de las imágenes el texto alternativo y el que las rodea.
En los tres casos lee texto. Lo que cambia es de dónde sale ese texto.Descargar imagen

La columna del medio es la que sorprende. En los cinco formatos, lo que el modelo usa es texto, y en dos de los cinco ese texto puede directamente no existir.

Una infografía donde el dato está dibujado adentro es, para un rastreador, una imagen sin contenido. La cifra que tanto trabajo costó producir no está en ninguna parte que se pueda leer.

Video: la transcripción es el contenido

Un video en YouTube genera una transcripción automática. Eso es mejor que nada y bastante peor de lo que conviene.

Las automáticas fallan justo donde importa: los nombres propios, los términos técnicos, las cifras. Un video sobre “GPTBot” puede quedar transcrito como “GPT bot” o “chat bot”, y esa es exactamente la palabra por la que querías que te encontraran.

Un video que se puede citar

  • Transcripción propia, corregida, subida como subtítulos
  • Descripción con el contenido real, no «suscribite»
  • Capítulos con títulos que digan algo
  • Una página en tu sitio con el video y la transcripción

Uno que no

  • Solo la transcripción automática
  • Descripción con enlaces y nada más
  • Sin capítulos, o con «intro / tema / cierre»
  • El video incrustado sin nada de texto alrededor
La cuarta fila es la que más rinde y la que casi nadie hace.

La cuarta merece detalle: publicar el video en tu propio sitio con la transcripción escrita debajo. Eso convierte un contenido que vive en una plataforma ajena en una página tuya, con texto, que un modelo puede citar y enlazar.

Los capítulos funcionan como encabezados: dividen el video en partes con título y permiten que se cite un tramo concreto. Un capítulo que dice “Cómo comprobarlo en los logs” sirve; uno que dice “Parte 2” no.

Podcast: publicá la transcripción como página

Es el formato con la brecha más grande entre el trabajo invertido y lo que un modelo puede usar.

Una hora de conversación con información que no está en ningún otro lado, y si no hay transcripción publicada, para un modelo no existe.

Lo que hace falta:

  1. Una página por episodio, en tu sitio, no solo en la plataforma de audio.
  2. La transcripción completa en HTML, con los nombres de quién dice qué.
  3. Encabezados dentro de la transcripción, cada cinco o diez minutos, que digan de qué se habla.
  4. Un resumen arriba con lo que se responde en el episodio.

El punto 4 es el más rentable: un resumen de cinco líneas al principio es lo más fácil de extraer de toda la página, y es lo que un modelo va a citar si tiene que responder algo rápido.

La transcripción automática también sirve como punto de partida acá, pero conviene pasarla por una corrección de nombres propios y cifras antes de publicarla.

Imágenes: el alt tiene que decir qué muestra

El texto alternativo es el campo más maltratado de la web.

La mayoría dice “imagen”, “gráfico” o repite el título del artículo. Nada de eso informa, ni a un lector de pantalla ni a un rastreador.

Lo que tiene que decir un texto alternativo

Quémuestra la imagenEl contenido, no el formato
Los datossi es un gráficoLas cifras principales, escritas
Nunca«imagen de...»Ya se sabe que es una imagen
La misma descripción sirve para accesibilidad y para que un modelo entienda qué hay ahí.

Un ejemplo de la diferencia. Mal: alt="gráfico de bots". Bien: alt="Los seis rastreadores de IA más frecuentes, con de quién es cada uno y si entrena modelos o responde consultas en vivo".

El segundo tiene otra ventaja: si la imagen no carga, el texto solo sigue informando.

Y hay una regla que viene de ahí: si un dato importa, repetilo en el texto del artículo. La imagen es para que se entienda de un vistazo; el párrafo es para que se pueda citar.

Por qué las infografías rinden menos de lo que parece

Son el formato que más se comparte y el que peor se cita.

Toda la información está dibujada. Un rastreador ve un archivo de imagen y un texto alternativo, que en el mejor de los casos resume una parte.

Eso no significa que no sirvan: sirven para que la gente las comparta, y cuando alguien las publica en su sitio suele acompañarlas de texto que sí se lee. Pero no reemplazan al artículo: lo acompañan.

La forma de aprovecharlas es la obvia y la que casi nadie hace: publicar las cifras de la infografía también como tabla o como párrafos. Mismo trabajo, dos formatos, y uno de los dos se puede citar.

Las cuatro marcas de un texto citable: la respuesta arriba, el dato con su fuente, el término definido antes de discutirlo y lo enumerable en lista.
Un sistema recorta dos o tres oraciones. Estas cuatro cosas hacen que el recorte siga en pie.Descargar imagen

Visto así, una infografía aporta la primera marca —estructura— y se pierde la segunda, que es el dato extraíble. El texto al lado recupera esa segunda.

Cómo publicar datos propios para que se citen está en datos originales.

Qué pasa con los modelos que “ven” imágenes

Es la objeción razonable: varios modelos procesan imágenes directamente.

Es cierto, y cambia menos de lo que parece para este problema. Lo que un modelo puede describir de una imagen cuando alguien se la muestra no es lo mismo que lo que indexa de tu sitio para responder una consulta.

El pipeline que arma la respuesta —recuperar fuentes, leerlas, citarlas— trabaja sobre texto. Cómo funciona ese proceso está en RAG explicado para SEOs.

Las tres etapas de un sistema RAG: recuperar documentos, seleccionar unos pocos y redactar la respuesta con ellos delante.
La primera decide casi todo: un documento que no se recupera nunca llega a la mesa donde se elige a quién citar.Descargar imagen

Así que la regla se mantiene, aunque por un motivo distinto del que se suele dar: no es que los modelos no puedan ver imágenes, es que la etapa en la que se decide a quién citar trabaja con texto.

La regla que resume todo

Todo lo que quieras que se cite tiene que existir como texto en una URL tuya.

El video, el podcast y la infografía son para las personas: son mejores que un artículo para explicar algunas cosas y para que alguien las comparta.

La transcripción, la tabla y el párrafo son para que te puedan citar. No compiten: van juntos, en la misma página.

Por dónde empezar

  1. Tomá tu contenido no textual con más tráfico o más escuchas. Uno solo.
  2. Publicalo en tu sitio como página, con el texto completo debajo.
  3. Revisá los nombres propios y las cifras de la transcripción automática. Es donde falla.
  4. Poné encabezados cada cinco o diez minutos de contenido.
  5. Repetí las cifras del gráfico en el texto, si hay gráficos.

Para el formato de la página, lo que hace que sea extraíble está en contenido citable, y el panorama de cómo cita cada motor —y cuánto tráfico deja cada formato— en cómo citan las IAs.

La documentación de YouTube sobre cómo subir tus propios subtítulos, que es el paso que más rinde de toda esta entrada, está en su centro de ayuda.