

Puntos clave
- RAG es recuperar documentos en el momento y dárselos al modelo como contexto para que redacte con ellos delante.
- Es lo que permite que una respuesta lleve citas: el modelo no recuerda la fuente, la tiene a la vista.
- El cuello de botella está en la recuperación, no en la redacción. Si tu página no entra en ese puñado de documentos, nada de lo que escribas después importa.
- Por eso el SEO no quedó obsoleto: pasó de ser el final del embudo a ser la puerta de entrada.
Las siglas vienen de retrieval-augmented generation: generación aumentada por recuperación. Suena a jerga de laboratorio y describe algo bastante doméstico — la diferencia entre contestar de memoria y contestar con el libro abierto.
Es el mecanismo detrás de casi toda respuesta con citas que hayas visto en ChatGPT, Perplexity o AI Overview, y por eso entenderlo es lo que separa trabajar con criterio de probar cosas a ver qué pasa.
Qué problema resuelve RAG: por qué un modelo solo no puede citar
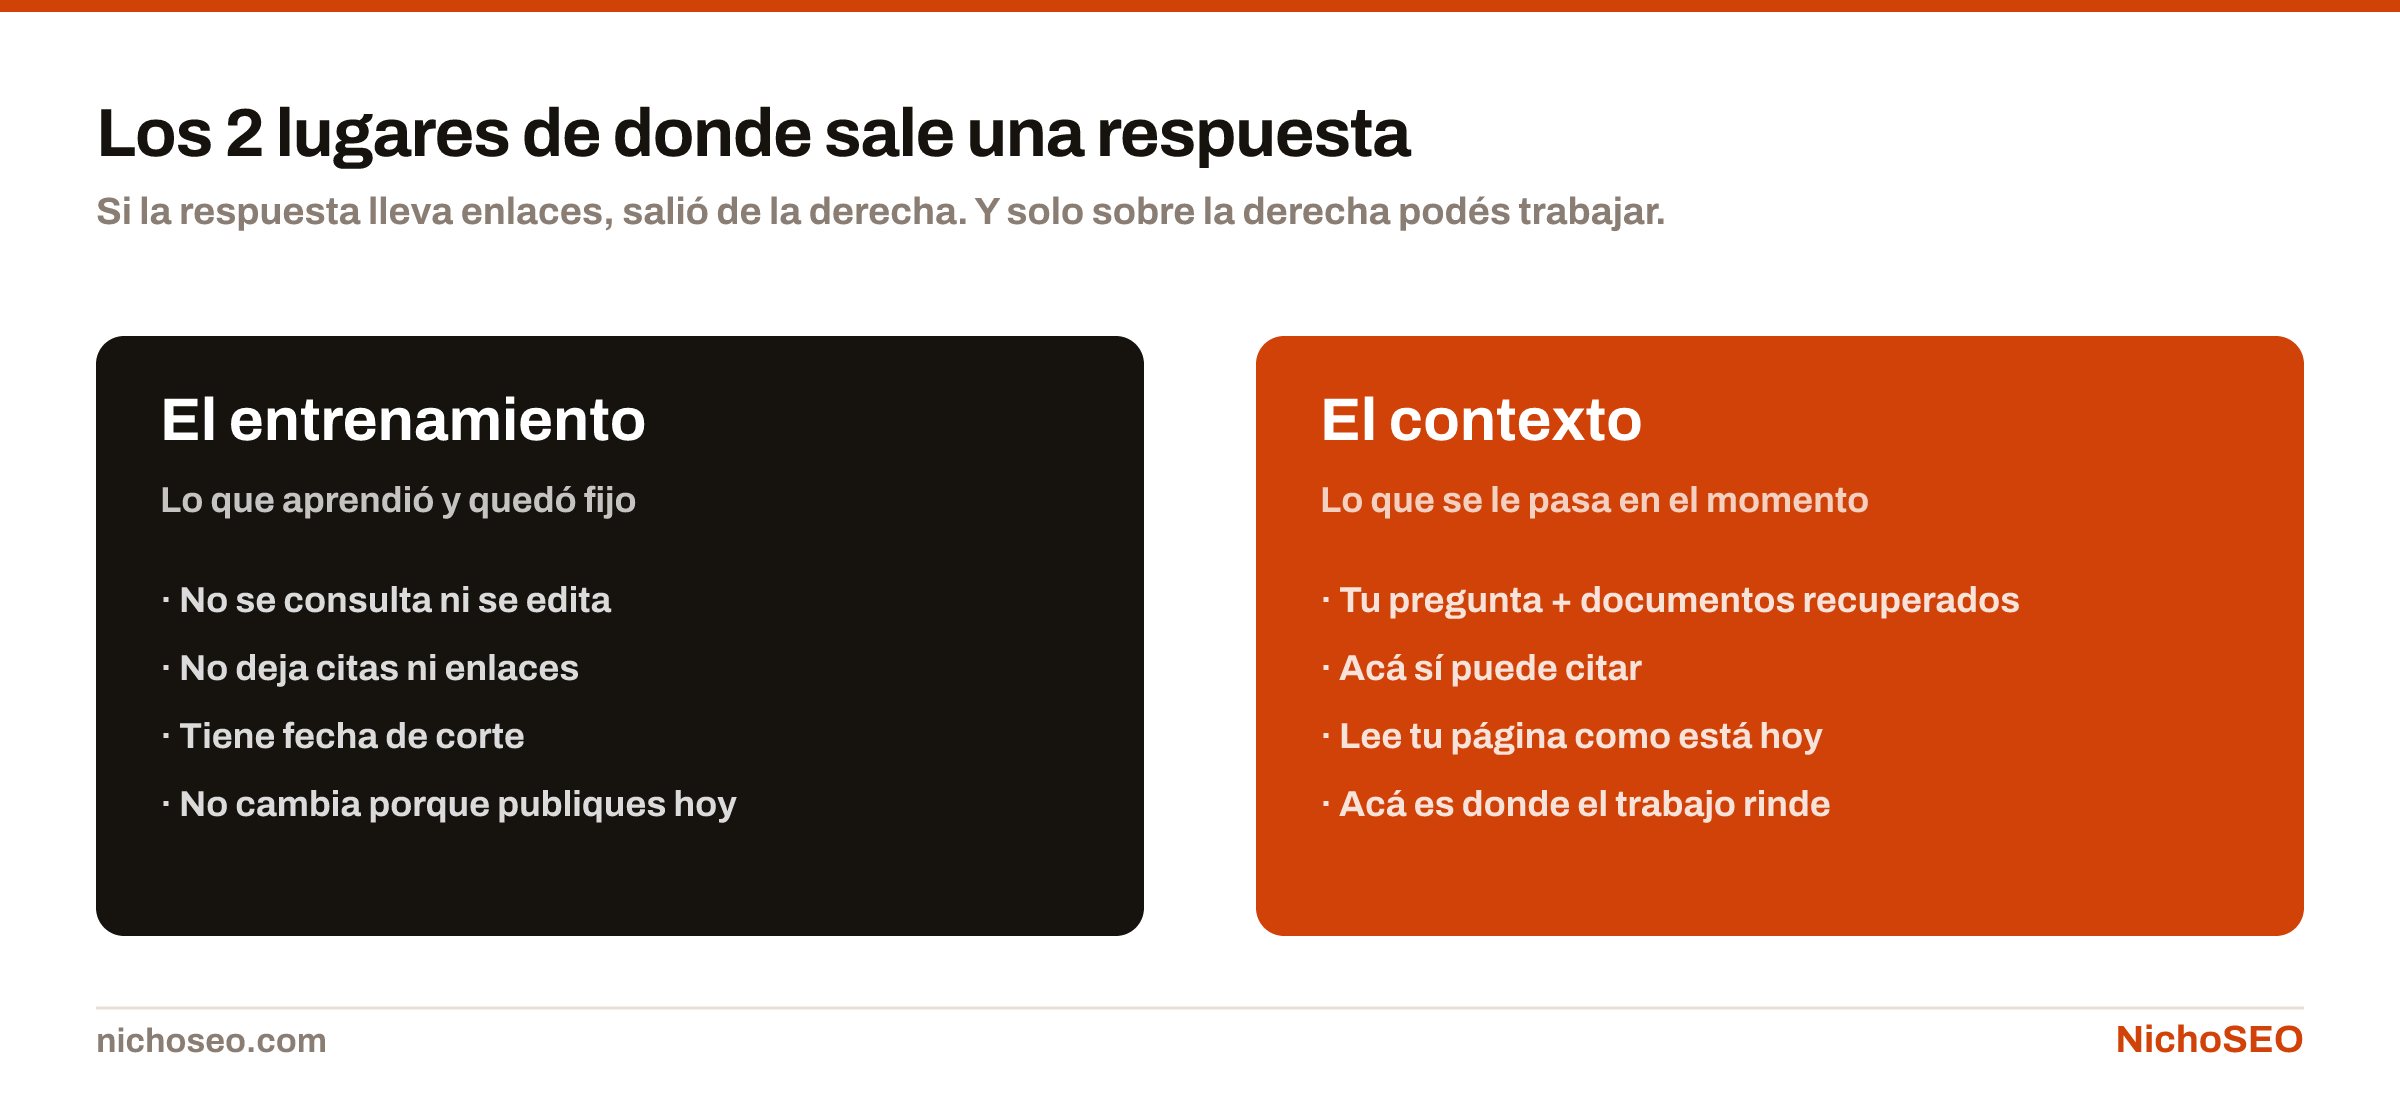
Para entender por qué existe hace falta ver qué le falta a un modelo solo.
Un modelo de lenguaje genera texto prediciendo qué palabra sigue, a partir de lo que aprendió durante su entrenamiento. Eso le deja dos limitaciones grandes, y las dos son fatales para responder preguntas sobre el mundo real.
La primera es que su conocimiento está congelado. Lo que aprendió se cerró el día que terminó el entrenamiento. Una pregunta sobre algo de esta semana no tiene respuesta posible ahí adentro.
La segunda es más sutil y más importante para este oficio: no puede citar. Durante el entrenamiento el modelo absorbió patrones, no fichas bibliográficas. Sabe cómo se habla de un tema sin recordar en qué página lo leyó. Pedirle la fuente de algo que aprendió así es pedirle que invente una, y eso es exactamente lo que hace.
Poner documentos delante resuelve las dos cosas de una sola vez. El modelo puede hablar de algo publicado ayer, porque el texto de ayer está en la mesa. Y puede señalar la fuente, porque la tiene a la vista mientras escribe.
Ahí está el punto que importa para quien produce contenido: las citas con enlace no salen de la memoria del modelo, salen de un documento que alguien recuperó hace segundos. Ese documento puede ser tuyo.
Las 3 etapas de RAG: recuperar, seleccionar y redactar
Todo sistema RAG hace lo mismo, en tres tiempos. Vale mirarlos por separado porque cada uno lo decide un actor distinto, y solo en uno de los tres podés intervenir de verdad.
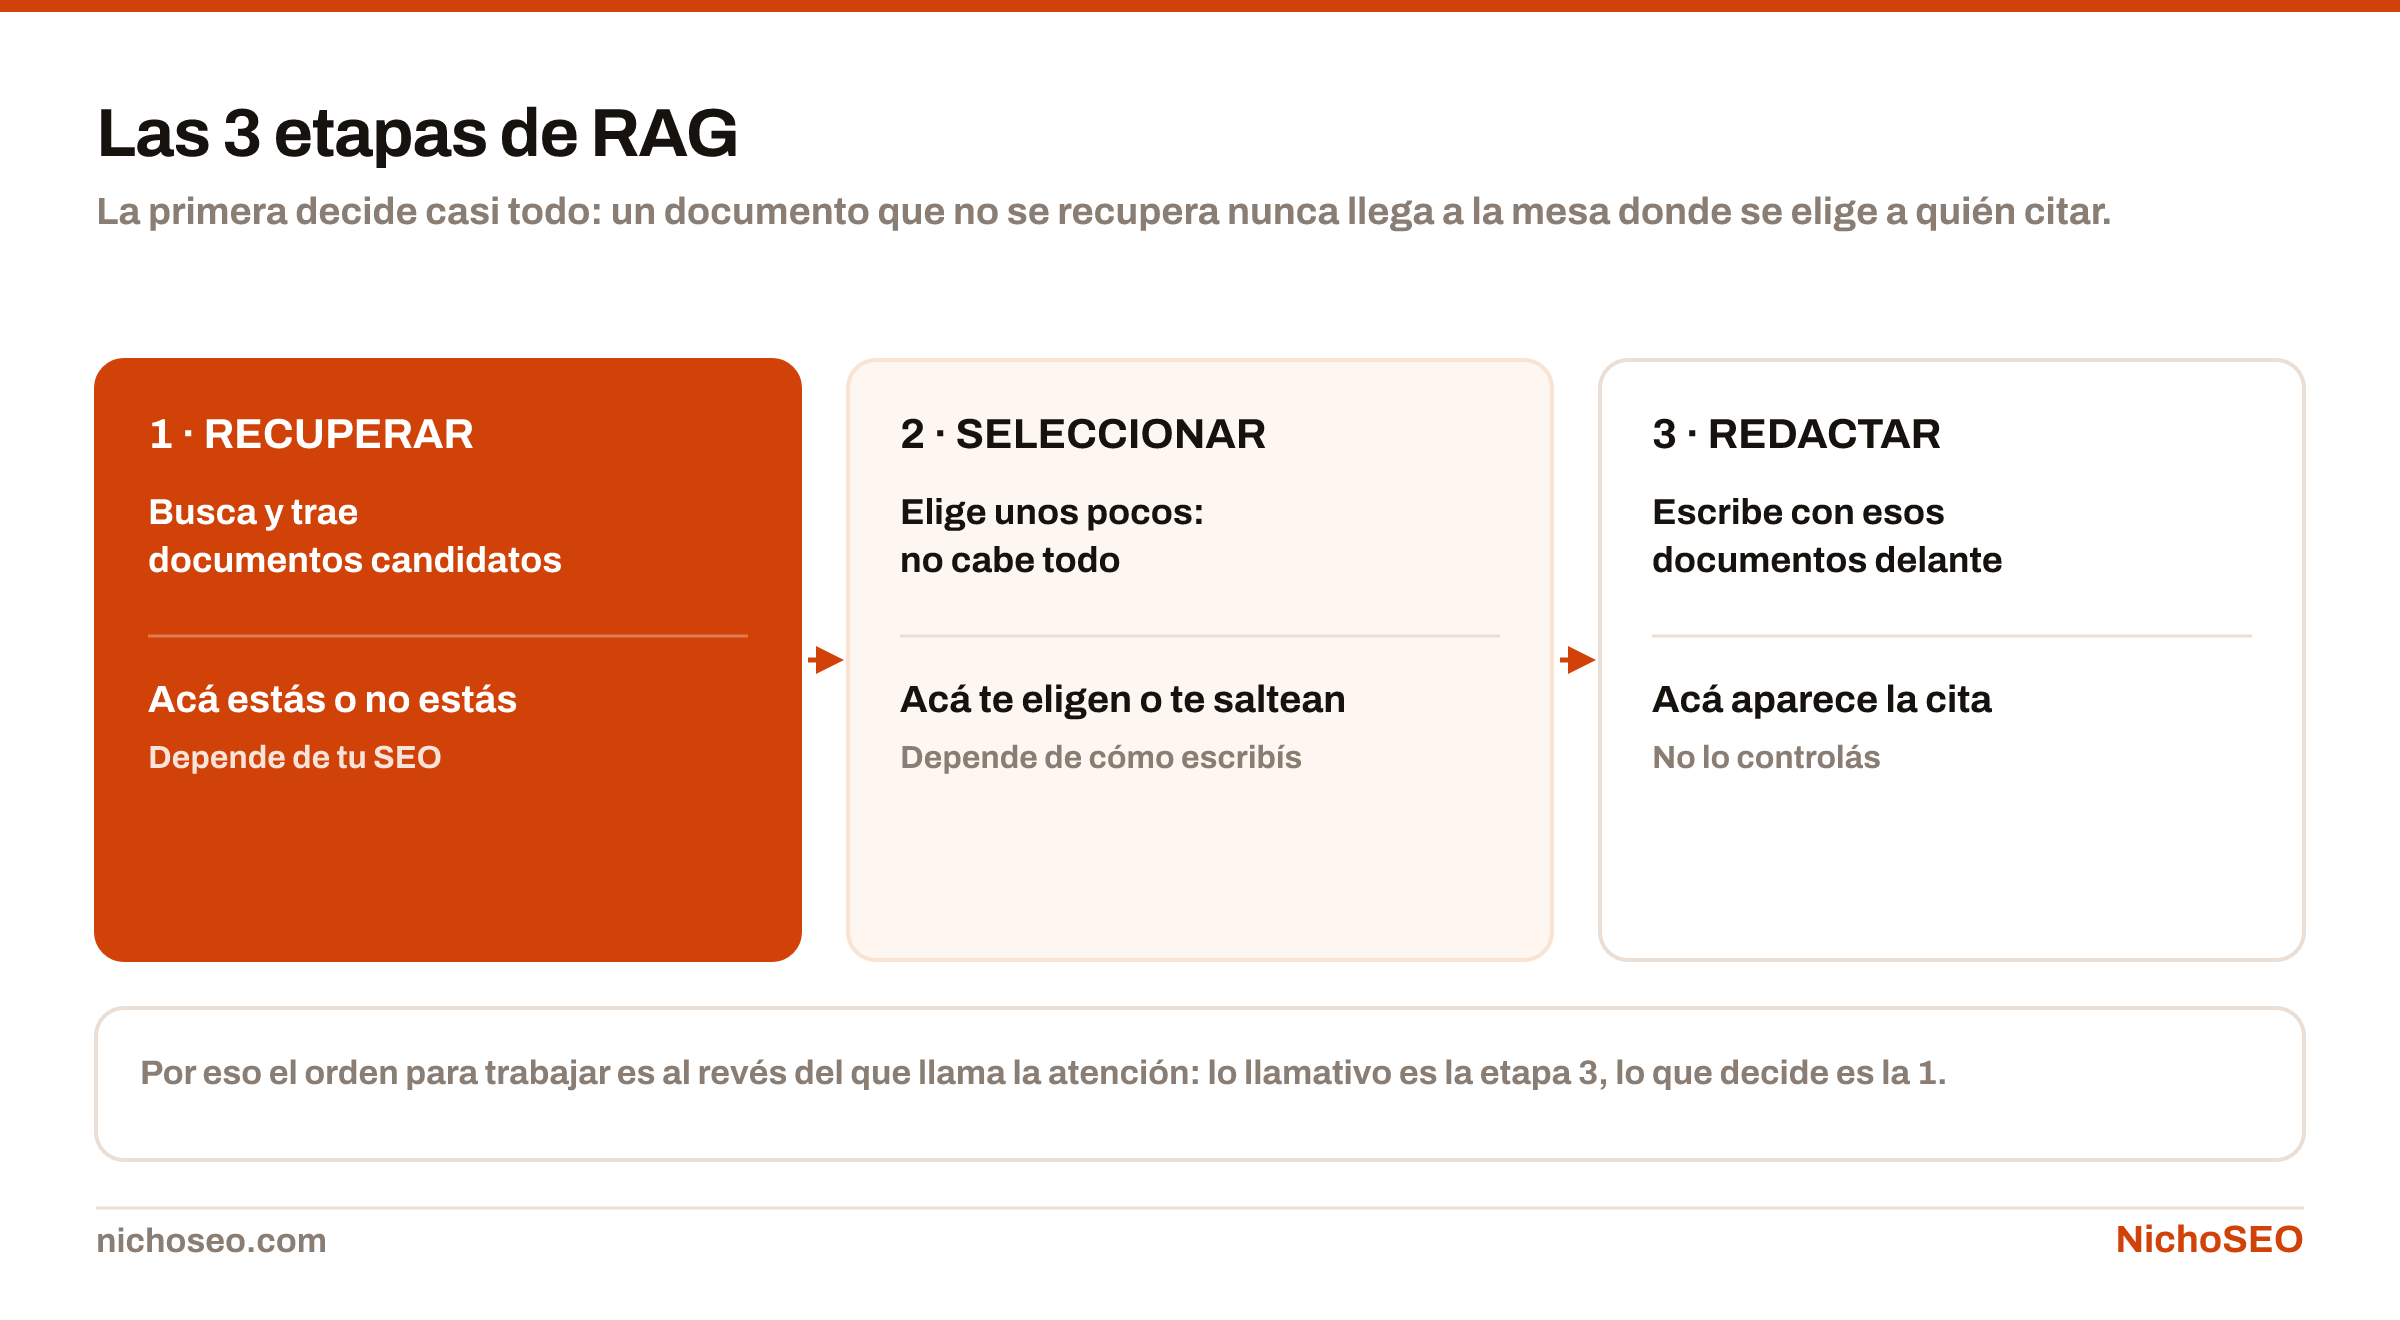
De las tres etapas, la primera decide casi todo. Un contenido excelente que no entra en la recuperación no compite: nunca llega a la mesa donde se elige a quién citar.
1. Recuperar. El sistema convierte la pregunta en una o varias consultas y trae documentos candidatos. Acá es donde tu página está o no está, y es la etapa que más se parece al SEO de siempre.
2. Seleccionar. De los candidatos se eligen unos pocos, porque la ventana de contexto no da para más. Se prefieren los que responden de forma directa y verificable.
3. Redactar. El modelo escribe usando esos documentos y marca de cuál salió cada afirmación.
Qué significa RAG para tu trabajo de SEO
La consecuencia más importante es poco glamorosa:
Si no aparecés en los resultados que alimentan la recuperación, no hay optimización posible aguas abajo. La etapa tres nunca te ve.
De ahí que el SEO clásico —indexación, autoridad, cobertura del tema— no sea una tarea paralela al GEO sino su condición previa.
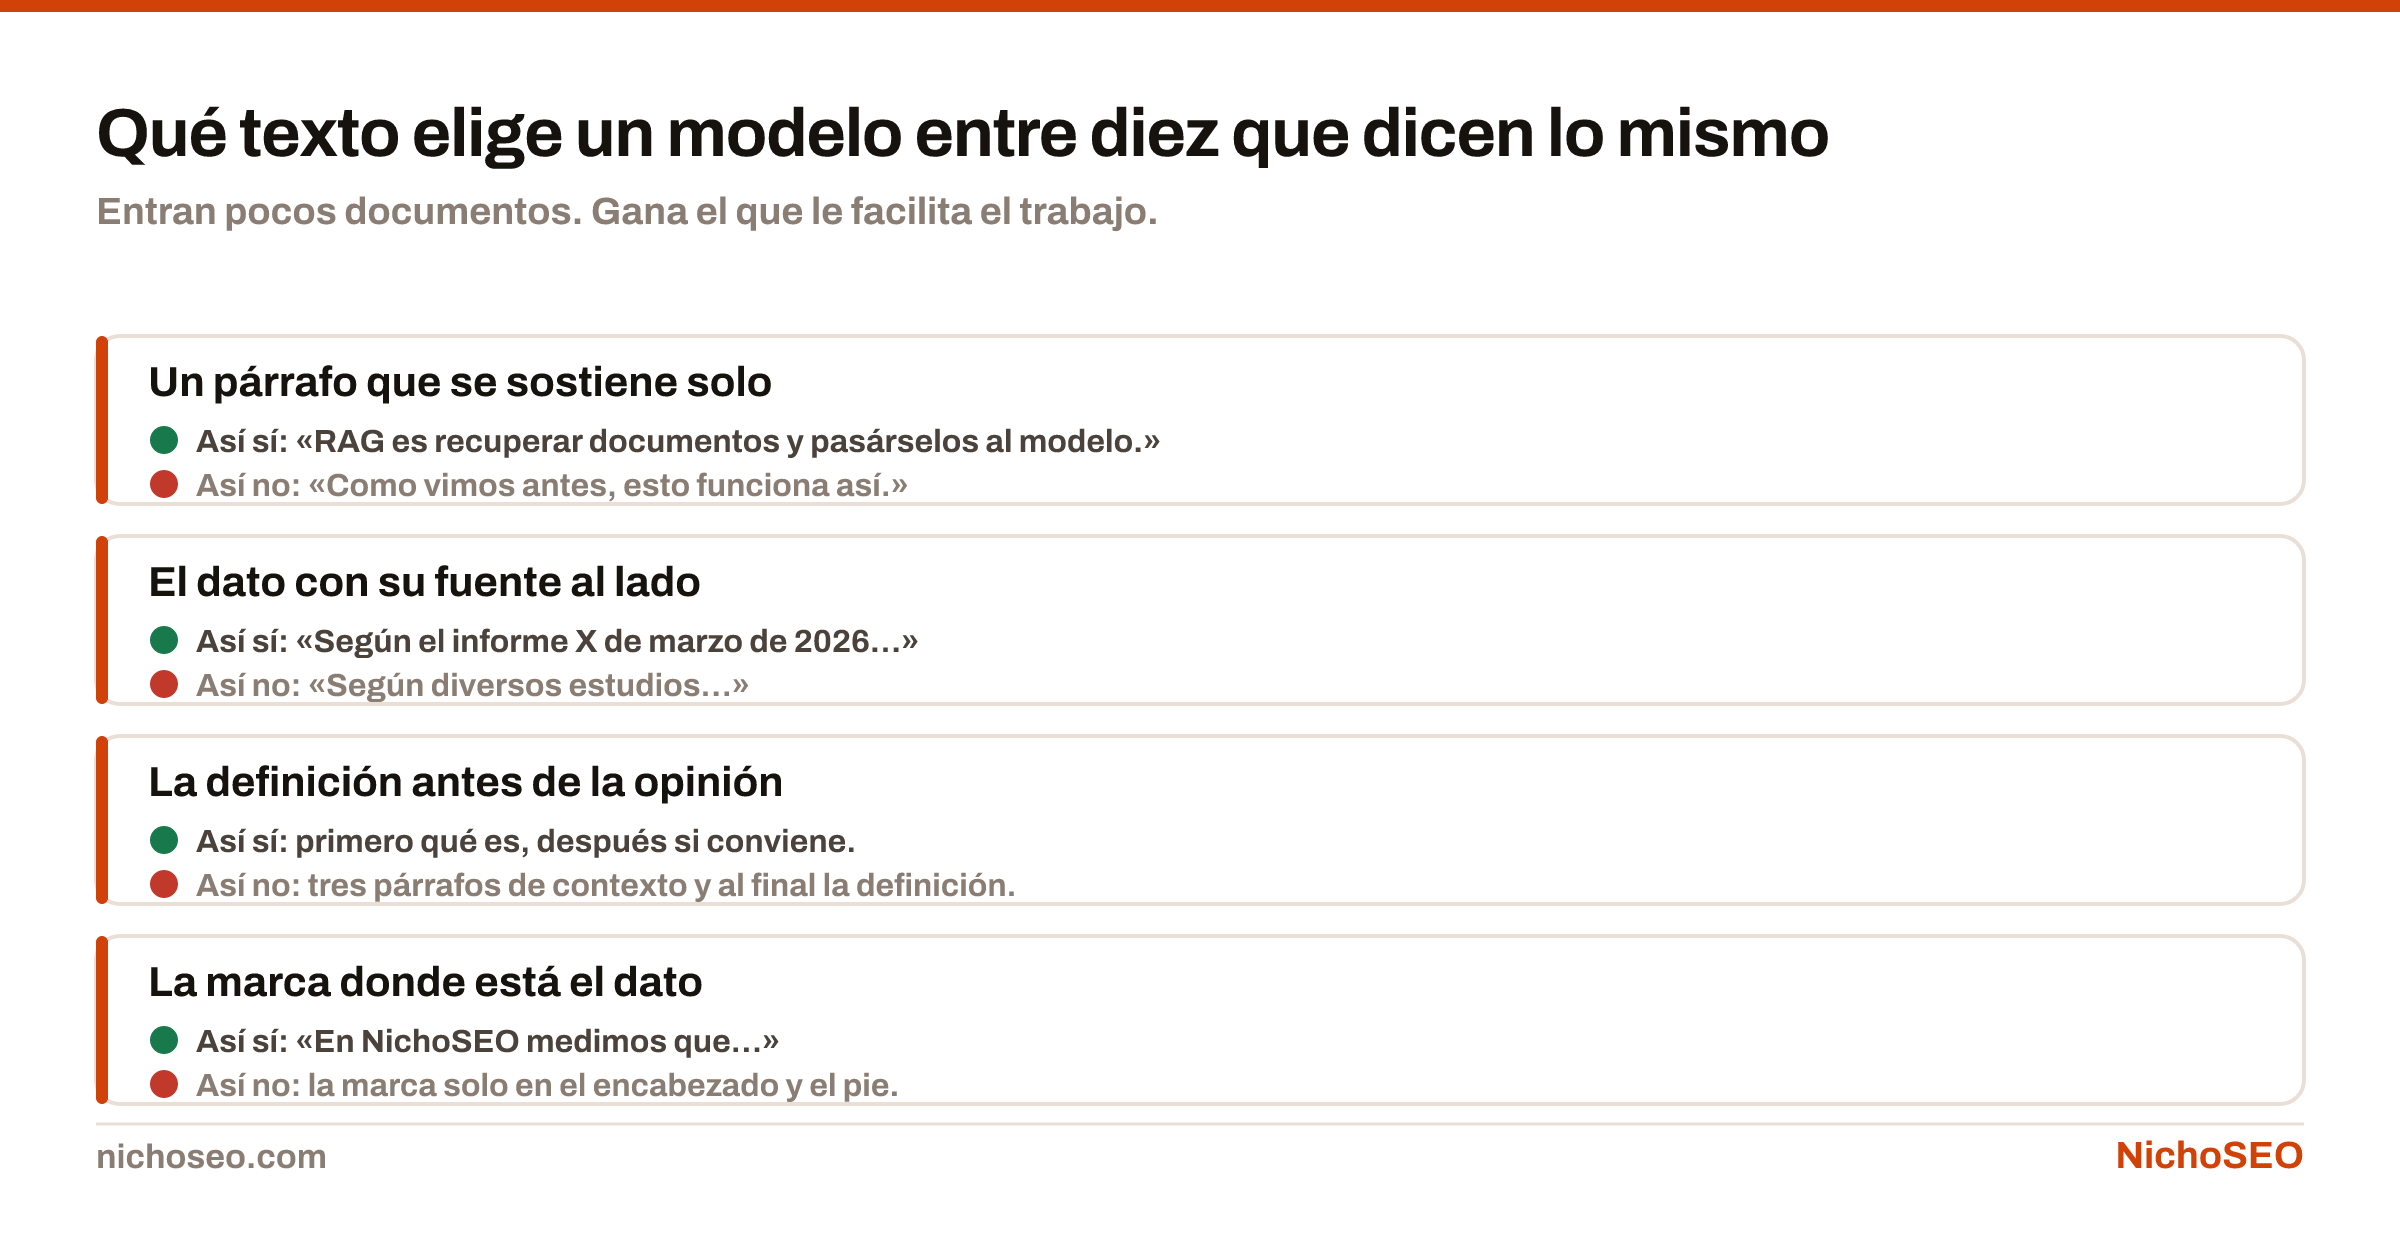
Lo que sí es específicamente GEO ocurre en la etapa dos. Entre diez documentos que dicen lo mismo, entran los que le facilitan el trabajo al modelo:
- Los que responden en un párrafo que se sostiene solo, sin depender del anterior.
- Los que traen el dato con su fuente al lado, en vez de «según diversos estudios».
- Los que definen el término antes de opinar sobre él.
- Los que se pueden recortar sin que el recorte pierda sentido.
El trabajo que describió el mecanismo por primera vez es Lewis et al., 2020.
Cada motor implementa RAG a su manera
RAG no es una sola cosa. Cada motor implementa su versión: cuántas consultas lanza, qué buscador usa, cuántos documentos mete en contexto, cómo desempata. Esas diferencias explican por qué la misma pregunta da respuestas distintas en ChatGPT y en Perplexity, y por qué una página puede ser citada por uno y ignorada por el otro.
Lo que se repite en todos es la forma general: recuperar, seleccionar, redactar. Optimizar para esa forma es más estable que perseguir el comportamiento puntual de un motor, que cambia sin aviso.
Y hay una consecuencia de todo esto que conviene dejar dicha, porque ordena las prioridades mejor que cualquier lista de tácticas. Si las tres etapas son secuenciales y la primera la decide un buscador, entonces el orden en que conviene trabajar es el inverso al que llama la atención. Lo llamativo es la etapa tres, la de la redacción con citas. Lo que decide es la etapa uno, la que se parece al SEO de toda la vida.
Quien empieza por el final está escribiendo párrafos impecables para un lector que nunca va a recibirlos.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Historial de revisiones
- Se aplicó el playbook: encabezados descriptivos, el diagrama pasa a ser una imagen descargable y la redacción va en segunda persona.
- Se reescribió la apertura y el cierre para explicar el problema que RAG resuelve antes de describir sus etapas, y se cambió el título por uno que diga de qué trata la página.
- Se agregó el diagrama del recorrido de una consulta por un sistema RAG.
- Publicada.