

Puntos clave
- Un detector de IA no identifica al autor: estima qué tan previsible es el texto.
- Por eso marca como IA a quien escribe claro y corto, y a quien no escribe en su idioma.
- Un texto generado y después editado deja de ser detectado casi siempre.
- El falso positivo es el error caro: acusar a una persona tiene consecuencias reales.
- Lo que hay que evaluar no es cómo se produjo un texto, sino si aporta algo verificable.
De esa diferencia salen todos los problemas que tiene la categoría.
Qué mide en realidad
Para entender por qué falla hay que entender qué mira, y es más simple de lo que parece.
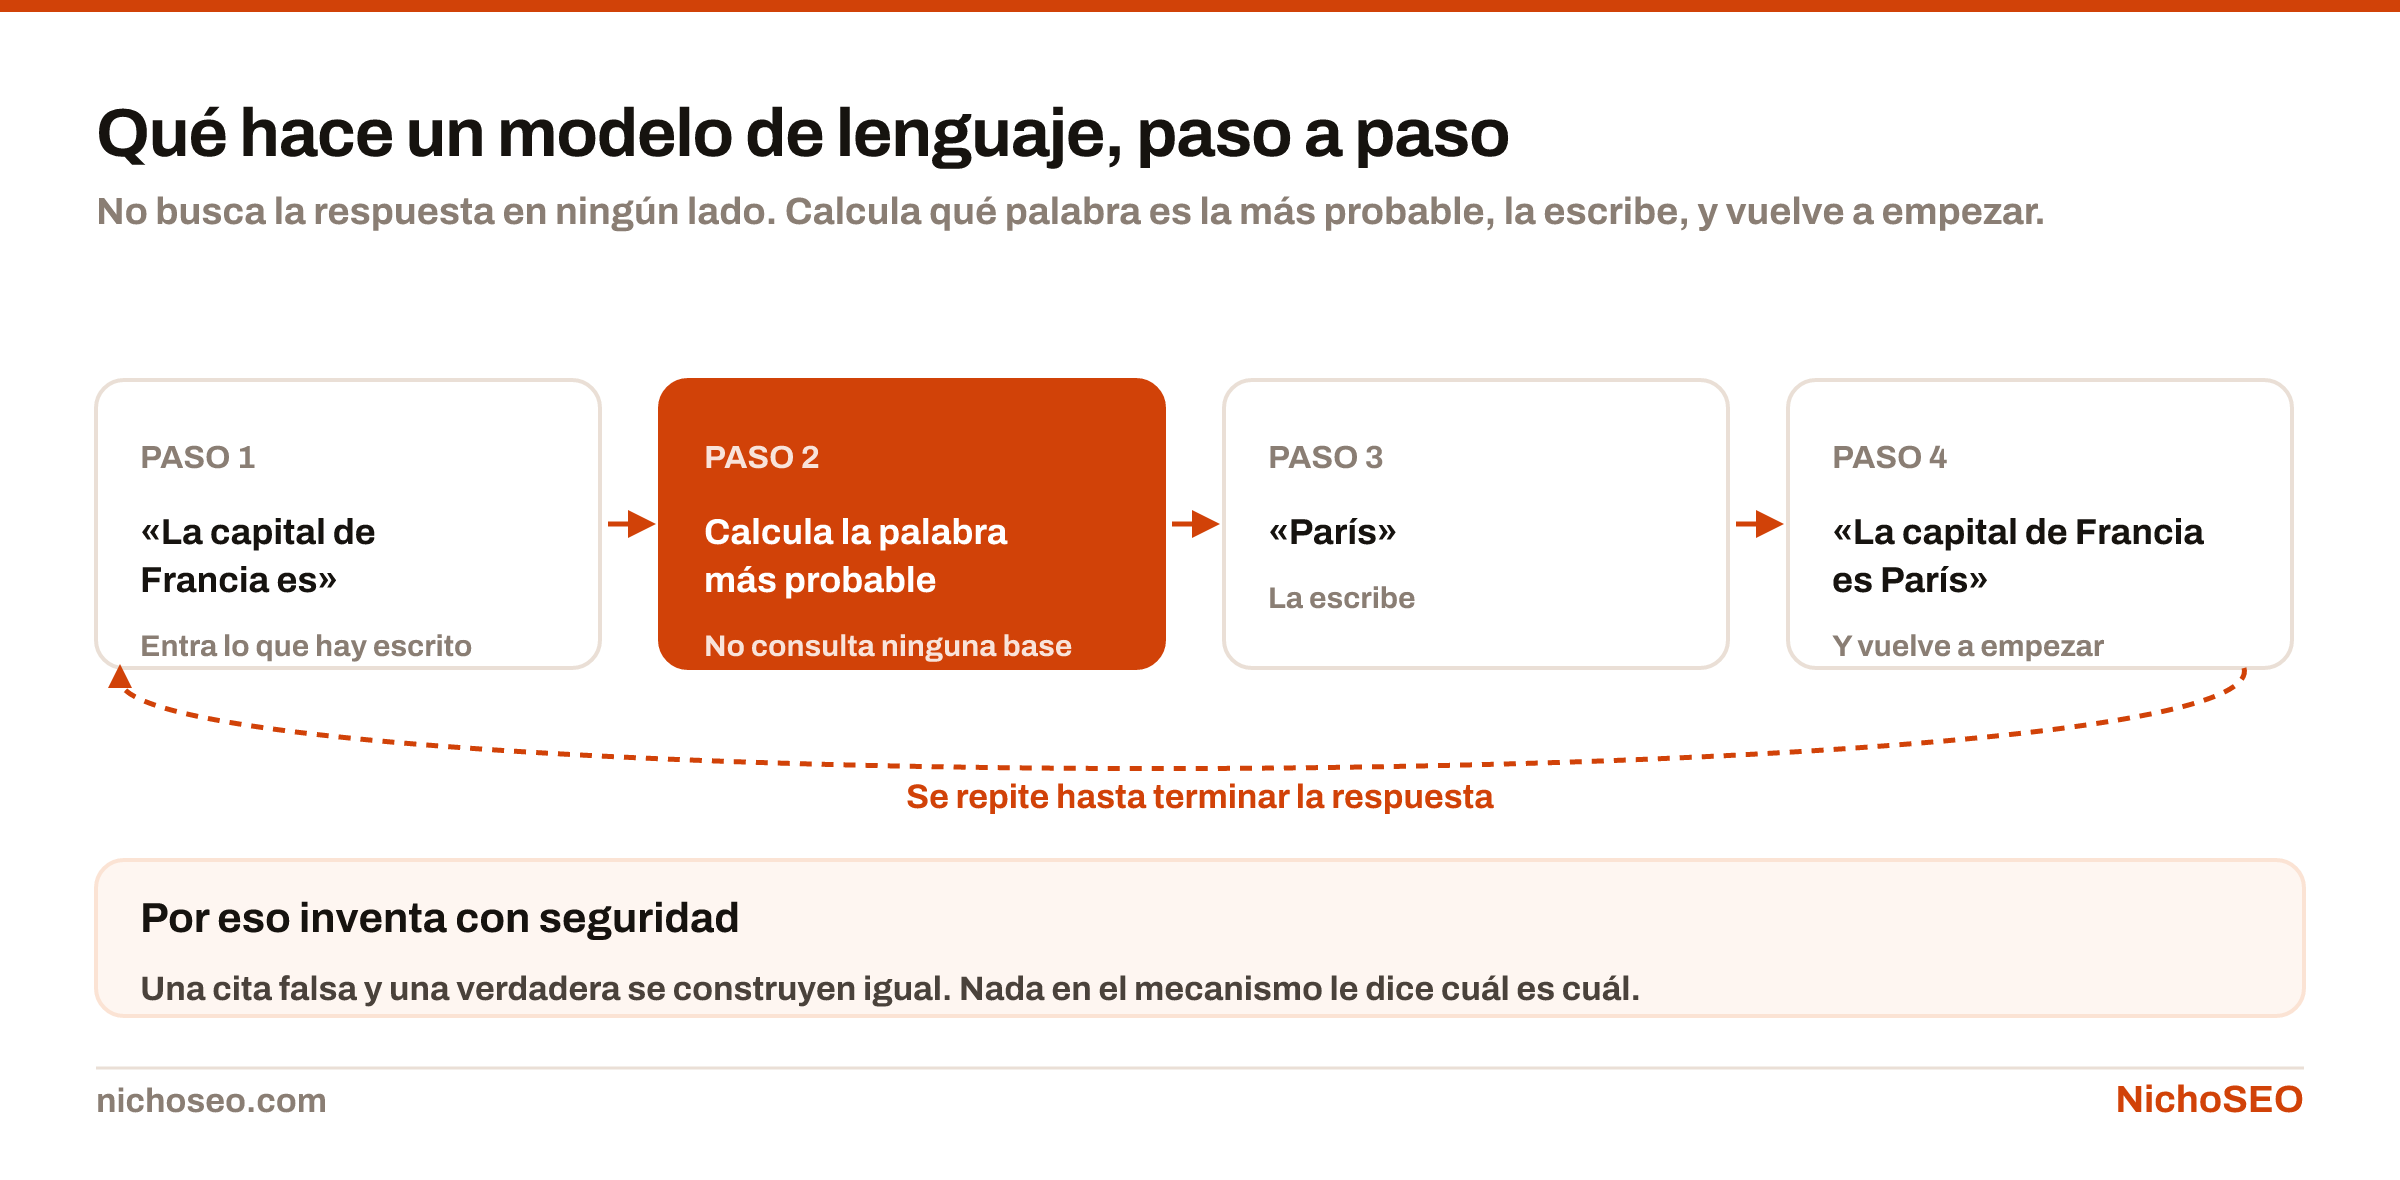
Un modelo de lenguaje elige cada palabra según qué tan probable es después de las anteriores. Tiende a elegir lo probable, y eso produce texto previsible.
Un detector invierte el cálculo: toma un texto y mide qué tan previsible es. Si cada palabra es la que un modelo habría elegido, sube el porcentaje.
El problema es que “previsible” no es sinónimo de “generado”. Hay escritura humana muy previsible y la hay muy poco previsible, y eso depende de cómo escribe la persona, no de si es una persona.
Los dos errores, y cuál es el caro
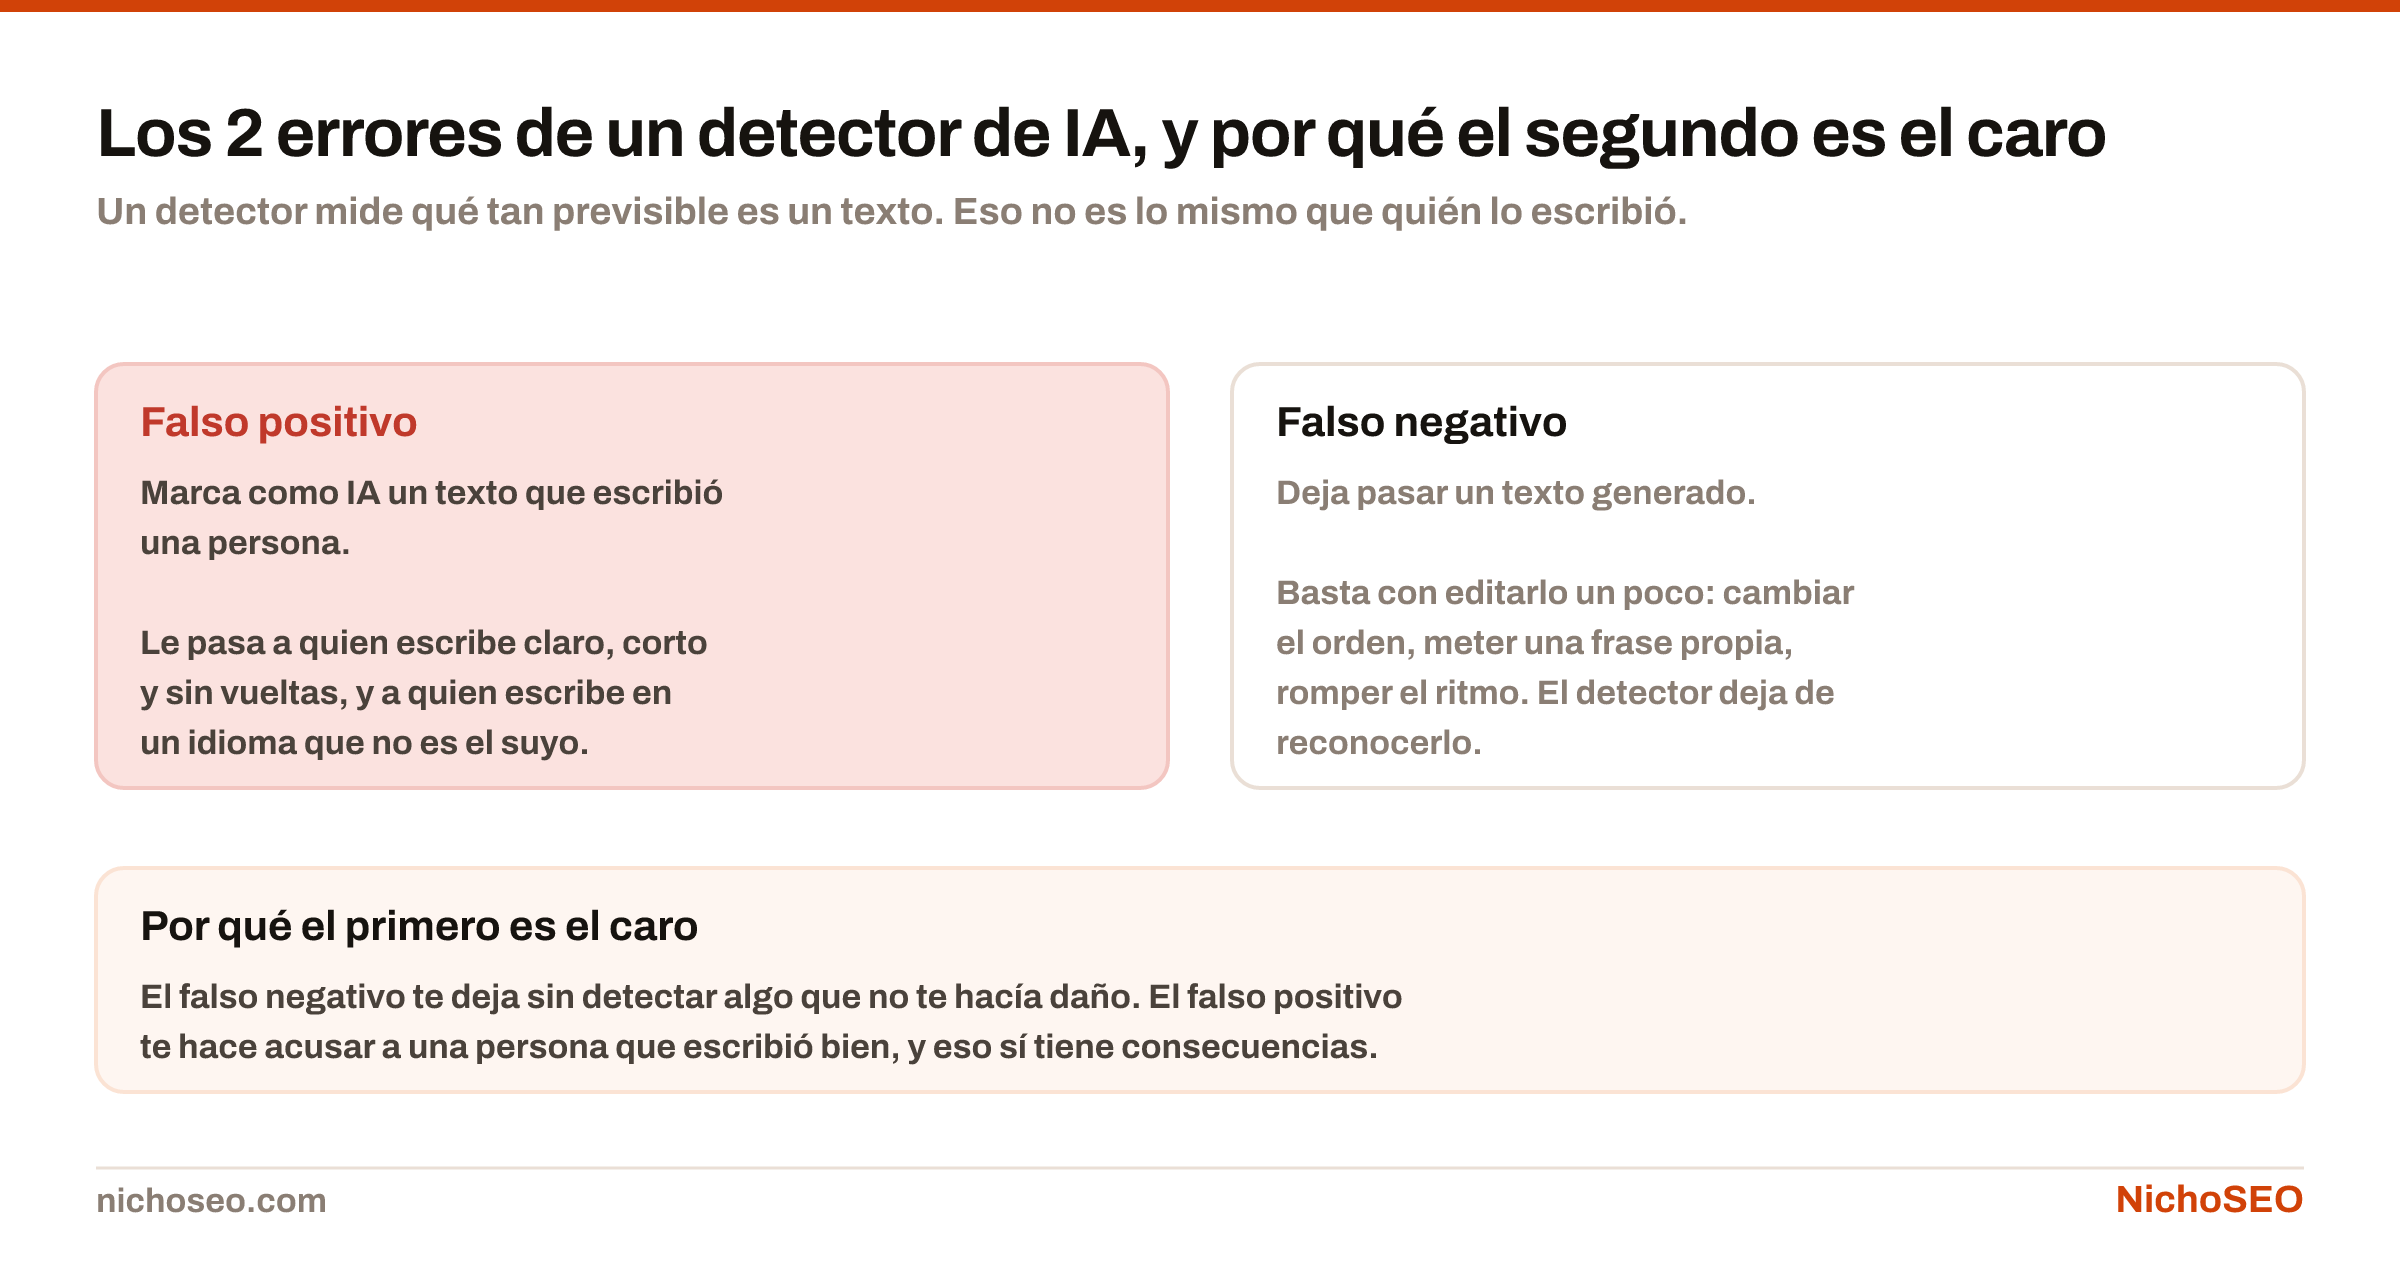
El falso negativo —dejar pasar texto generado— es el error que todo el mundo teme y el menos costoso. Basta con editar un poco el texto: cambiar el orden de dos oraciones, meter una frase propia, romper el ritmo. El detector deja de reconocerlo.
O sea: el detector es fácil de evadir a propósito. Como control, eso ya lo vuelve poco útil.
El falso positivo es el que hace daño. Marca como IA a una persona que escribió el texto, y quien recibe el resultado actúa como si tuviera una prueba.
Escritura que pasa el detector
- Frases largas con subordinadas
- Vocabulario variado, a veces raro
- Cambios bruscos de registro
- Errores y repeticiones
Escritura que lo hace saltar
- Frases cortas y directas
- El mismo término para la misma cosa
- Estructura consistente de principio a fin
- Un texto limpio, editado y revisado
Ahí está lo incómodo: las marcas de un texto bien editado son las mismas que las de un texto generado. Claridad, consistencia, frases cortas, un término por concepto. Es lo que pide cualquier manual de redacción.
Y hay un sesgo documentado adicional: los textos escritos por personas en un idioma que no es el suyo tienden a usar construcciones más simples y vocabulario más restringido. Eso los hace más previsibles y sube su puntaje de detección.
Por qué el porcentaje no significa lo que parece
“87 % de probabilidad de IA” se lee como una confianza. No es eso.
Es una salida de un clasificador entrenado con ejemplos, y el número depende del umbral que su autor eligió. Dos detectores distintos dan porcentajes distintos para el mismo texto, por el mismo motivo por el que dos herramientas de keywords dan volúmenes distintos.
Qué se puede concluir de un porcentaje alto
Un dato que conviene pedirle a cualquier detector antes de usarlo: cuál es su tasa de falsos positivos, medida sobre qué corpus. Casi ninguno lo publica, y los que lo hacen suelen medirlo sobre textos genéricos, no sobre escritura técnica editada.
Qué hacer en lugar de detectar
La pregunta útil no es “¿esto lo escribió una IA?”. Es “¿esto aporta algo que se pueda verificar?”.

Esa segunda pregunta se puede contestar leyendo, no midiendo:
- ¿Hay algún dato que no esté en otros diez artículos? Un número propio, un caso, un procedimiento que alguien siguió.
- ¿Las afirmaciones tienen de dónde salieron? Fecha, fuente, muestra.
- ¿Hay alguien que se haga responsable? Un nombre con una trayectoria comprobable, no una firma genérica.
- ¿Dice algo que no diría cualquiera? Una opinión, un límite, un “esto no funcionó”.
Un texto que pasa esas cuatro sirve, lo haya escrito quien lo haya escrito. Uno que no las pasa no sirve, aunque lo haya escrito una persona a mano.
El criterio completo de qué se puede demostrar está en E-E-A-T, y qué hace que un texto sea citable, en contenido citable.
El caso particular de Google
Conviene separarlo, porque es la pregunta que hay detrás de casi todas las consultas sobre detectores.
Google no dice que detecte contenido generado ni que lo penalice por serlo. Lo que su política sanciona es producir a escala con el fin principal de manipular el ranking, y eso aplica igual si el texto se generó, se hiló a mano o se tradujo en masa.
El detalle de qué dice la política y qué se observa en la práctica está en ¿Google penaliza el contenido hecho con IA?.
Dónde sí tienen algún uso
No son inútiles; son mal usados.
Como señal entre varias, nunca como veredicto. Si un texto da alto en el detector y además no tiene ningún dato propio y además no tiene autor, hay algo. El detector solo no dice nada.
Para revisar lo propio. Si pasás tu propio texto y da muy alto, puede ser una pista de que quedó genérico. No porque lo haya escrito una máquina, sino porque no dice nada que otro no pudiera decir. Esa es una señal de edición útil.
Nunca para acusar a una persona. Ni a un redactor, ni a un proveedor, ni a un estudiante. El falso positivo existe, no es raro, y quien lo sufre no tiene forma de demostrar lo contrario.
Lo que sí se puede exigir
Si el problema real es la calidad de lo que entrega un proveedor, el contrato es mejor herramienta que el detector.
Pedir el dato propio, la fuente de cada cifra, el nombre de quien firma y una entrevista a alguien que sepa del tema resuelve el problema de fondo. Un texto con esas cuatro cosas es difícil de producir sin trabajo, se haya usado o no un modelo en el camino.
Un texto con esas cuatro cosas es difícil de producir sin trabajo, se haya usado o no un modelo en el camino.
La política de Google sobre contenido generado, que es el documento que más se cita mal en esta discusión, está publicada en su guía sobre contenido creado con IA.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Siguiente en el manual