Medir la visibilidad en IA

El capítulo completo, para imprimir

Las 5 entradas de Medir la visibilidad en IA en una sola página: 18 minutos de lectura. El botón abre el diálogo de impresión de tu navegador, donde podés elegir «Guardar como PDF».

Volver al capítulo

NichoSEO · Manual de SEO y GEO

Medir la visibilidad en IA

No hay panel oficial y el tráfico mide la parte más chica de lo que pasa. Este capítulo arma la medición desde cero: qué preguntar, cada cuánto, qué contar y cómo saber contra quién estás compitiendo de verdad.

5 entradas · 18 minutos de lectura · última revisión del capítulo: 26 de sept de 2026

nichoseo.com/manual/medir-la-visibilidad-en-ia/

1 de 5

Cómo medir la visibilidad en IA: métricas y prompts

No hay panel que lo informe: se pregunta, se anota y se repite. El método completo, qué medir de verdad y cada cuánto, sin comprar nada.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

No hay atajo. Cualquier herramienta que venda esta métrica hace exactamente esto por detrás, con más volumen.
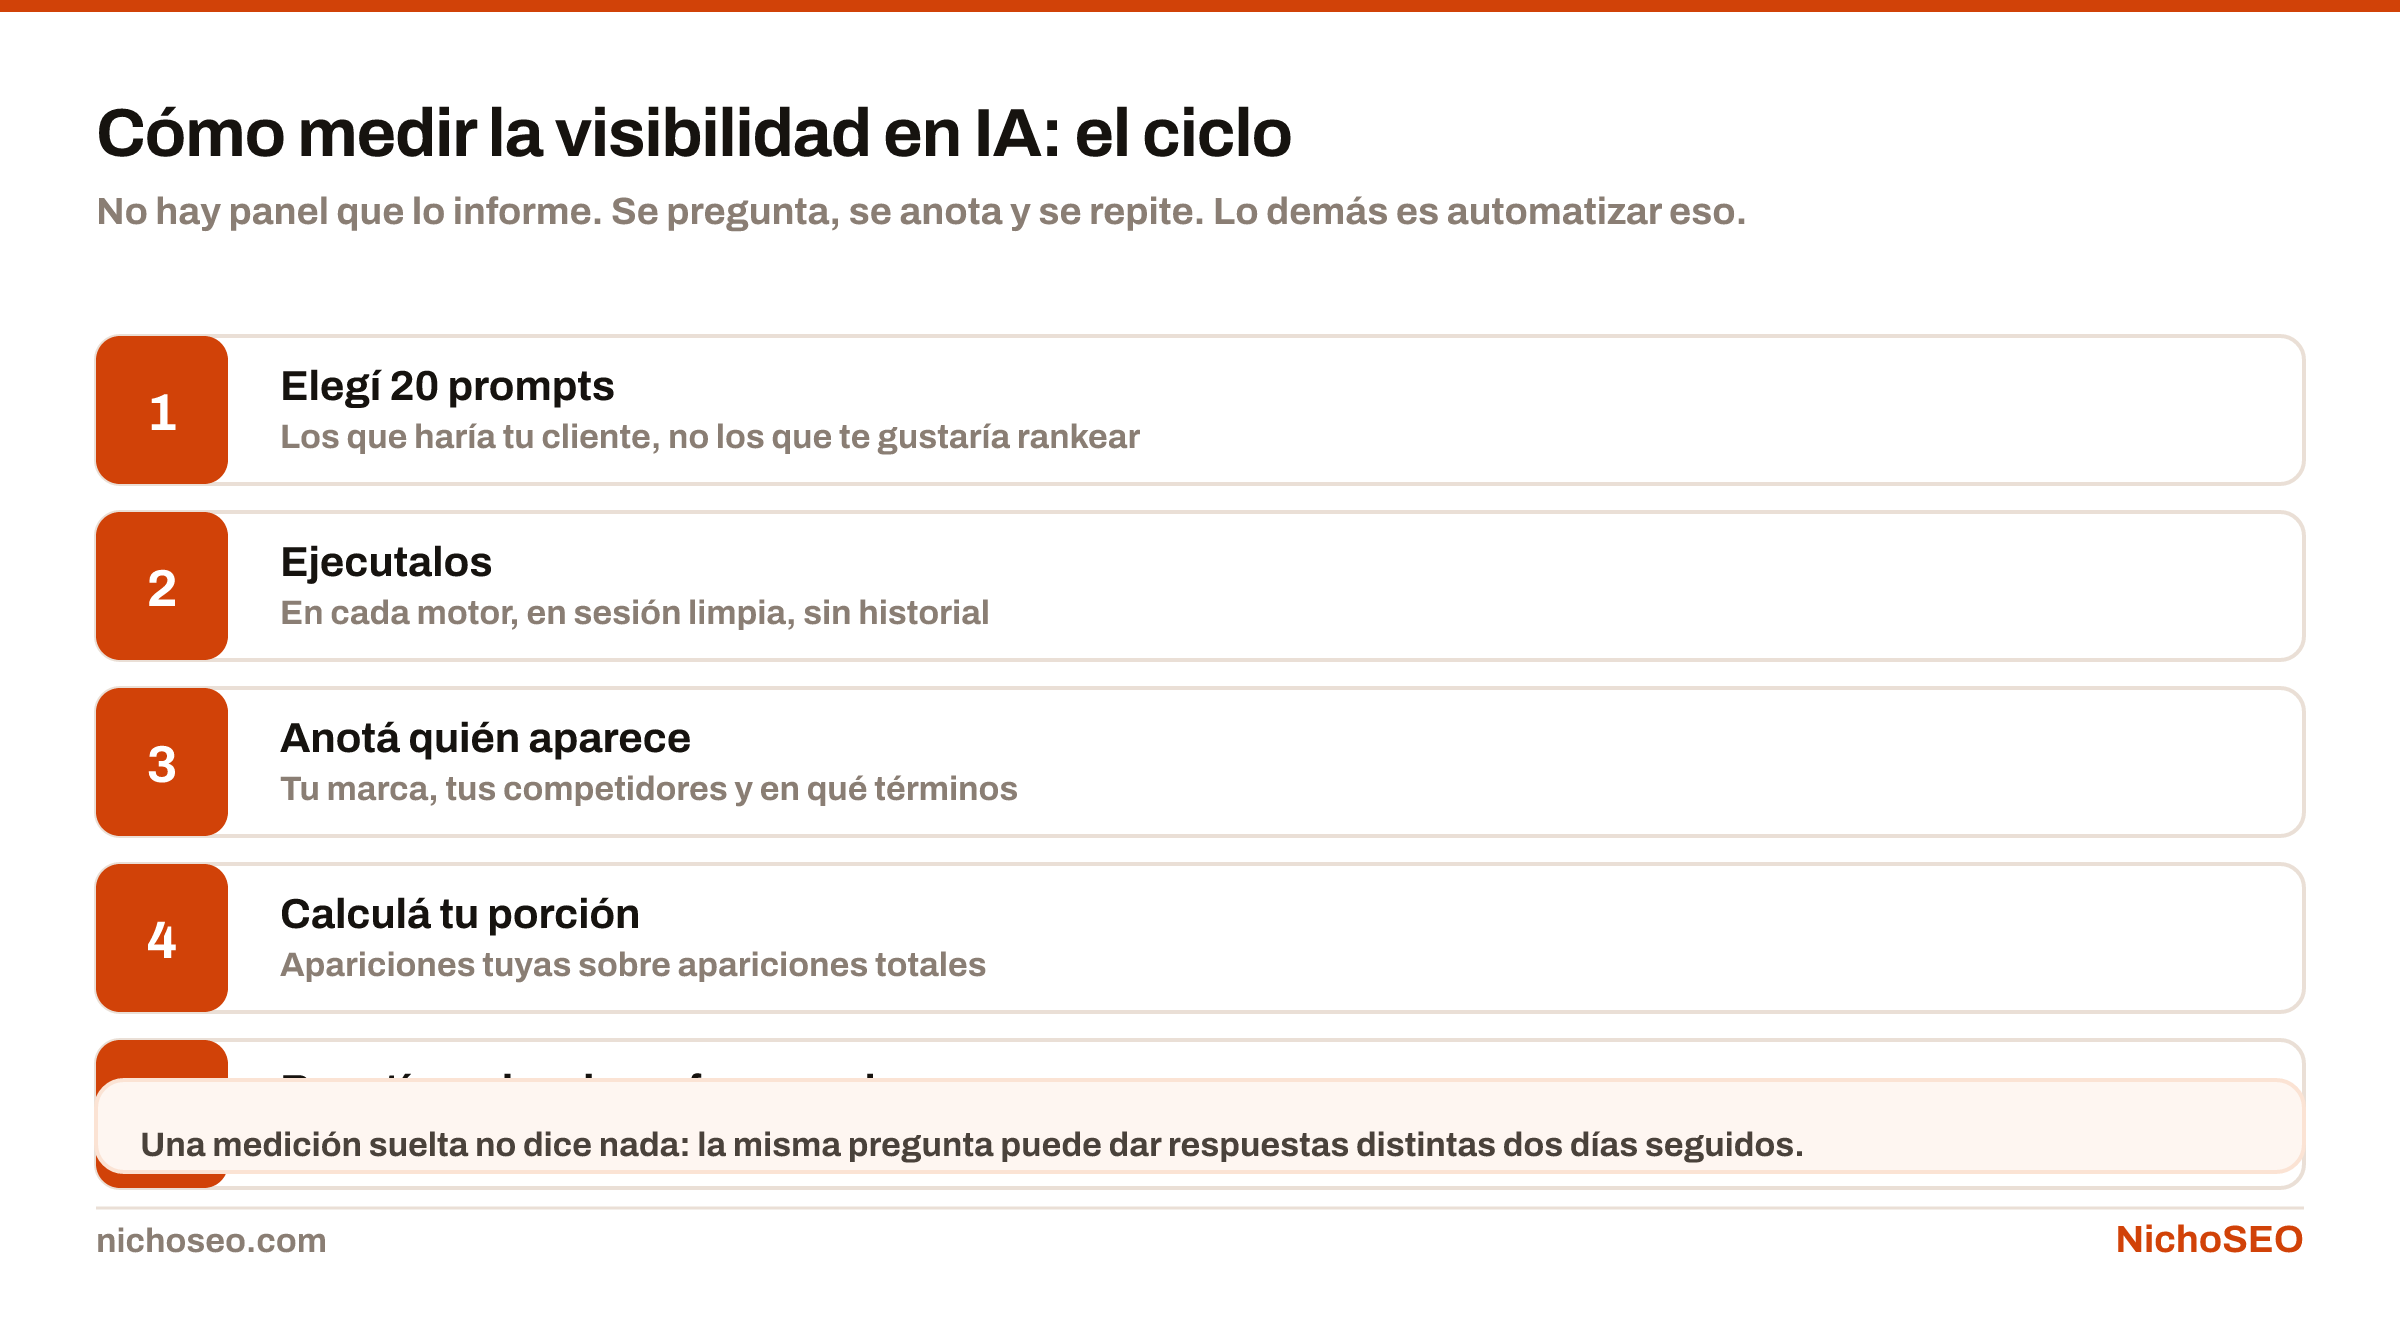
El ciclo para medir visibilidad en motores generativos: elegir prompts, ejecutarlos, anotar quién aparece, calcular share of voice y repetir con la misma frecuencia.
No hay panel que lo informe. Se pregunta, se anota y se repite. Lo demás es automatizar eso.Descargar imagen

Qué medir: las 4 métricas

Lo primero es sacarse de encima la métrica equivocada. El tráfico no mide visibilidad en IA: la mayoría de las apariciones no traen ni una visita.

Las cuatro métricas del GEO: menciones, citas, share of voice y sentimiento, con qué mide cada una.
Ninguna aparece en Search Console. Se miden preguntándole al motor y anotando qué contestó.Descargar imagen

De las cuatro, la que más cuesta aceptar es la mención sin enlace. No mueve ningún tablero y es, en la práctica, una recomendación.

Paso 1: elegir los 20 prompts

Es la decisión que más determina si la medición sirve para algo.

Elegí las preguntas que haría tu cliente, no las que te gustaría rankear. La diferencia es enorme: nadie escribe «software de gestión de inventario multicanal», la gente escribe «cómo controlo el stock si vendo en dos lados».
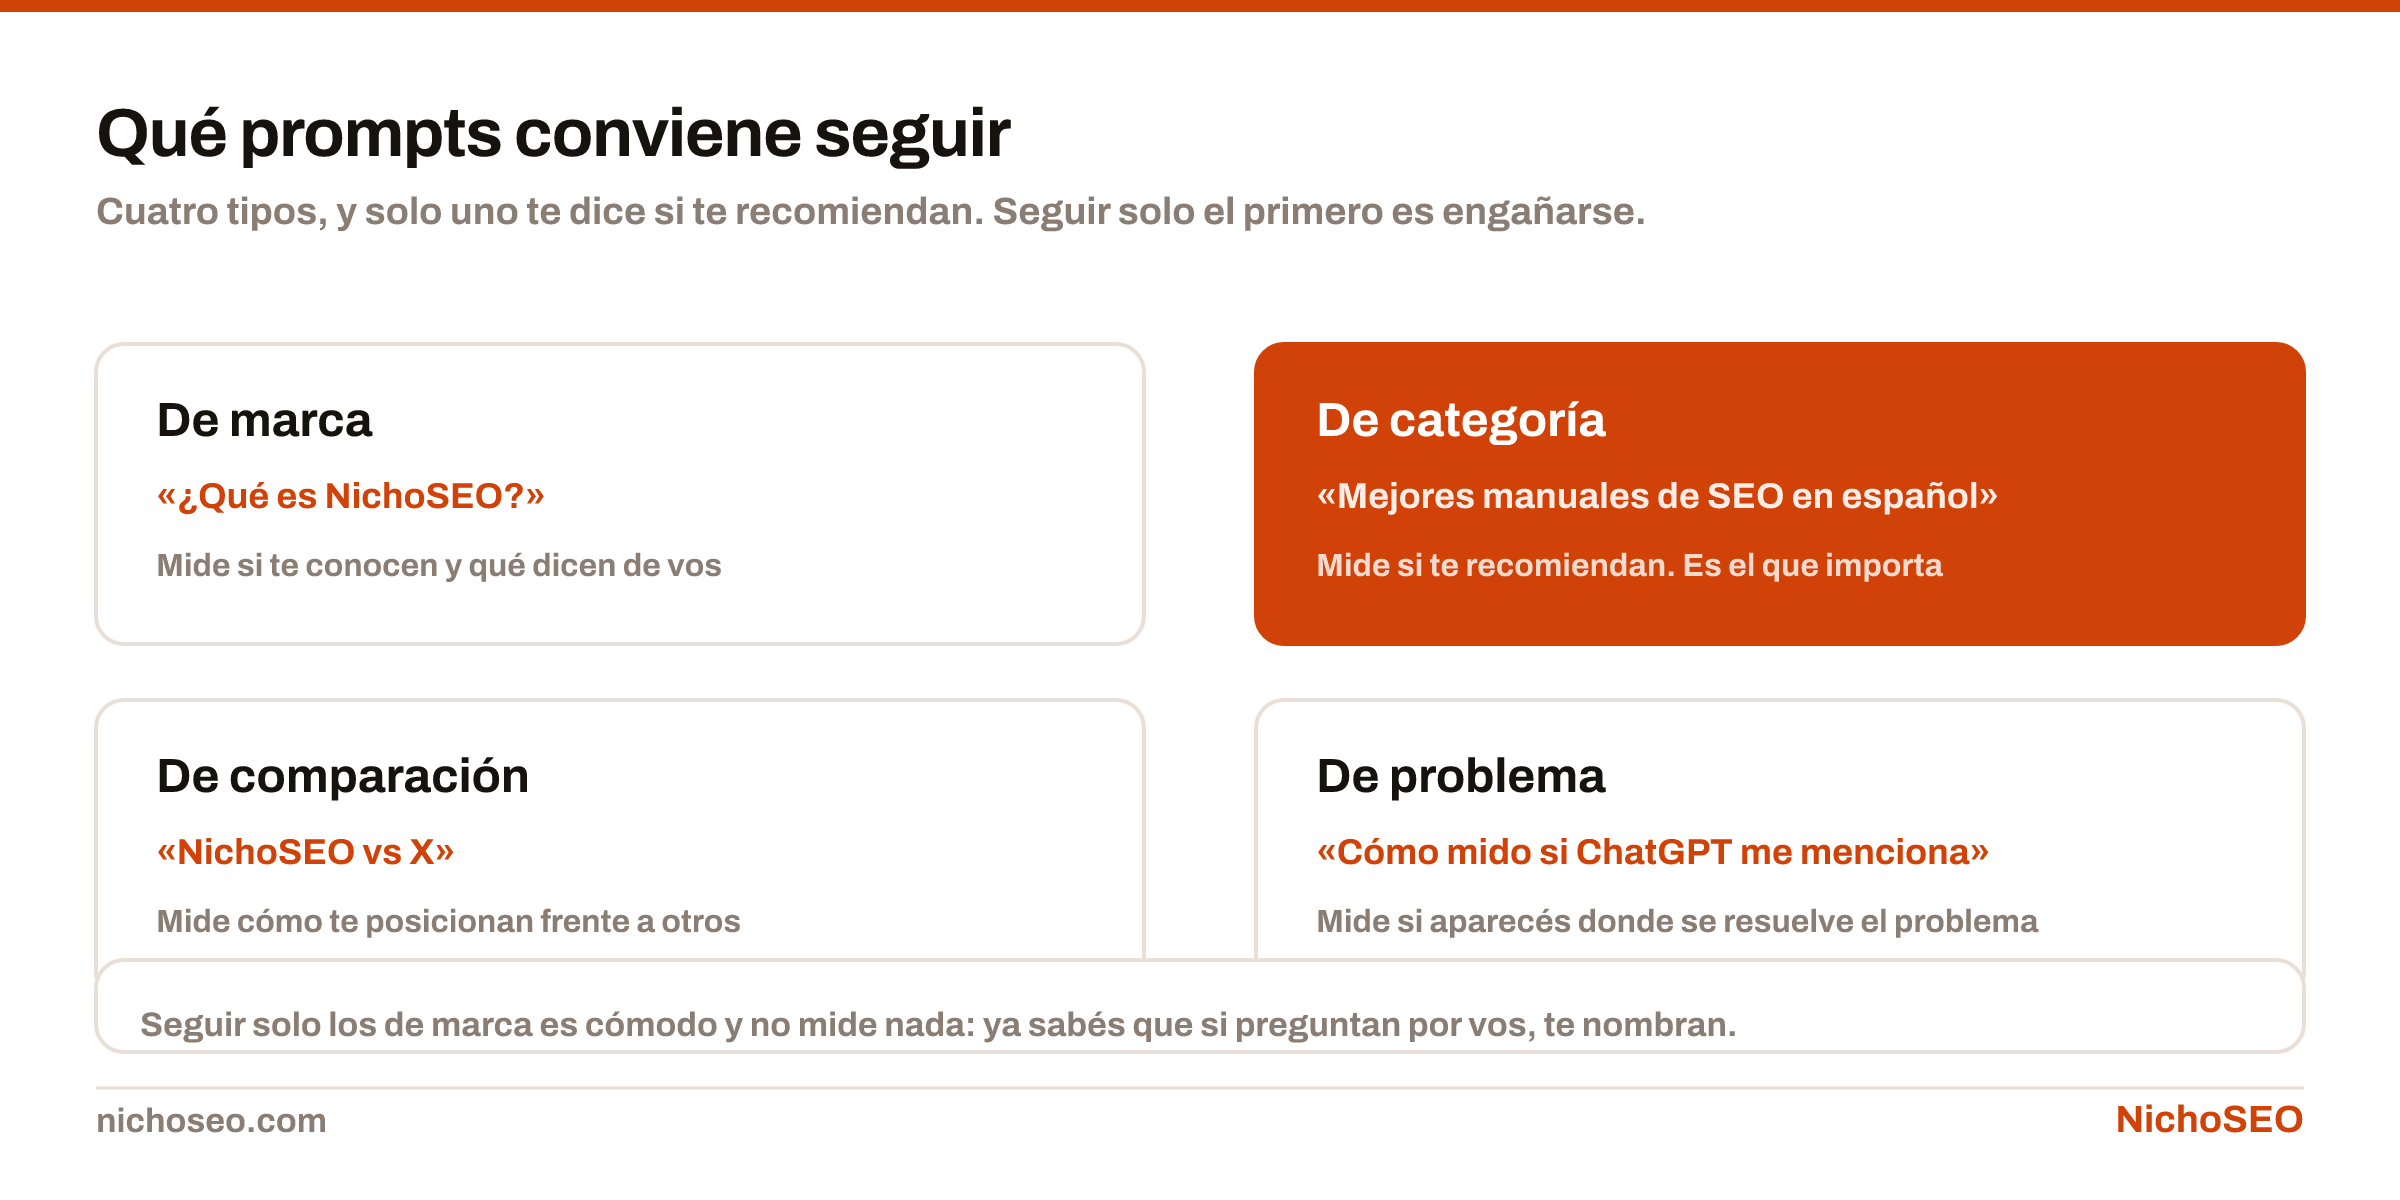
Los cuatro tipos de prompt que conviene seguir: de marca, de categoría, de comparación y de problema, con qué mide cada uno.
Cuatro tipos, y solo uno te dice si te recomiendan. Seguir solo el primero es engañarse.Descargar imagen

Veinte alcanza. Con menos, el ruido tapa la señal; con muchos más, el trabajo semanal se vuelve inviable y lo abandonás al mes.

Paso 2: ejecutar en sesión limpia

Los motores personalizan. Si preguntás desde tu cuenta, con historial, en una conversación donde ya nombraste tu marca, vas a aparecer más de lo que aparecés.

Usá una sesión sin iniciar, sin historial y sin conversación previa. Una ventana privada es suficiente.

Y hacelo en cada motor que te importe: ChatGPT, Gemini, Perplexity y el resumen de Google no dan la misma respuesta ni citan lo mismo.

Paso 3: anotar qué contestó

Una fila por prompt y por motor, con cuatro columnas:

ColumnaQué anotás
¿Aparecés?Sí o no
¿Con enlace?Sí o no
¿Quién más aparece?Los competidores nombrados, en orden
¿En qué términos?Recomendado, alternativa, mencionado al pasar

Una planilla alcanza y sobra para empezar. El día que el trabajo manual moleste, esa planilla es la especificación de lo que tenés que automatizar.

Paso 4: calcular el share of voice

Es la métrica que convierte veinte respuestas sueltas en un número comparable: tus apariciones sobre el total de apariciones de marcas en ese conjunto de prompts.

Si en 20 prompts se nombran 60 marcas en total y vos estás en 9, tu porción es 15 %. El número solo no dice nada; la serie de ese número a lo largo de tres meses, sí. Está desarrollado en share of voice en IA.

Paso 5: repetir con la misma frecuencia

Acá está el error más común: medir una vez, sacar conclusiones y no volver a medir.

Una mención puede desaparecer entre dos ejecuciones del mismo prompt sin que nadie haya tocado nada. Eso vuelve inútil cualquier lectura de un dato suelto, y vuelve poco confiables los casos de éxito que circulan: una aparición ganada después de un cambio puede ser el cambio o puede ser el ruido.

Semanal o quincenal está bien. Lo que importa es que sea siempre igual.

Sostener esa frecuencia a mano es lo primero que se cae. Cuando se cae, lo que se compra es la constancia y no el dato: una de las herramientas que hace esto es CreceRank, que es un producto de quien escribe este manual y va declarado como tal donde aparece.

Qué hacer con lo que medís

Si no aparecés en ningún prompt, mirá primero lo aburrido: ¿rankeás para esas consultas? Los motores recuperan de un buscador, así que sin presencia ahí no hay nada que optimizar después.

Si aparecés con enlace pero sin nombre, es un problema de dónde pusiste tu marca dentro del texto.

Si no aparecés y tus competidores sí, mirá qué páginas cita el motor y qué tienen ellas que no tenga la tuya. Casi siempre es una de cuatro cosas, y están en contenido citable.

Google publicó sus propias recomendaciones para aparecer en la búsqueda con IA, que sirven como contraste de cualquier método que te vendan.
2 de 5

Prompt tracking: cómo elegir los prompts que vas a medir

La lista de preguntas que seguís decide si tu medición sirve o te engaña. Los cuatro tipos que hay que cubrir y los errores que inflan el resultado.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Suena simple y casi todo el mundo lo hace mal en el primer paso: eligiendo las preguntas equivocadas.

Los 4 tipos de prompt, y cuál importa

Los cuatro tipos de prompt que conviene seguir: de marca, de categoría, de comparación y de problema, con qué mide cada uno.
Cuatro tipos, y solo uno te dice si te recomiendan. Seguir solo el primero es engañarse.Descargar imagen

El de marca —«¿qué es NichoSEO?»— mide si te conocen y qué dicen de vos. Está bien para reputación y es casi inútil para crecimiento: si alguien ya escribió tu nombre, lo difícil ya pasó.

El de categoría —«mejores manuales de SEO en español»— mide si te recomiendan cuando nadie te nombró. Es el que importa y es el que casi nunca se sigue, porque es el que da peor resultado al principio.

El de comparación —«NichoSEO vs X»— mide cómo te posicionan frente a otros. Útil cuando ya existís en la conversación.

El de problema —«cómo mido si ChatGPT me menciona»— mide si aparecés en el momento en que alguien tiene la necesidad, antes de saber que existe tu categoría.

Cómo armar la lista de 20

Un reparto que funciona: 4 de marca, 8 de categoría, 4 de comparación y 4 de problema.

Para encontrarlos, tres fuentes gratis y mejores que cualquier exportación:

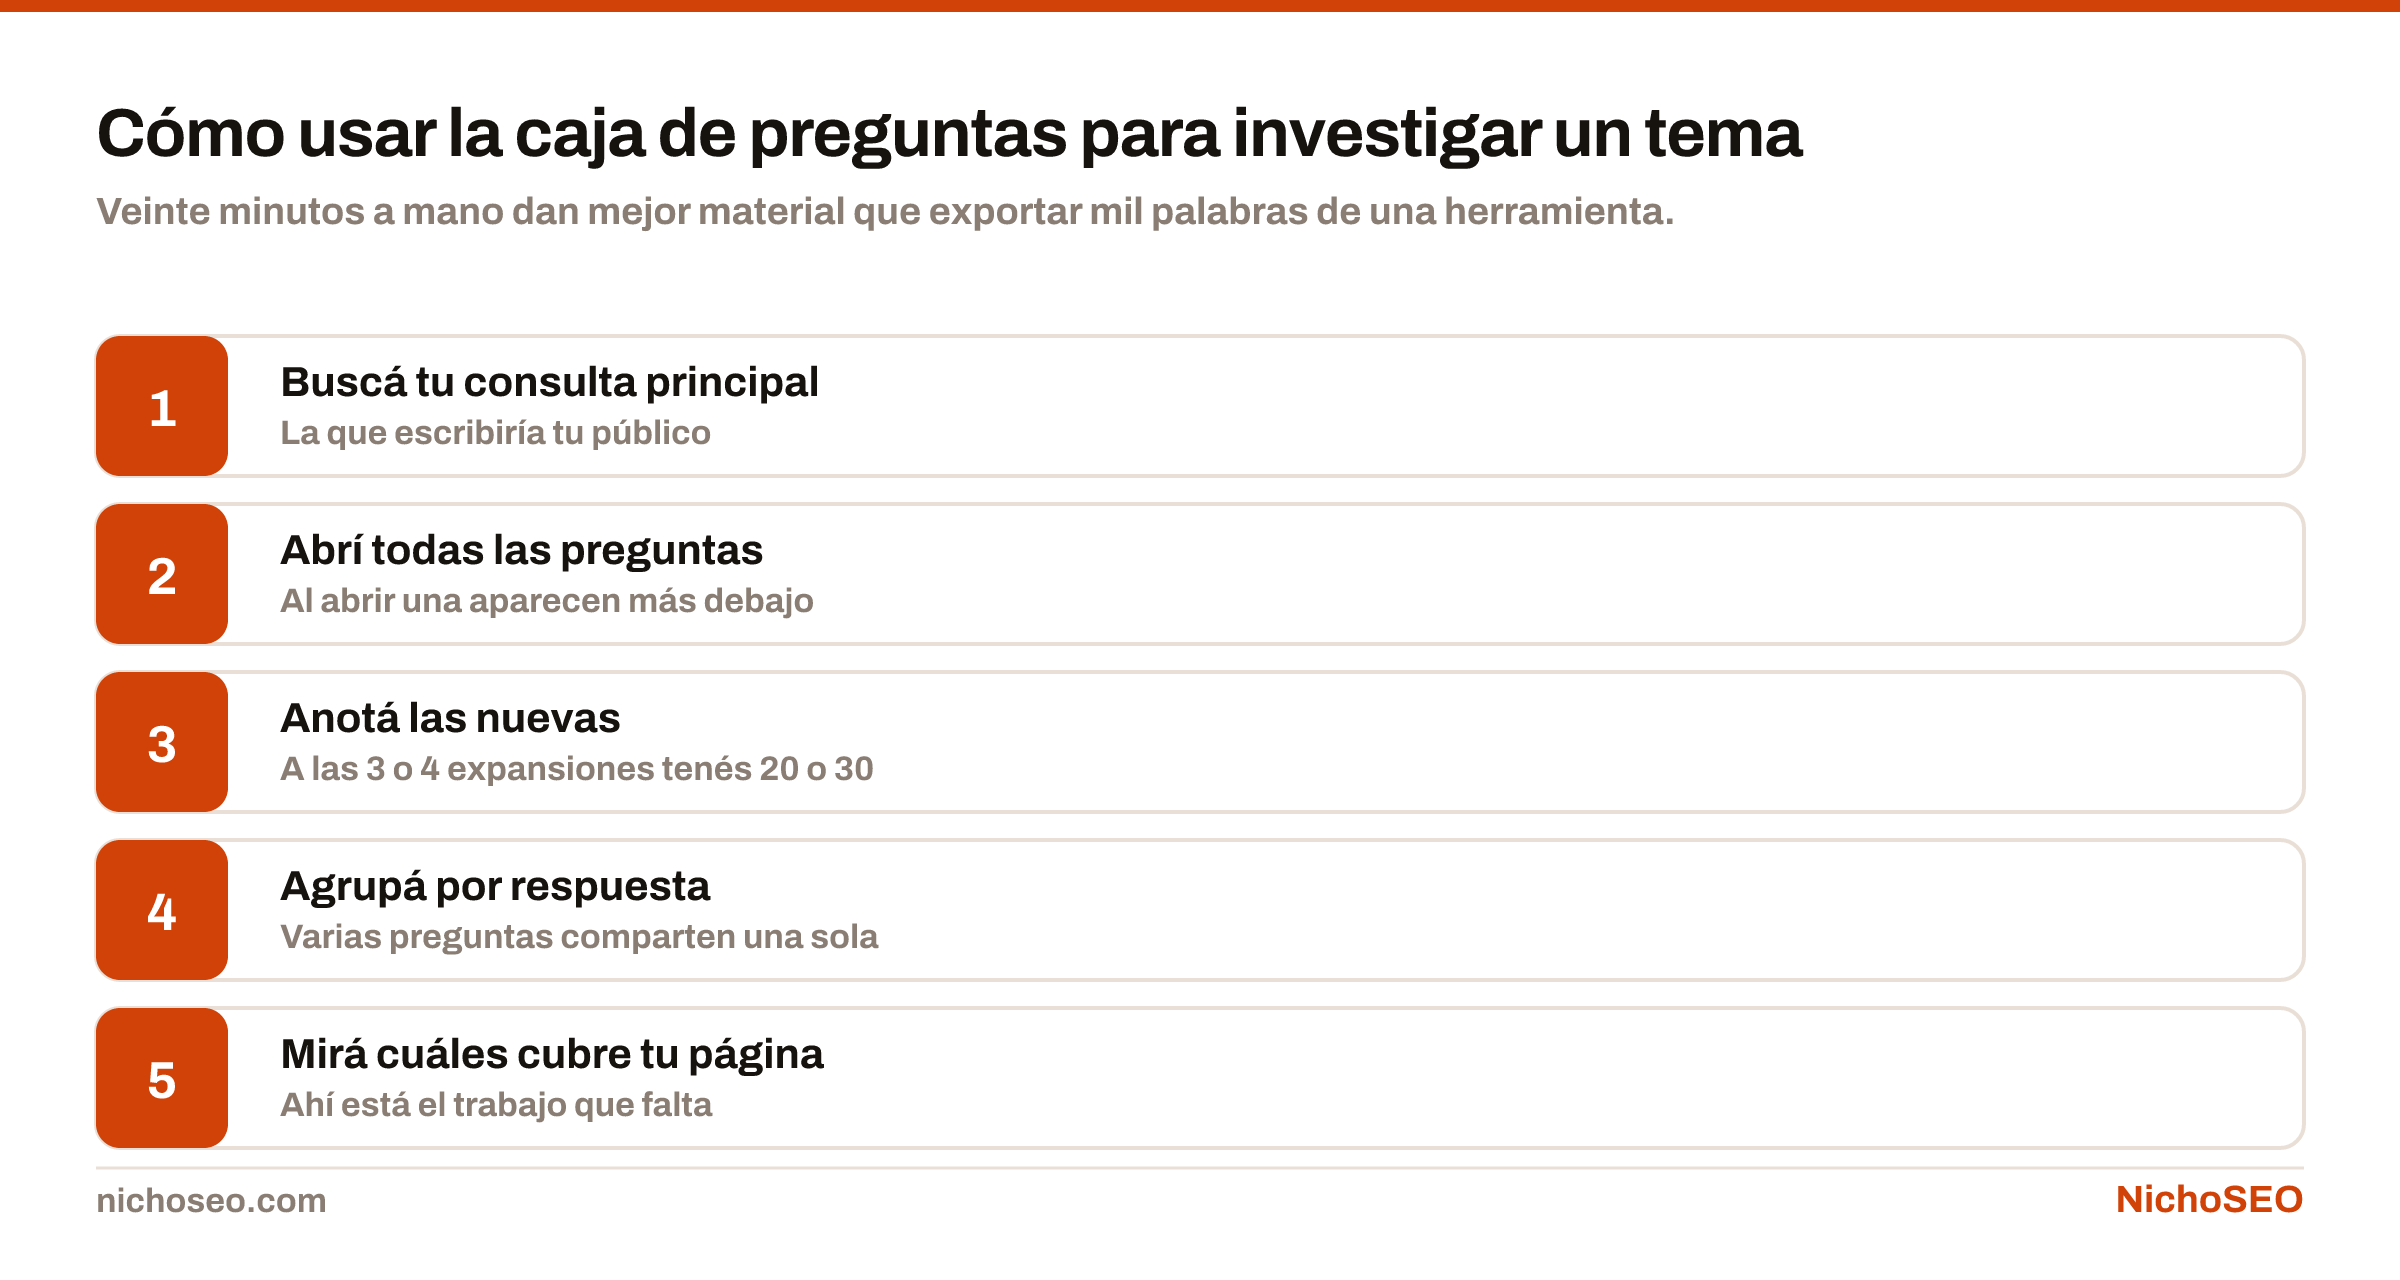
La caja de preguntas de Google. Buscá tu tema, abrí todas las preguntas y anotá las que van apareciendo. Es una lista de lo que la gente efectivamente se pregunta, generada a partir de comportamiento real.

Los cinco pasos para usar la caja de preguntas relacionadas como investigación: buscar, expandir todas las preguntas, anotar las nuevas, agrupar por respuesta y ver cuáles cubre tu página.
Veinte minutos a mano dan mejor material que exportar mil palabras de una herramienta.Descargar imagen

Lo que te preguntan tus clientes. Literalmente: las preguntas que llegan por mail, en una llamada de venta o en soporte. Escritas como las escribieron ellos.

Los foros de tu categoría. Donde la gente pregunta sin que una marca esté mirando.

Los 4 errores que inflan el resultado

1. Solo prompts de marca. Tu porción va a dar altísima y no vas a haber medido nada. Es el equivalente a medir tu SEO solo por búsquedas de marca.

2. Preguntar desde tu sesión. Con historial y personalización, el motor ya sabe de qué hablás. Usá ventana privada, sin iniciar sesión.

3. Cambiar la lista cada mes. La comparación con las mediciones anteriores se rompe. La lista se congela; si hay que agregar, se agrega y se mide aparte hasta tener serie propia.

4. Escribir los prompts como los escribiría un SEO. «Herramientas GEO 2026» no es una pregunta que alguien le haga a un chat. «¿Con qué puedo ver si ChatGPT nombra mi marca?» sí.

Cada cuánto medir

El ciclo para medir visibilidad en motores generativos: elegir prompts, ejecutarlos, anotar quién aparece, calcular share of voice y repetir con la misma frecuencia.
No hay panel que lo informe. Se pregunta, se anota y se repite. Lo demás es automatizar eso.Descargar imagen

Semanal si tenés alguien que lo haga; quincenal si lo hacés vos entre otras cosas. Lo que importa es que sea siempre la misma cadencia, porque lo que se lee es la tendencia y no el dato.

Y una advertencia que ahorra decepciones: las primeras tres o cuatro mediciones no dicen nada. Son la línea de base. La conversación interesante empieza al segundo mes.

Qué hacer cuando la tendencia no se mueve

Antes de tocar los prompts, comprobá lo aburrido. Los motores recuperan de un buscador, así que si no aparecés en los resultados de esas consultas, la lista de prompts no es el problema.

Google explica qué mira para las respuestas generadas en su documentación sobre funciones de IA, y es un buen contraste contra cualquier método que prometa resultados en dos semanas.

3 de 5

Share of voice en IA: qué es y cómo se calcula

La métrica que convierte veinte respuestas sueltas en un número comparable. Cómo se calcula, qué trampas tiene y por qué el número solo no dice nada.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Es la métrica que convierte veinte respuestas sueltas en un número que se puede comparar con el del mes pasado.

Cómo se calcula

La fórmula es deliberadamente simple:

share of voice = apariciones tuyas ÷ apariciones de todas las marcas

Un ejemplo concreto. Corrés 20 prompts. En las 20 respuestas se nombran marcas 60 veces en total. Vos aparecés 9 de esas veces.

9 ÷ 60 = 15 %

Ese es tu share of voice en esa medición, en ese motor.

Las cuatro métricas del GEO: menciones, citas, share of voice y sentimiento, con qué mide cada una.
Ninguna aparece en Search Console. Se miden preguntándole al motor y anotando qué contestó.Descargar imagen

Las 3 decisiones que cambian el número

El cálculo es trivial; lo que decide si sirve son tres cosas que hay que fijar antes y no tocar.

1. Qué prompts. Si la lista es mayoritariamente de marca, tu porción va a dar altísima y no vas a haber medido nada. El reparto sano está en prompt tracking.

Los cuatro tipos de prompt que conviene seguir: de marca, de categoría, de comparación y de problema, con qué mide cada uno.
Cuatro tipos, y solo uno te dice si te recomiendan. Seguir solo el primero es engañarse.Descargar imagen

2. Qué cuenta como aparición. Lo razonable es contar toda mención de marca, con enlace o sin él. Si contás solo las que traen enlace, estás midiendo citas y no menciones, que es otra cosa.

3. Qué motores. ChatGPT, Gemini, Perplexity y el resumen de Google no nombran lo mismo. Mezclarlos en un solo número esconde exactamente el dato que te sirve: en cuál estás fuerte y en cuál no existís.

Por qué el número solo no dice nada

Un 15 % no es bueno ni malo. Depende de cuántos competidores haya, de qué tan concentrada esté la categoría y de qué prompts elegiste.

Lo que informa es la serie. Un 15 % que viene de 9 % hace tres meses es una cosa; el mismo 15 % que viene de 22 % es otra muy distinta.

Y hay una razón de fondo para desconfiar de la foto: la misma pregunta puede dar respuestas distintas dos días seguidos sin que nadie haya tocado nada. Una medición suelta puede estar midiendo el ruido.

El ciclo para medir visibilidad en motores generativos: elegir prompts, ejecutarlos, anotar quién aparece, calcular share of voice y repetir con la misma frecuencia.
No hay panel que lo informe. Se pregunta, se anota y se repite. Lo demás es automatizar eso.Descargar imagen

Cómo se rompe la comparación

Tres formas de arruinar meses de medición sin darse cuenta:

Cambiar la lista de prompts. Agregar tres preguntas nuevas cambia el denominador y el número deja de ser comparable. Si hay que agregar, se agregan y se mide esa serie aparte.

Cambiar el conjunto de competidores. Si en una medición contás a cinco marcas y en la siguiente a doce, tu porción baja sin que haya pasado nada.

Cambiar la sesión. Medir una vez desde tu cuenta y otra desde una ventana privada da resultados distintos por motivos que no tienen que ver con tu trabajo.

Qué hacer con el resultado

Si tu porción sube, mirá de dónde vino: casi siempre es una entrada concreta que empezó a ser citada. Eso te dice qué tipo de contenido replicar.

Si baja y no tocaste nada, mirá quién ganó tu lugar. Abrí la respuesta, mirá qué páginas cita y comparalas con las tuyas.

Si no se mueve en tres meses, el problema probablemente no esté en el formato sino antes: ¿aparecés en los resultados de búsqueda de esas consultas? Sin eso, el modelo no te ve, y está explicado en RAG.

La documentación de Google sobre las funciones de IA del buscador es el contraste oficial de cualquier promesa sobre esta métrica.

4 de 5

Cómo ver en GA4 el tráfico que llega desde la IA

Llega como referencia y se mezcla con el resto si no lo separás. Cómo identificarlo, cómo agruparlo en un canal propio y qué no vas a poder ver nunca.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Si no lo agrupás, queda repartido entre decenas de dominios distintos y cada uno parece insignificante.

Qué dominios mirar

Los principales, a la fecha de esta revisión:

MotorDominios de referencia
ChatGPTchatgpt.com, chat.openai.com
Perplexityperplexity.ai
Geminigemini.google.com
Copilotcopilot.microsoft.com, bing.com con parámetros de chat
Claudeclaude.ai

No esperes volúmenes parecidos entre ellos: cuál deja tráfico y cuál casi nada depende de si la cita va con enlace visible o plegada.

La lista cambia. Conviene revisar cada tanto el informe de referencias completo buscando dominios nuevos con nombres de productos de IA.

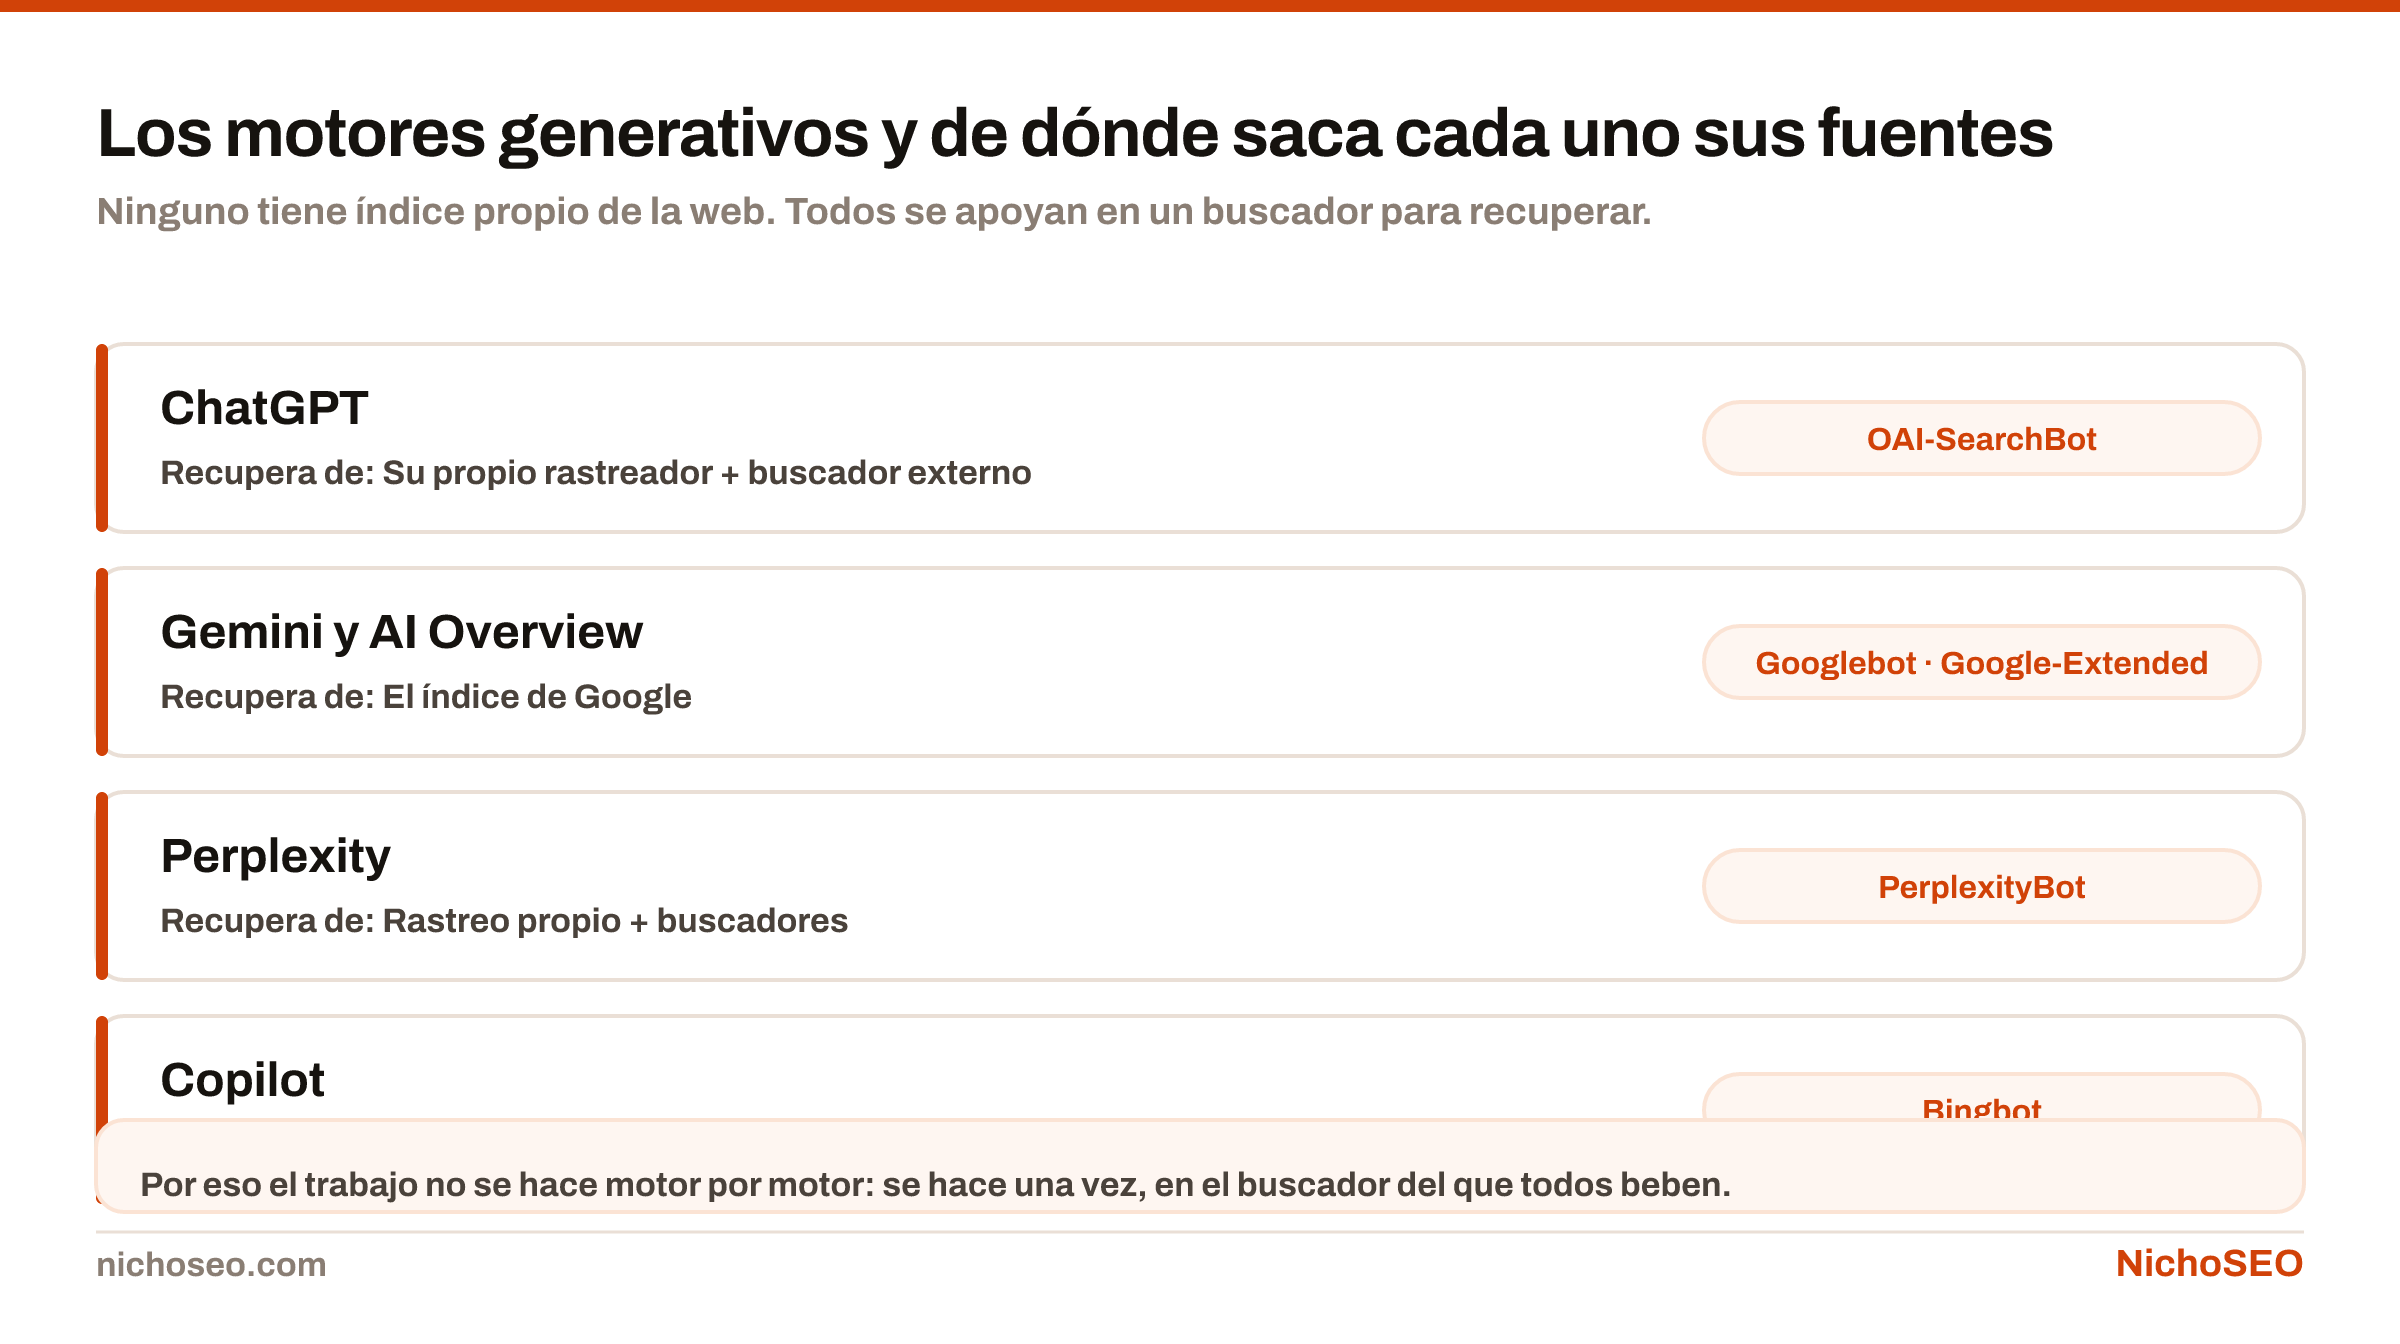
Panorama de los motores generativos: ChatGPT, Gemini, Perplexity, Copilot y AI Overview, con el buscador en el que se apoya cada uno para recuperar documentos.
Ninguno tiene índice propio de la web. Todos se apoyan en un buscador para recuperar.Descargar imagen

Cómo separarlo en GA4, paso a paso

Paso 1. Andá a Administrar → Configuración de datos → Grupos de canales.

Paso 2. Duplicá el grupo de canales predeterminado. No conviene editar el original: si algo sale mal, perdés la referencia de cómo estaba.

Paso 3. Creá un canal nuevo. Llamalo IA generativa o similar.

Paso 4. Definí la condición: Fuente coincide con una expresión regular que liste los dominios.

chatgpt\.com|chat\.openai\.com|perplexity\.ai|gemini\.google\.com|copilot\.microsoft\.com|claude\.ai

Paso 5. Movelo por encima de «Referencia» en el orden de evaluación. GA4 aplica la primera condición que coincide, así que si queda debajo no se va a usar nunca.

Paso 6. Esperá. El grupo de canales aplica desde que se crea y no reprocesa el histórico.

Qué no vas a ver nunca

Acá conviene ser claro para no buscar lo que no está.

La pregunta que hizo la persona. No viaja en la referencia. No hay equivalente al informe de consultas de Search Console.

Las menciones sin enlace. Si el motor te nombró y no te enlazó, no hubo visita y por lo tanto no hay nada que registrar. Y esa es la mayoría de los casos.

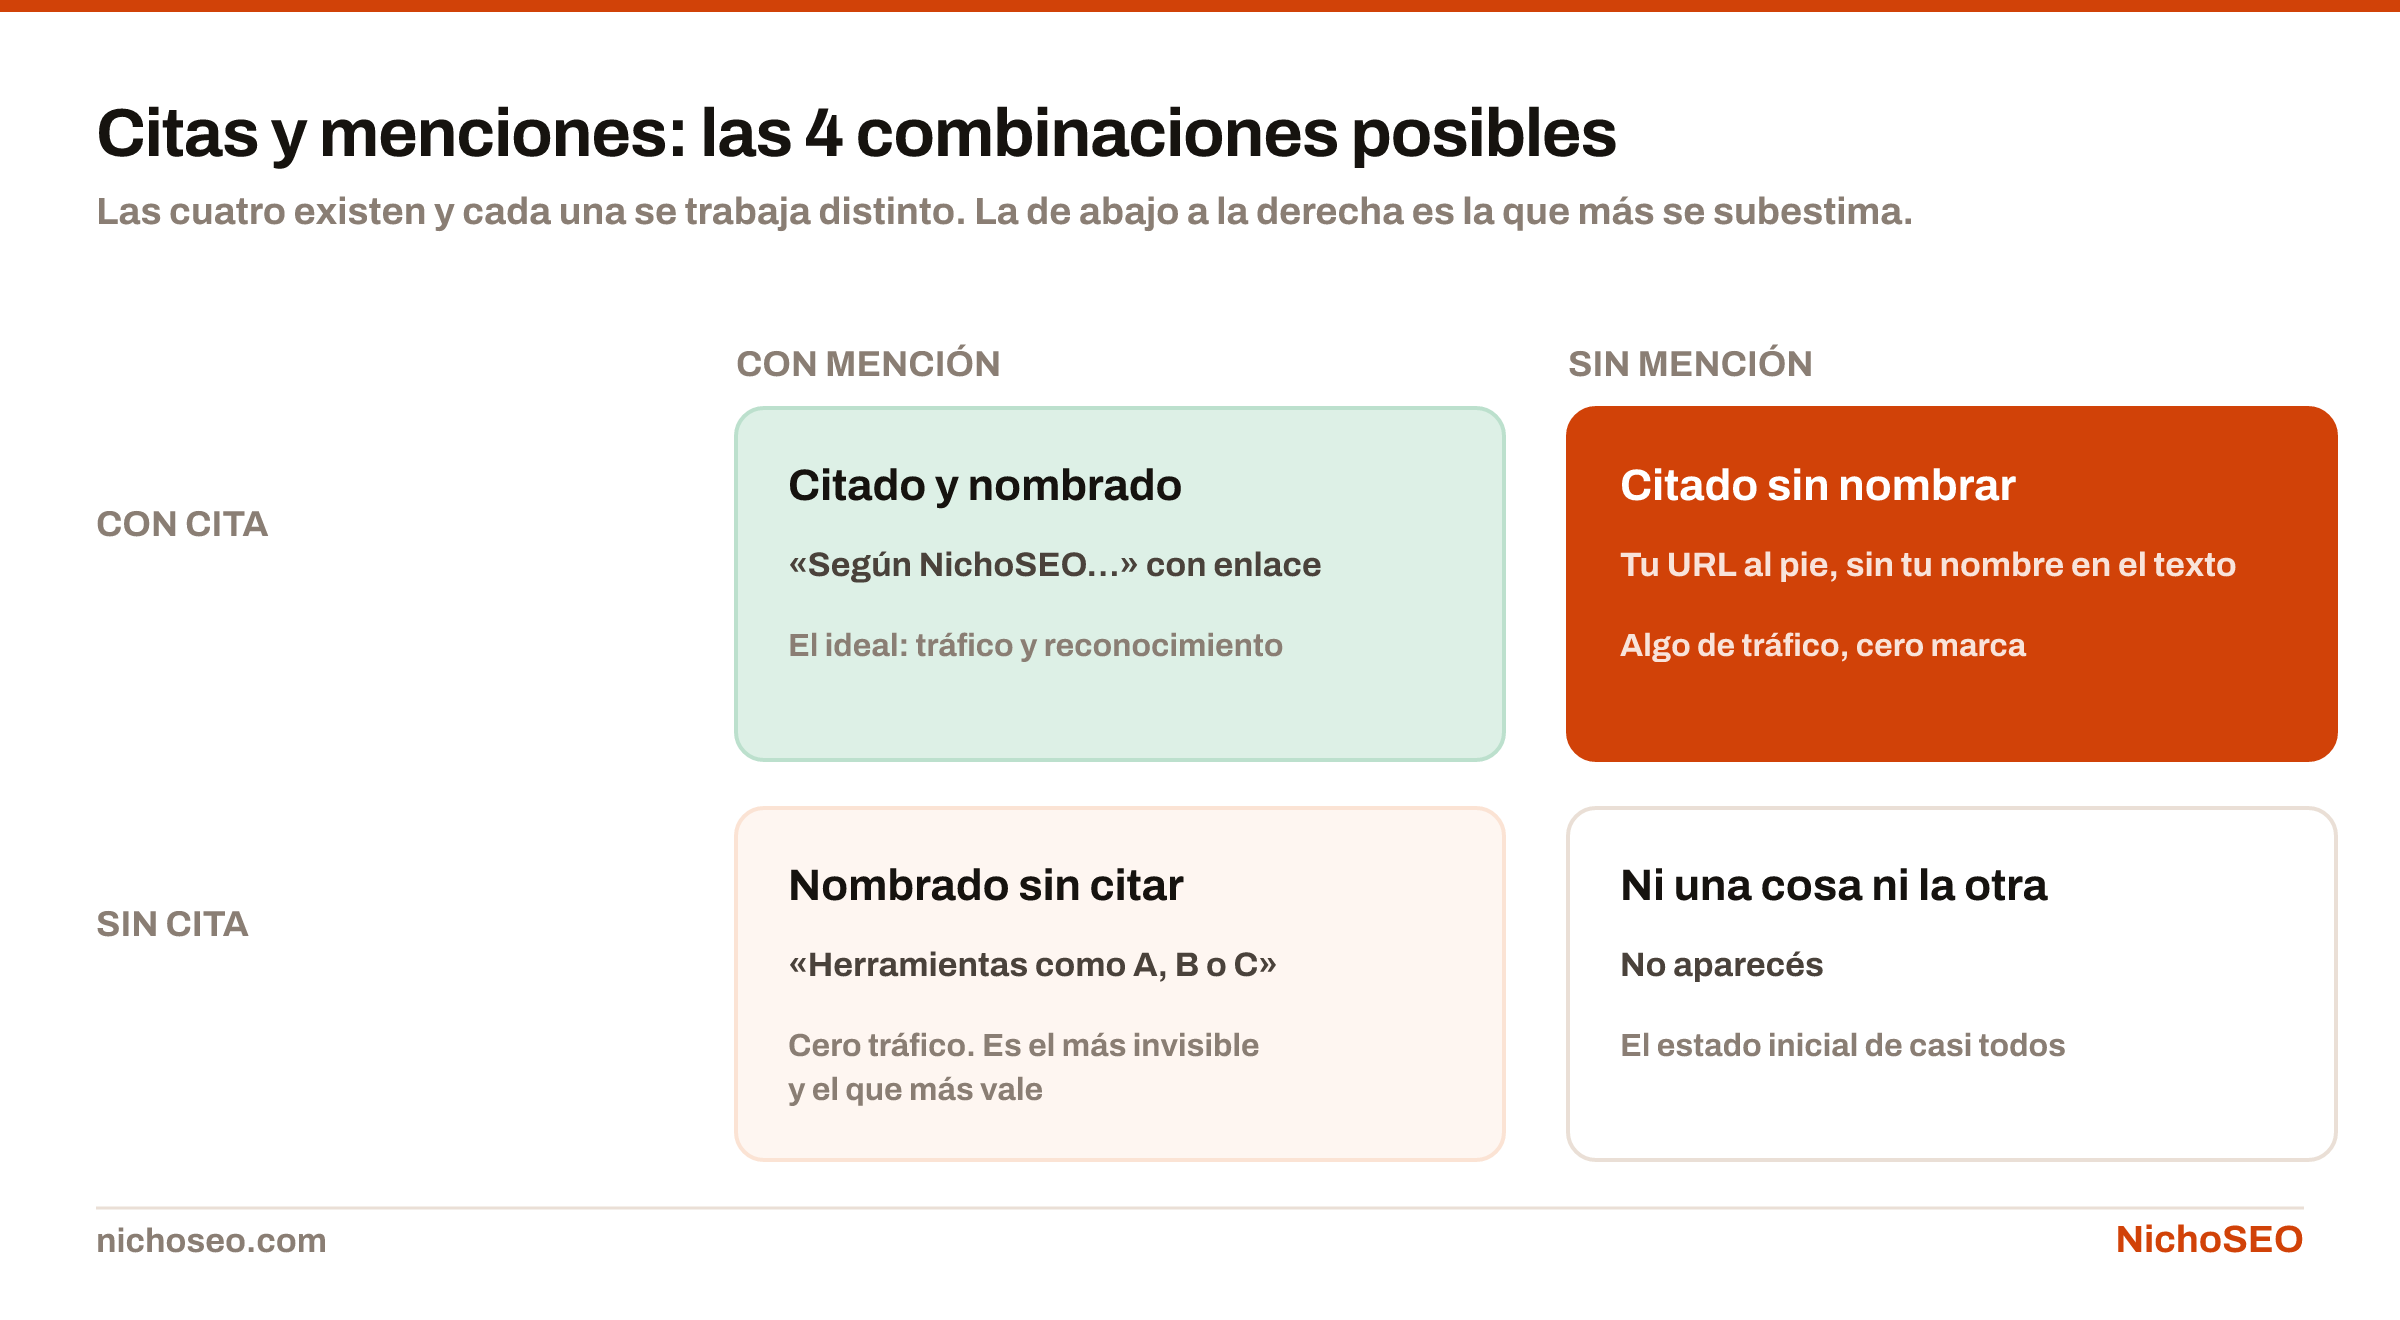
Matriz de citas y menciones: citado y nombrado, citado sin nombrar, nombrado sin citar, y ninguna de las dos.
Las cuatro existen y cada una se trabaja distinto. La de abajo a la derecha es la que más se subestima.Descargar imagen

Por eso el tráfico en GA4 es la punta del iceberg: mide la fracción de tus apariciones que además trajo gente. Para el resto hace falta medir preguntando.

Cómo leer lo que sí ves

Mirá el volumen con expectativas correctas. Va a ser chico comparado con la búsqueda orgánica. Eso no significa que el canal no importe: significa que el canal no se mide por visitas.

Mirá qué páginas reciben ese tráfico. Son las que los motores están citando. Es información directa sobre qué contenido tuyo funciona como fuente, y sirve para decidir qué replicar.

Mirá el comportamiento. Quien llega desde una respuesta generada suele venir más informado y más avanzado en la decisión, porque ya leyó un resumen del tema. Compará conversión, no sesiones.

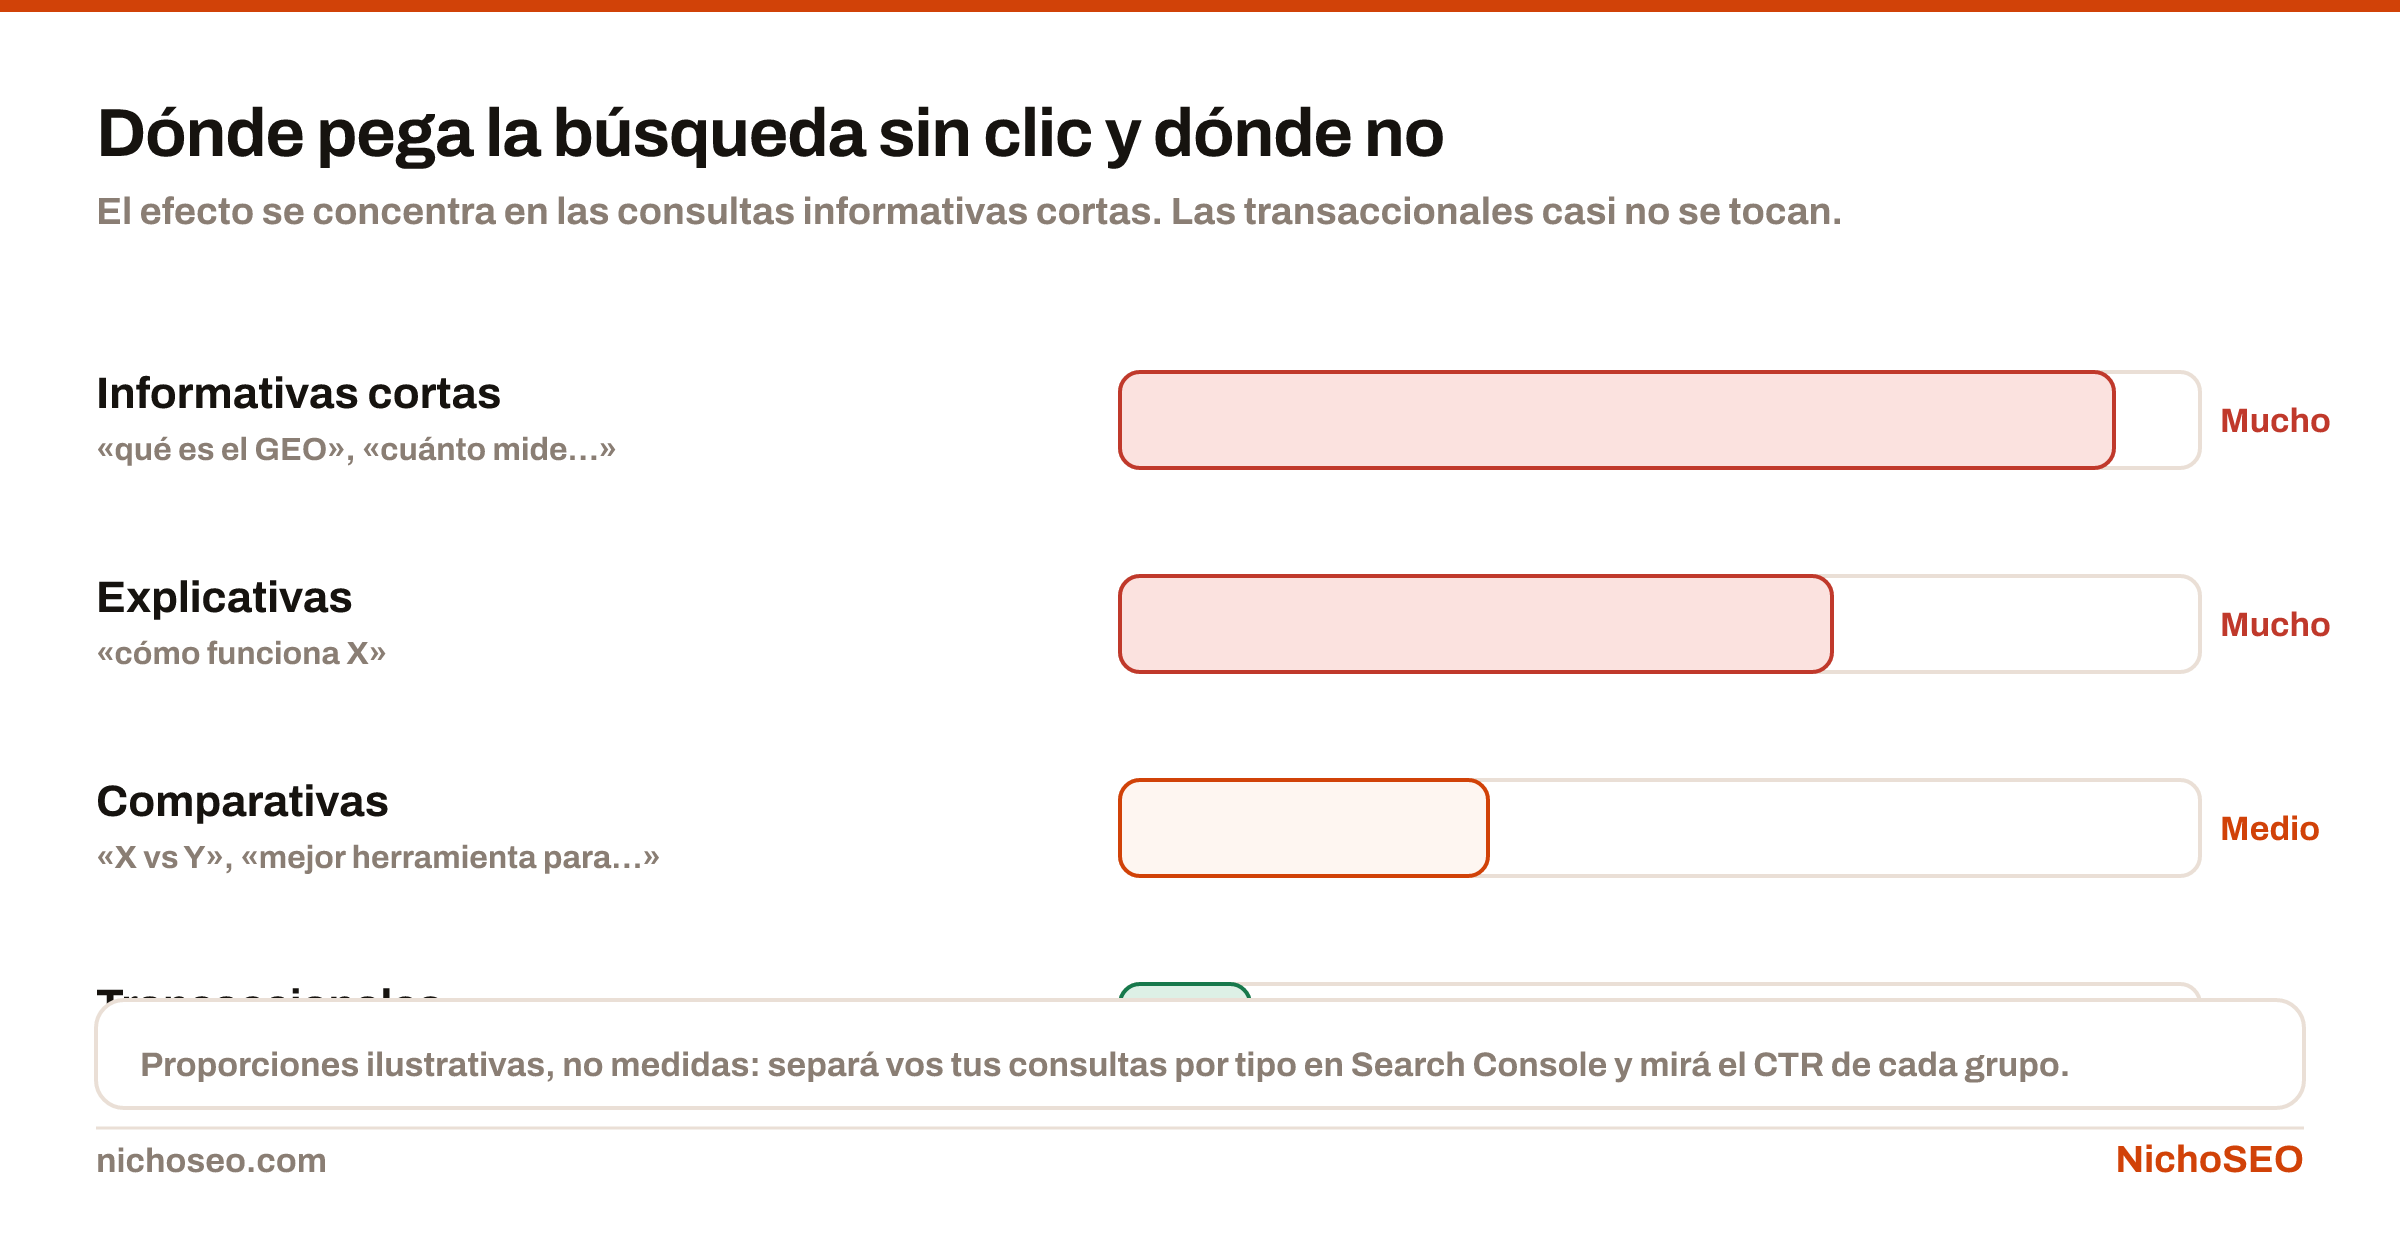
El impacto de las búsquedas sin clic por tipo de consulta: fuerte en informativas cortas, medio en explicativas, bajo en comparativas y casi nulo en transaccionales.
El tráfico que ves en GA4 se concentra donde la consulta todavía deja pasar clics. Lo informativo casi no aparece.Descargar imagen

El error de dar de baja lo que no trae visitas

Es la consecuencia práctica más cara de no entender esto.

Una página informativa puede no traer ninguna visita desde IA y estar siendo citada constantemente. Si la medís solo con GA4, va a parecer contenido muerto, y darla de baja es regalar la mención.

La regla que evita ese error está en búsquedas sin clic: mirá las dos cosas antes de tocar nada.

Google describe cómo se comporta su propio tráfico desde funciones de IA en su documentación.

5 de 5

Benchmark en IA: a quién recomienda el modelo en tu lugar

Medir si aparecés responde media pregunta. La otra media es quién aparece cuando vos no, que casi nunca son los competidores que tenías en la cabeza.

Sebastián Cardozo · Cofundador de Ranker y de Crecerank · revisada el 26 de sept de 2026

Es el dato más útil que produce una medición de GEO, y el que casi nadie registra.

Por qué medir solo si aparecés responde media pregunta

Una planilla que dice “no aparecés en 14 de 20 prompts” informa un problema y nada más.

La misma planilla, anotando quién sí aparece, dice contra quién perdés, en qué temas, y si el que gana es siempre el mismo o cambia según la pregunta. Eso ya es un plan de trabajo.

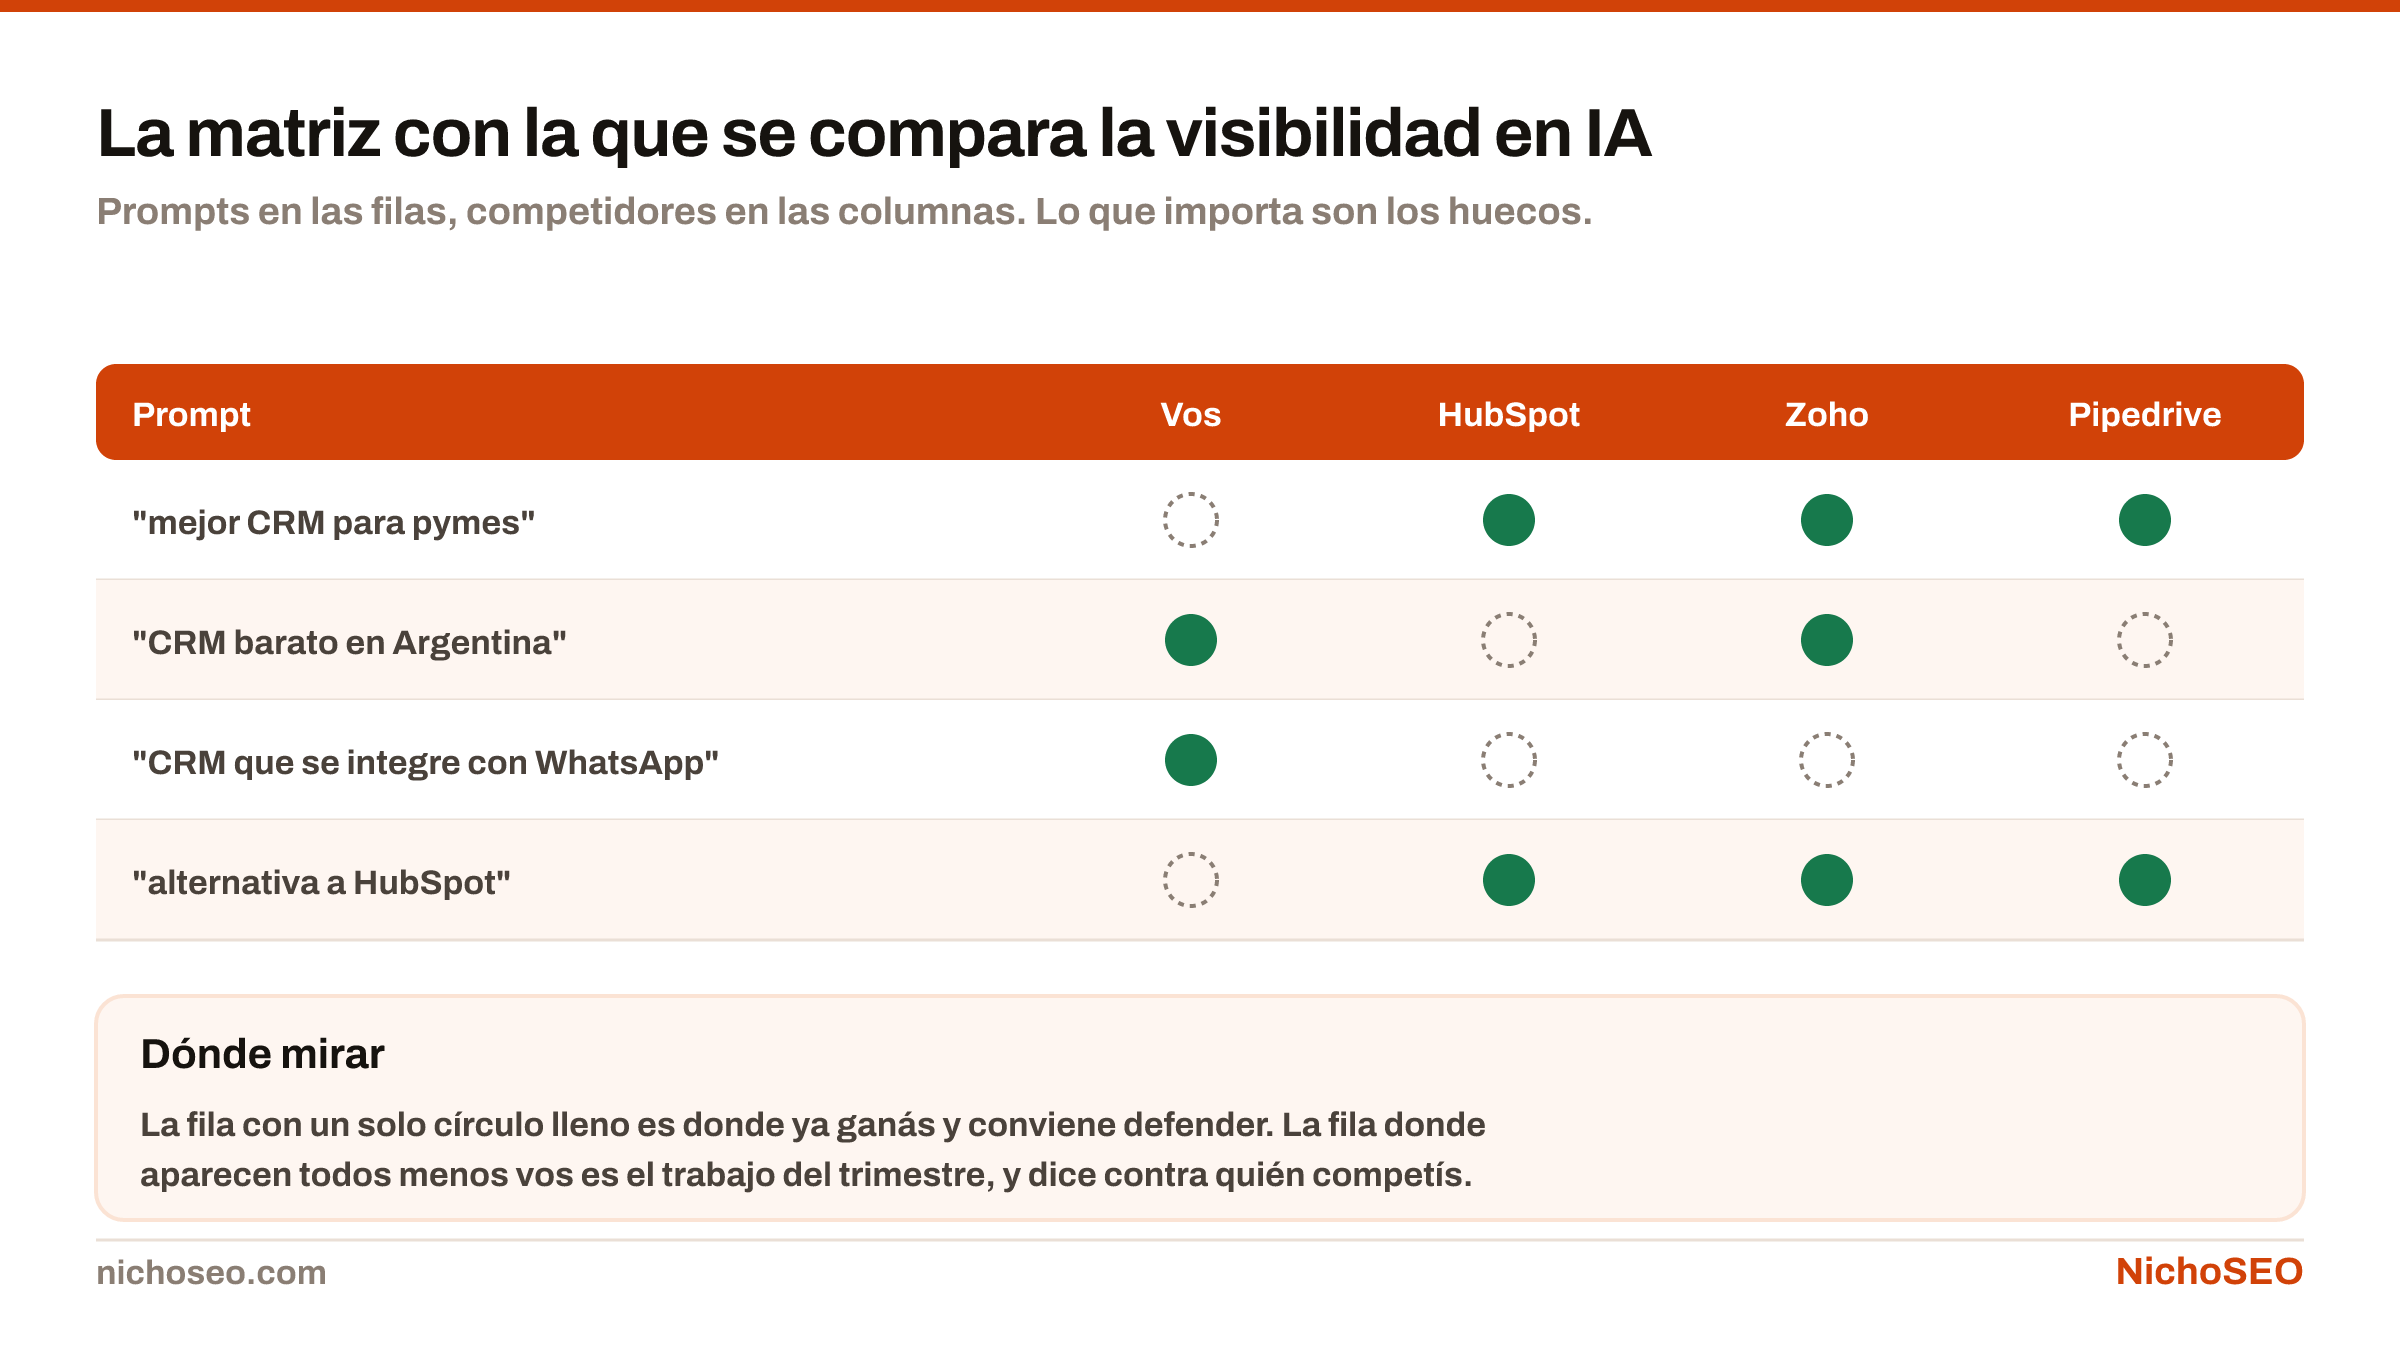
Una matriz de benchmark con prompts en las filas y competidores en las columnas, donde cada celda marca si esa marca apareció, y los huecos señalan dónde se puede ganar terreno.
Prompts en las filas, competidores en las columnas. Lo que importa son los huecos.Descargar imagen

La matriz, lista para descargar, con una columna por competidor y otra para lo que dijo la respuesta.

La matriz se lee por los huecos, no por los círculos llenos. Una fila donde aparecen todos menos vos es trabajo concreto; una donde aparecés solo vos es algo que conviene defender.

Los competidores del modelo no son los tuyos

Este es el hallazgo que más sorprende cuando se hace por primera vez.

En una búsqueda tradicional competís con quien rankea para tus mismas palabras. En una respuesta generativa competís con quien el modelo considera comparable, que es otra cosa.

Tres diferencias habituales:

Aparecen marcas de otro tamaño. Un modelo que recomienda herramientas no filtra por facturación: filtra por qué tan bien documentada está cada opción. Un producto chico y muy explicado le gana a uno grande y opaco.

Aparecen marcas de otro país. Si tu categoría está mejor cubierta en inglés, el modelo puede recomendarte competidores que no operan donde vos.

Aparecen cosas que no son productos. Para muchas consultas, lo que el modelo recomienda incluye una guía, un foro o una alternativa gratuita. Eso también te está ocupando lugar.

Lo que el benchmark te dice

  • Quién aparece en cada tipo de pregunta
  • Si el líder es el mismo en los tres motores
  • En qué temas ya ganás y conviene defender
  • Qué opciones no comerciales te ocupan lugar

Lo que suponías

  • «Competimos con estos tres»
  • «Somos los más grandes del rubro»
  • «Estamos bien en nuestro nicho»
  • «El problema es que somos nuevos»
La columna de la izquierda sale de datos; la de la derecha, de la reunión de estrategia.

Cómo se arma: una columna más

Si ya medís, el benchmark no es un trabajo nuevo. Es una columna.

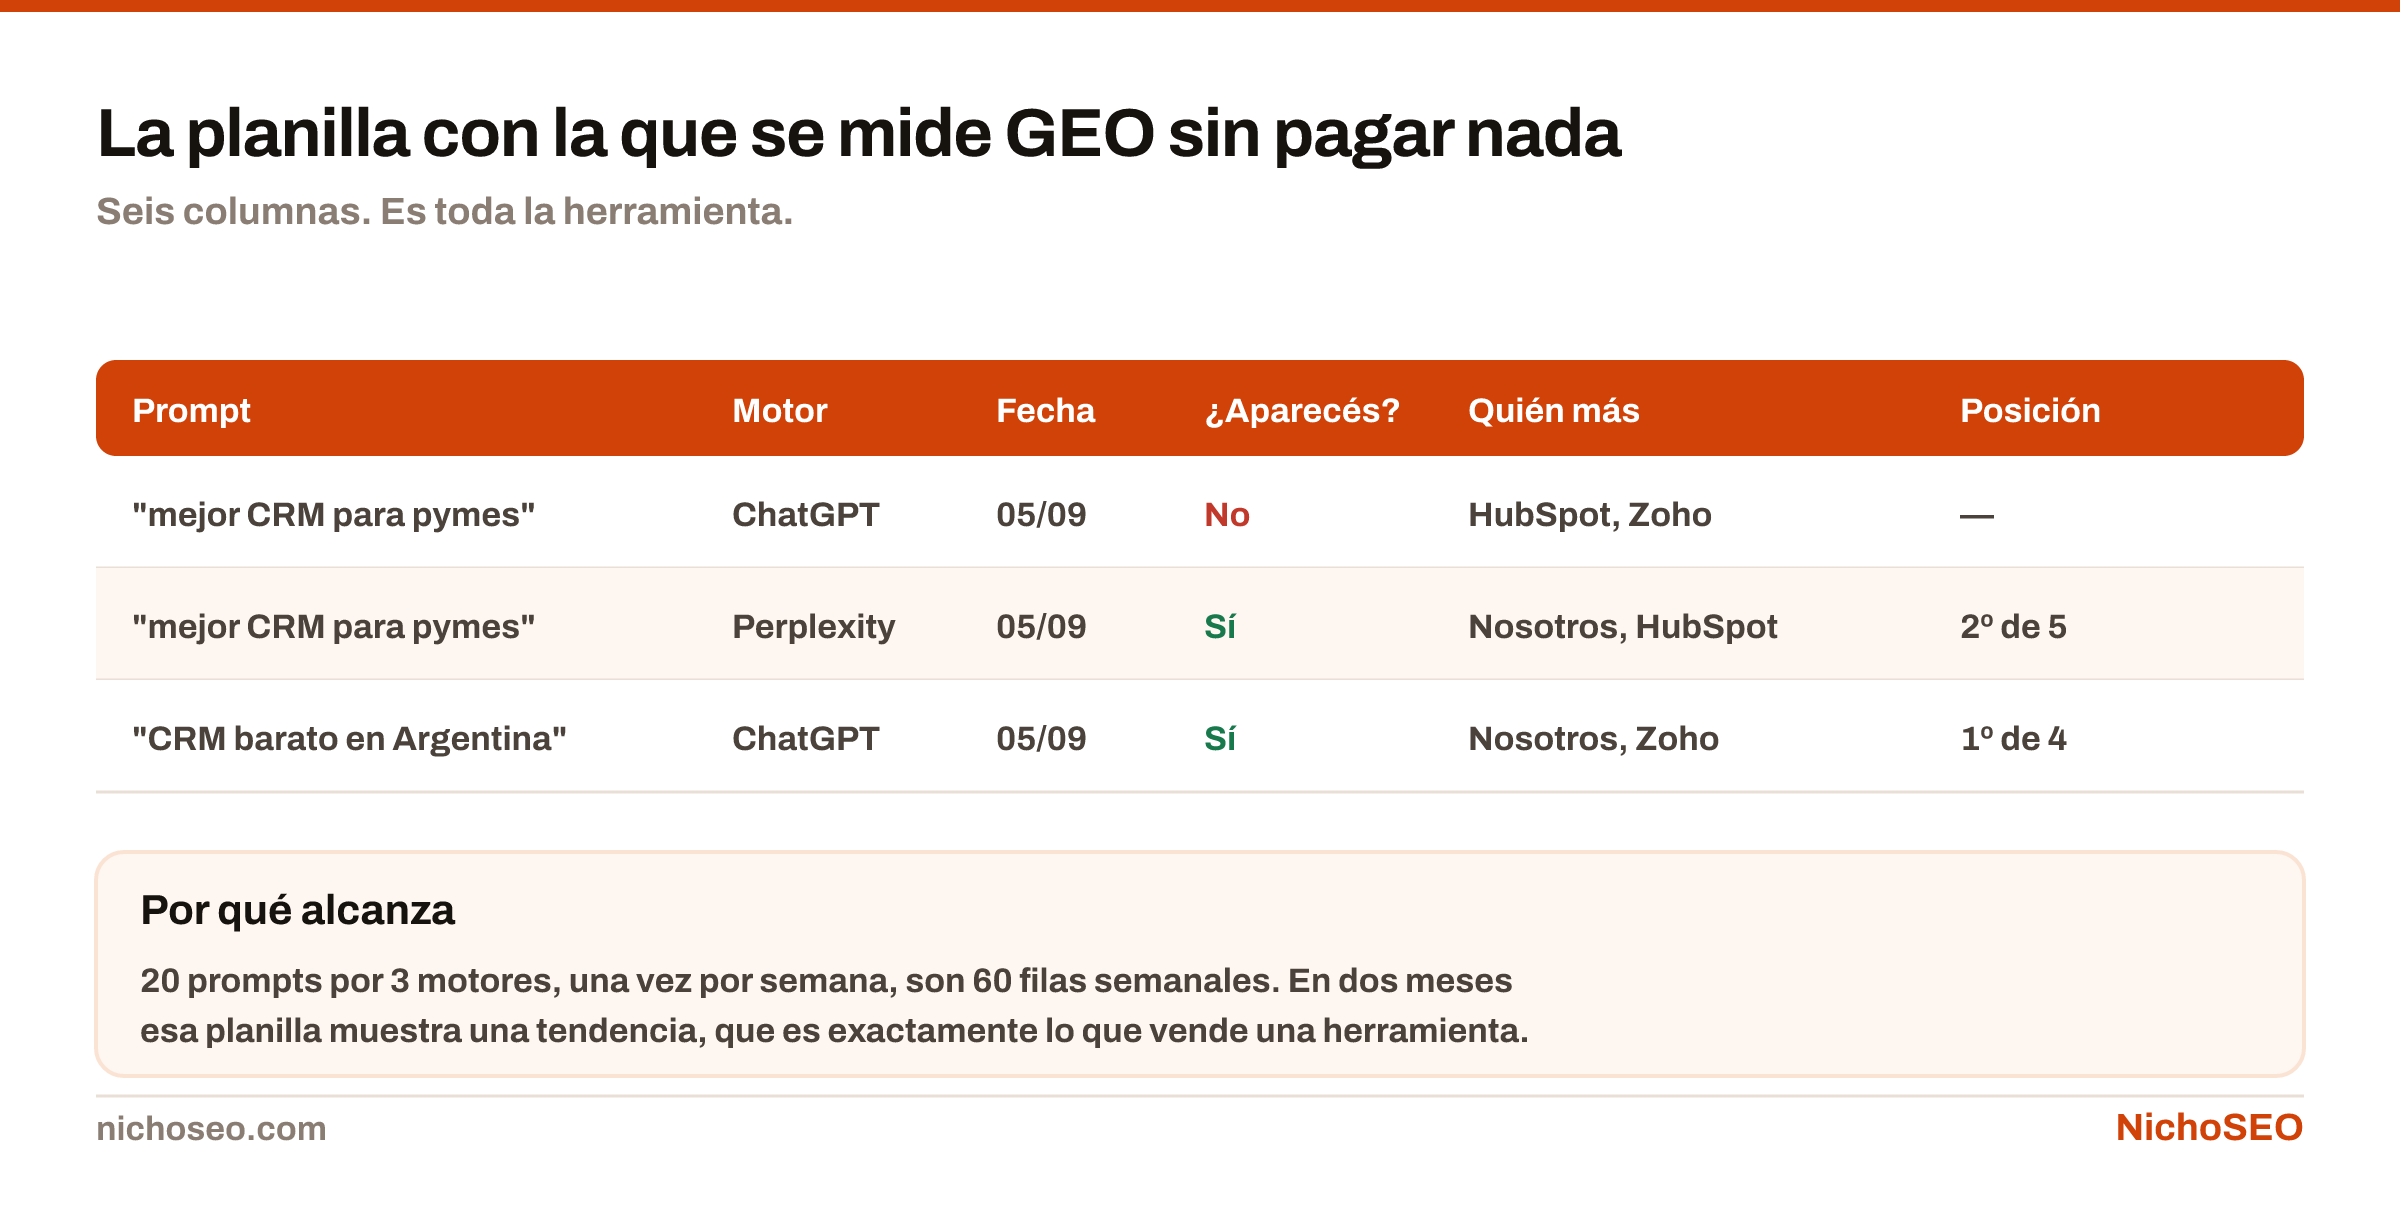
Una planilla de seis columnas para medir visibilidad en IA sin herramientas de pago: prompt, motor, fecha, si aparecés, quién más aparece y en qué posición, con tres filas de ejemplo.
Seis columnas. Es toda la herramienta.Descargar imagen

La columna “quién más” se completa con los nombres que aparecen en la respuesta, en el orden en que aparecen. Nada más.

Dos detalles que hacen la diferencia:

El orden importa. El primero que nombra el modelo no es igual al cuarto. Anotarlo como “HubSpot, Zoho, nosotros” conserva una información que “aparecemos” pierde.

Guardá la respuesta completa, al menos las primeras veces. El motivo por el que el modelo recomienda a alguien suele estar escrito en la respuesta, y es la pista más directa de qué le falta a tu página.

Los prompts son los mismos que ya medís, y conviene que estén repartidos por tipo: los de comparación son los que más competidores revelan.

Los cuatro tipos de prompt que conviene seguir: de marca, de categoría, de comparación y de problema, con qué mide cada uno.
Cuatro tipos, y solo uno te dice si te recomiendan. Seguir solo el primero es engañarse.Descargar imagen

El método de medición completo está en cómo armar un stack de GEO sin gastar nada, y el criterio para elegir los prompts, en prompt tracking.

Cómo se lee

Tres lecturas, de la más simple a la más útil.

1. Quién aparece más veces

Es el ranking crudo. Sirve para saber quién domina tu categoría en respuestas, que puede no ser quien la domina en Google.

El cálculo es el mismo del share of voice, aplicado a cada competidor: en cuántas respuestas aparece, sobre el total. Cómo se calcula está en share of voice en IA.

2. Dónde estás vos y ellos no

Son tus prompts propios: temas donde ya te ganaste un lugar.

Qué hacer con cada tipo de fila

Solo vosDefenderMantener actualizada la página que te da ese lugar
Vos y otrosMejorarEstás en la conversación; falta ser el primero
Todos menos vosEl trabajoAcá está el plan del trimestre
La tercera fila es la que se convierte en tareas.

Conviene mirarlos: suelen ser temas donde escribiste algo concreto que nadie más escribió, y eso es replicable.

3. Dónde aparecen todos menos vos

Es la lectura que produce trabajo.

Para cada una de esas filas, la pregunta es qué tienen los que aparecen que vos no tengas. Casi siempre es una de tres cosas: una página que responde exactamente esa pregunta, un dato propio que nadie más publica, o reseñas y menciones de terceros.

Las dos primeras se resuelven escribiendo. La tercera es la lenta.

El error de perseguir al que aparece siempre

Si una marca aparece en los veinte prompts, la conclusión tentadora es copiar lo que hace.

Suele ser la conclusión equivocada, porque esa marca aparece por acumulación: años de menciones, documentación, reseñas y presencia en fuentes que los modelos leen. Nada de eso se replica en un trimestre.

La conclusión útil es otra: buscar la fila donde esa marca no está. Un prompt específico donde el líder no aparece es una consulta que nadie cubrió bien, y ahí sí se puede ganar en meses.

Es la misma lógica que la de las consultas largas en SEO: el long tail no es un premio consuelo, es donde se puede competir.

Con qué frecuencia

La misma que la medición: una vez por semana, o cada quince días si la lista es larga.

Lo que no conviene es hacerlo solo cuando alguien pregunta. Un benchmark de una sola fecha tiene el mismo problema que una medición de una sola fecha: no distingue una tendencia de la variación normal entre sesiones.

Y como todo lo demás, la lista de prompts se congela. Si aparecen competidores nuevos, se agregan a la columna, pero las preguntas siguen siendo las mismas.

Qué hacer con el resultado

Tres decisiones salen directo de la matriz:

  1. Elegí tres filas del grupo “todos menos vos” que sean las más cercanas a lo que hacés. Esas son el trabajo del trimestre.
  2. Mirá la respuesta guardada de esas tres y anotá por qué el modelo recomienda a quien recomienda. Suele estar escrito.
  3. Revisá las filas donde ganás y asegurate de que la página que te da ese lugar esté actualizada. Perder algo que ya tenías es más caro que no ganarlo.

El contexto general de qué se mide en GEO y con qué métricas está en cómo medir la visibilidad en IA.

Si querés ver cómo estos sistemas deciden qué fuentes mostrar, la explicación oficial de OpenAI está en su centro de ayuda.