
Puntos clave
- Un LLM predice qué palabra sigue, una por vez. No consulta una base de datos: genera la respuesta.
- Lo que sabe de fábrica viene del entrenamiento y tiene fecha de corte.
- No distingue entre lo que sabe y lo que suena bien. Por eso inventa con la misma seguridad con la que acierta.
- Para GEO importa una sola cosa: si no estás en el entrenamiento ni en lo que recupera al buscar, no existís para el modelo.
- El entrenamiento no se controla. Lo que recupera en el momento, sí.
Tomate esa definición al pie de la letra, porque es literal y porque de ella sale todo lo demás.
Cómo funciona un modelo de lenguaje
Si le escribís «la capital de Francia es», el modelo no consulta ningún registro de capitales.
Calcula qué palabra es la más probable a continuación de esa secuencia, dado todo el texto que vio durante su entrenamiento. Responde «París».
Después toma «la capital de Francia es París» y vuelve a calcular qué sigue.
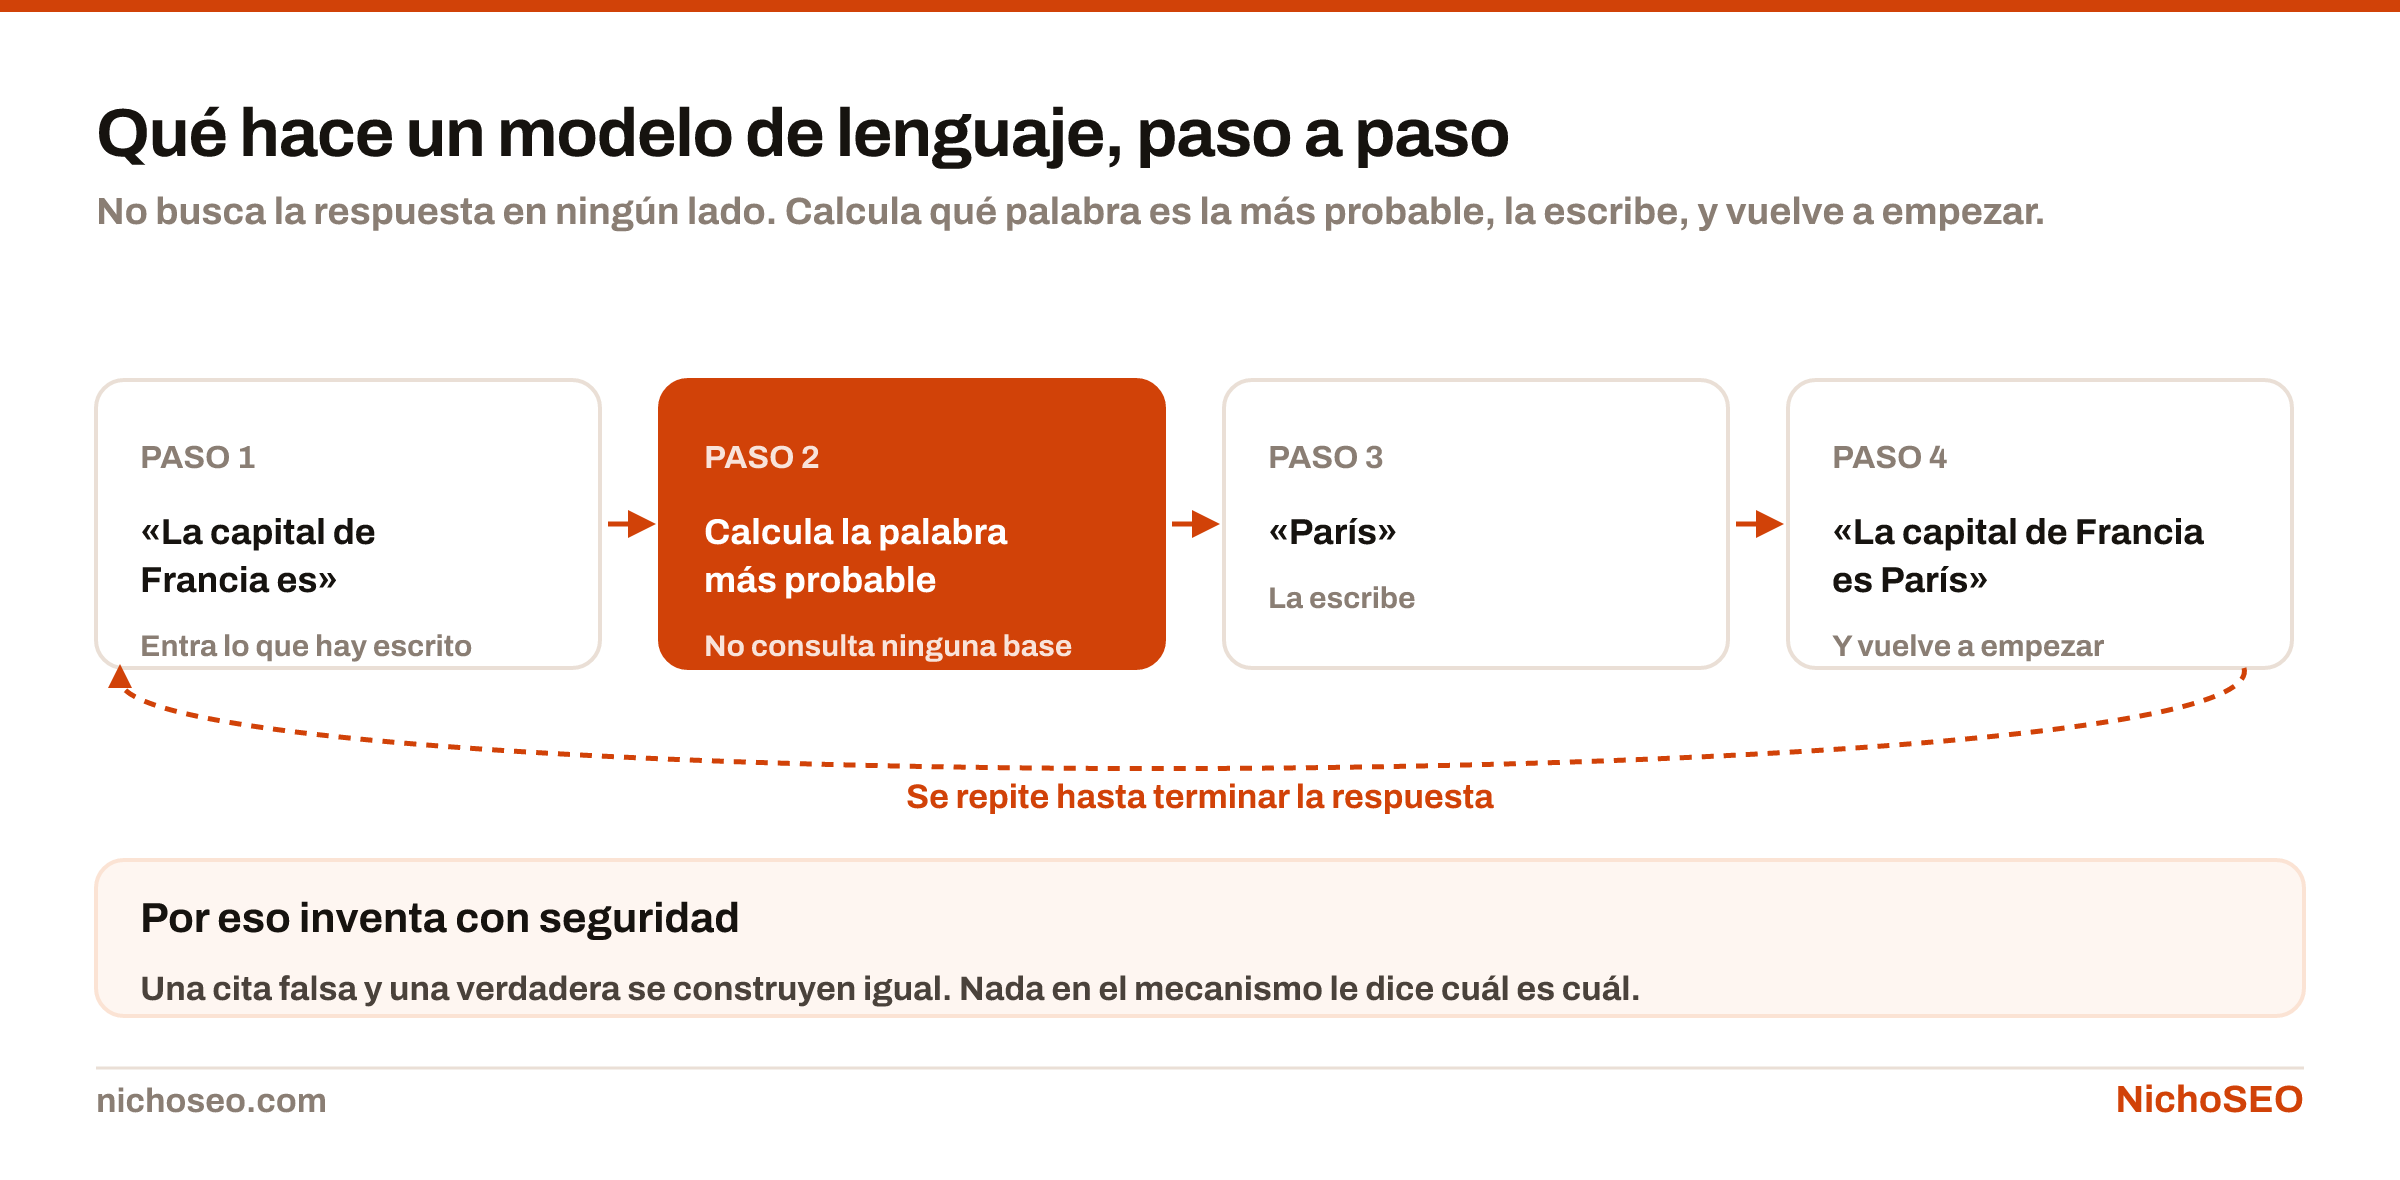
Eso es todo el mecanismo.
Lo que lo vuelve sorprendente no es el procedimiento sino la escala. Entrenado sobre cantidades enormes de texto, predecir la palabra siguiente termina produciendo resúmenes, argumentos y explicaciones que se parecen mucho a razonar.
La arquitectura que hizo esto posible se describió en un trabajo de 2017. Desde entonces todos los modelos grandes son variaciones sobre esa idea.
Por qué un LLM inventa: la intuición que hay que sacarse de encima
Casi todos los errores al trabajar con estos sistemas vienen de la misma suposición: pensar que el modelo busca la respuesta en algún lado.
No la busca. La genera.
Y eso tiene tres consecuencias que se ven todos los días.
Un buscador que no encuentra nada devuelve cero resultados. Un modelo que no sabe algo igual produce una respuesta, porque producir texto es literalmente lo único que sabe hacer. Nada en el mecanismo lo empuja a decir «no sé».
1. Inventa con seguridad
Una cita falsa y una verdadera se construyen igual: palabra probable tras palabra probable.
El modelo no tiene una señal interna que distinga una de la otra. Así que tampoco tiene forma de sonar menos seguro cuando está equivocado.
Eso se llama alucinación, y no es un fallo que se pueda parchear. Es el mecanismo funcionando como fue diseñado.
2. Tiene fecha de corte
Lo que el modelo aprendió quedó fijado el día que terminó el entrenamiento.
Un cambio de la semana pasada no está ahí. Y no va a estar, salvo que el sistema lo busque en el momento de responder.
3. No se actualiza porque publiques
Tu artículo de hoy no entra en el modelo por el hecho de haberlo publicado.
Entra en el próximo entrenamiento, si entra. Y eso no lo decide nadie a quien le puedas escribir.
Entrenamiento y contexto: de dónde sale cada respuesta
Esta es la distinción más útil de todo el tema, y la que ordena qué podés trabajar y qué no.
Cuando un motor generativo te contesta, lo que dice sale de uno de dos sitios. O de los dos mezclados.
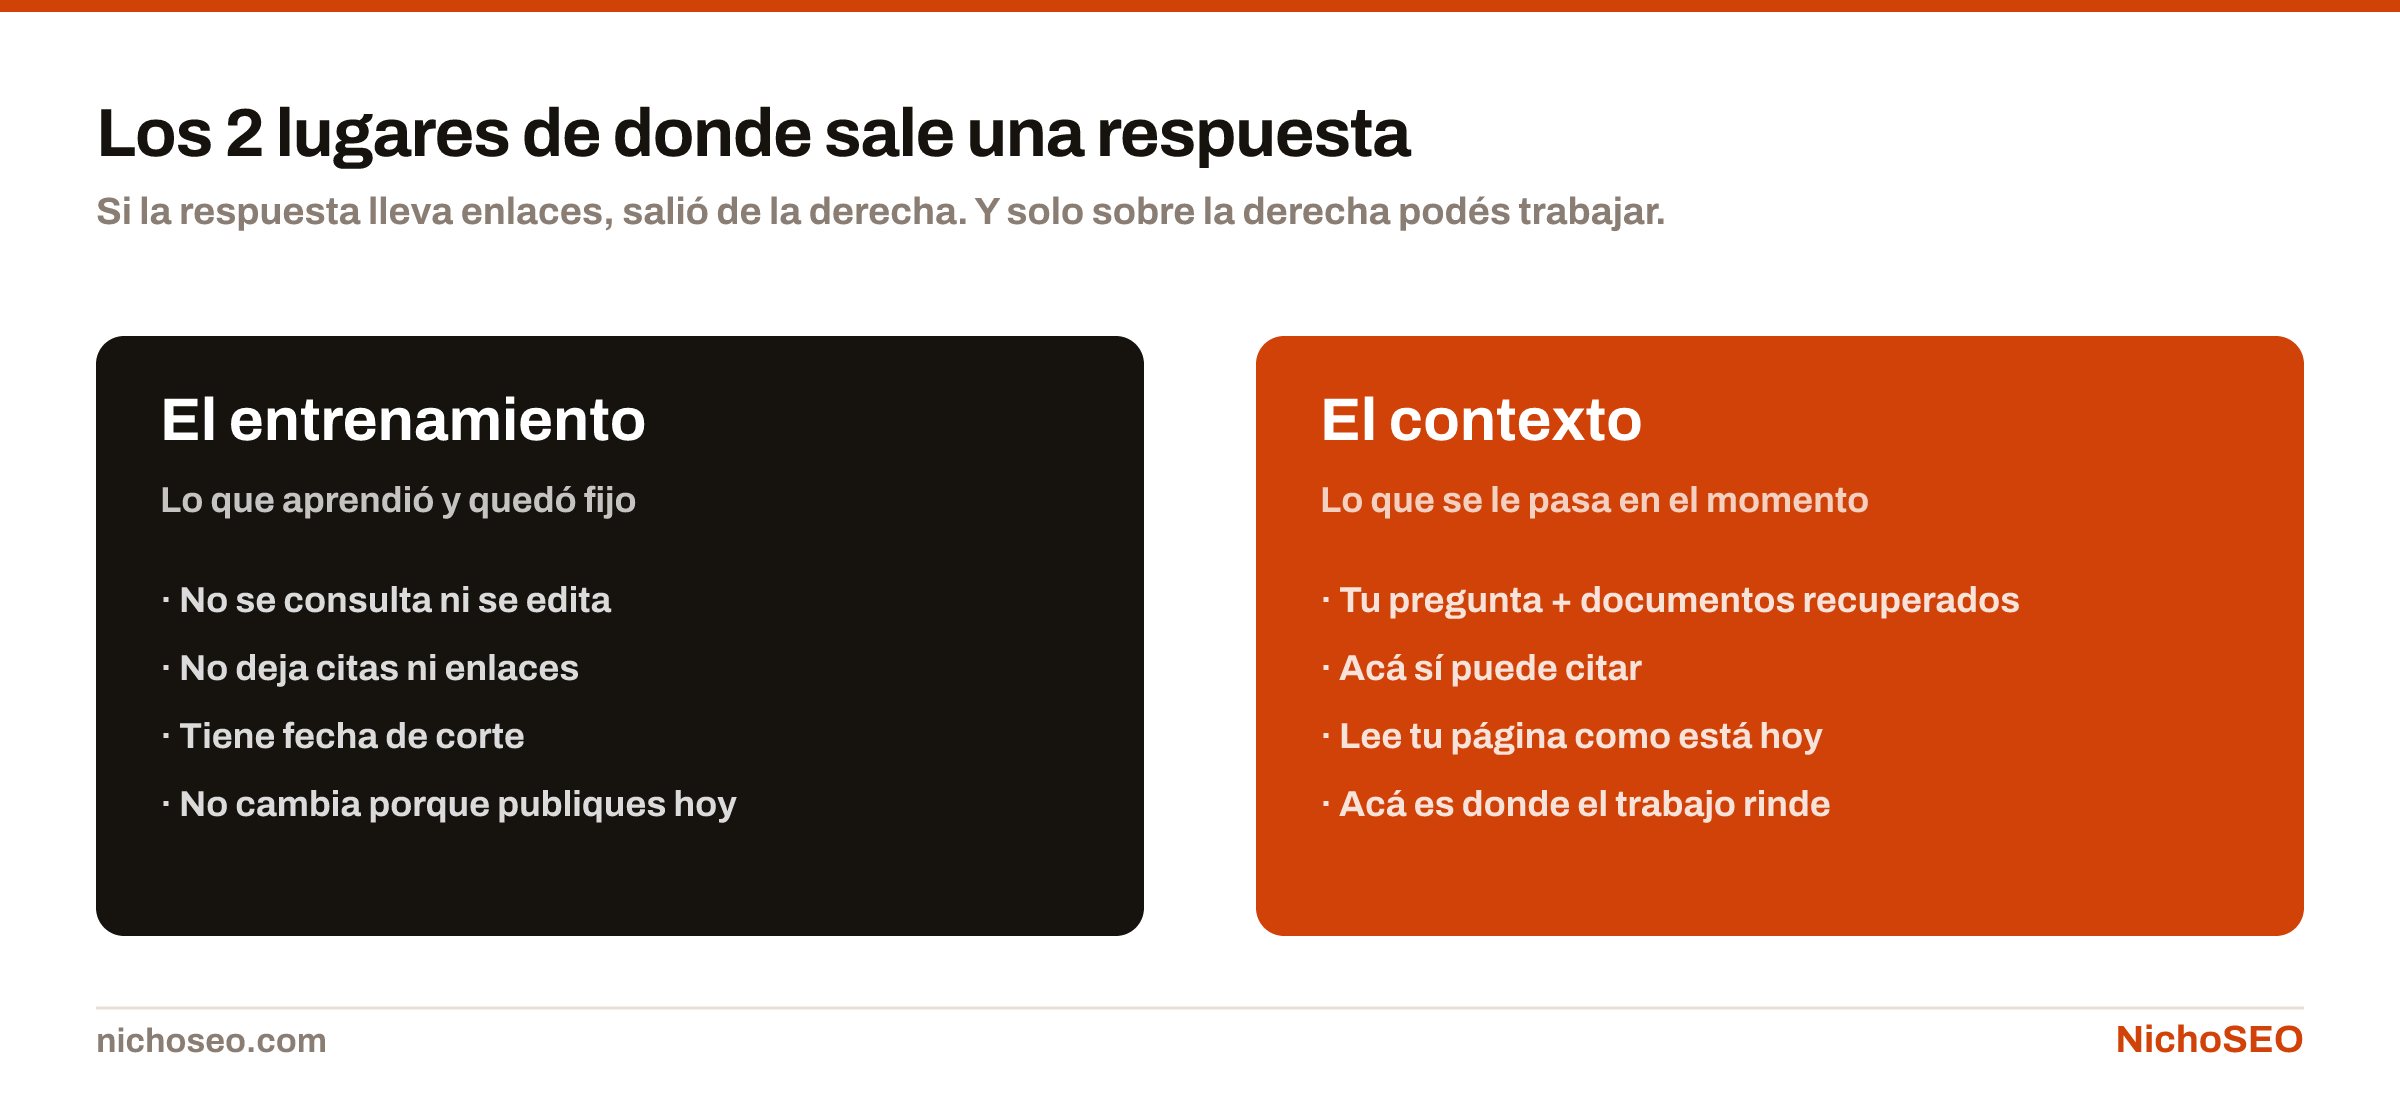
La diferencia la notás apenas mirás una respuesta: si lleva enlaces, salió de la columna derecha.
El modelo no puede citar lo que aprendió durante el entrenamiento, porque ahí no guardó de dónde venía cada cosa. Absorbió patrones, no fichas bibliográficas.
Solo puede señalar una fuente cuando la tiene delante mientras escribe.
Por eso casi todo lo que se llama GEO ocurre en la columna derecha, y el mecanismo que la habilita tiene nombre propio: RAG.
Y por eso también: cuando alguien te promete «hacer que el modelo aprenda tu marca», está hablando de la columna izquierda. Esa no se compra.
Qué no es un LLM: tres comparaciones equivocadas

No es una base de datos. No hay un registro que se pueda consultar, corregir ni dar de baja. Si un modelo dice algo equivocado sobre tu empresa, no hay un campo que alguien pueda editar.
No es un buscador. No tiene índice propio de la web. Cuando busca, se apoya en uno externo, y por eso el SEO sigue decidiendo si te ve.
No razona como una persona, aunque el texto lo parezca mucho. Produce el encadenamiento más probable, que a veces coincide con un razonamiento correcto y a veces con uno equivocado que suena bien.
Qué significa todo esto para tu visibilidad
Se comprime en una sola regla, y es la que ordena cualquier decisión sobre estos sistemas:
Si tu contenido no está en el entrenamiento ni en lo que el sistema recupera al momento de responder, no existís para el modelo.
De los dos, el entrenamiento no se controla. Es material del pasado, cerrado, y nadie publica cómo se arma.
Lo recuperado sí, y depende de cosas conocidas:
- Que tu página exista y sea rastreable
- Que aparezca en resultados de búsqueda para las consultas que el sistema termina ejecutando
- Que esté escrita de forma que un fragmento se pueda usar sin romperse
Dicho de otro modo: el trabajo empieza en el mismo lugar de siempre. Es una buena noticia disfrazada de mala.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Historial de revisiones
- Se aplicó el playbook: encabezados descriptivos, tres imágenes descargables y redacción en segunda persona.
- Se reescribió para explicar el mecanismo de predicción antes de sacar conclusiones sobre él, con el ejemplo de la palabra siguiente.
- Publicada.