

Puntos clave
- llms.txt es un archivo Markdown en la raíz del sitio que resume su contenido para un modelo de lenguaje.
- Es una propuesta de la comunidad, no un estándar adoptado: hoy ningún motor grande confirmó usarlo para decidir citas.
- Ponerlo cuesta poco y no rompe nada, pero no reemplaza nada de lo que sí funciona.
- Si lo ponés, generalo en el build. Un índice mantenido a mano se desactualiza en la segunda página nueva y pasa a ser peor que no tenerlo.
La idea es razonable: un modelo que quiere entender rápido un sitio no debería tener que rastrear cuatrocientas páginas para descubrir la estructura.
Cómo se ve un archivo llms.txt
# NichoSEO

> Manual de SEO y GEO en castellano. Entradas firmadas, fechadas y revisadas.

## Fundamentos
- [¿Qué es el GEO?](/blog/que-es-el-geo/): definición y métricas.
- [GEO vs SEO](/blog/geo-vs-seo/): dónde comparten trabajo y dónde se separan.

## Motores generativos
- [Cómo funciona la búsqueda de ChatGPT](/blog/busqueda-de-chatgpt/)
Un encabezado, una descripción de una línea y listas de enlaces con contexto. Nada más.
De dónde viene la propuesta de llms.txt
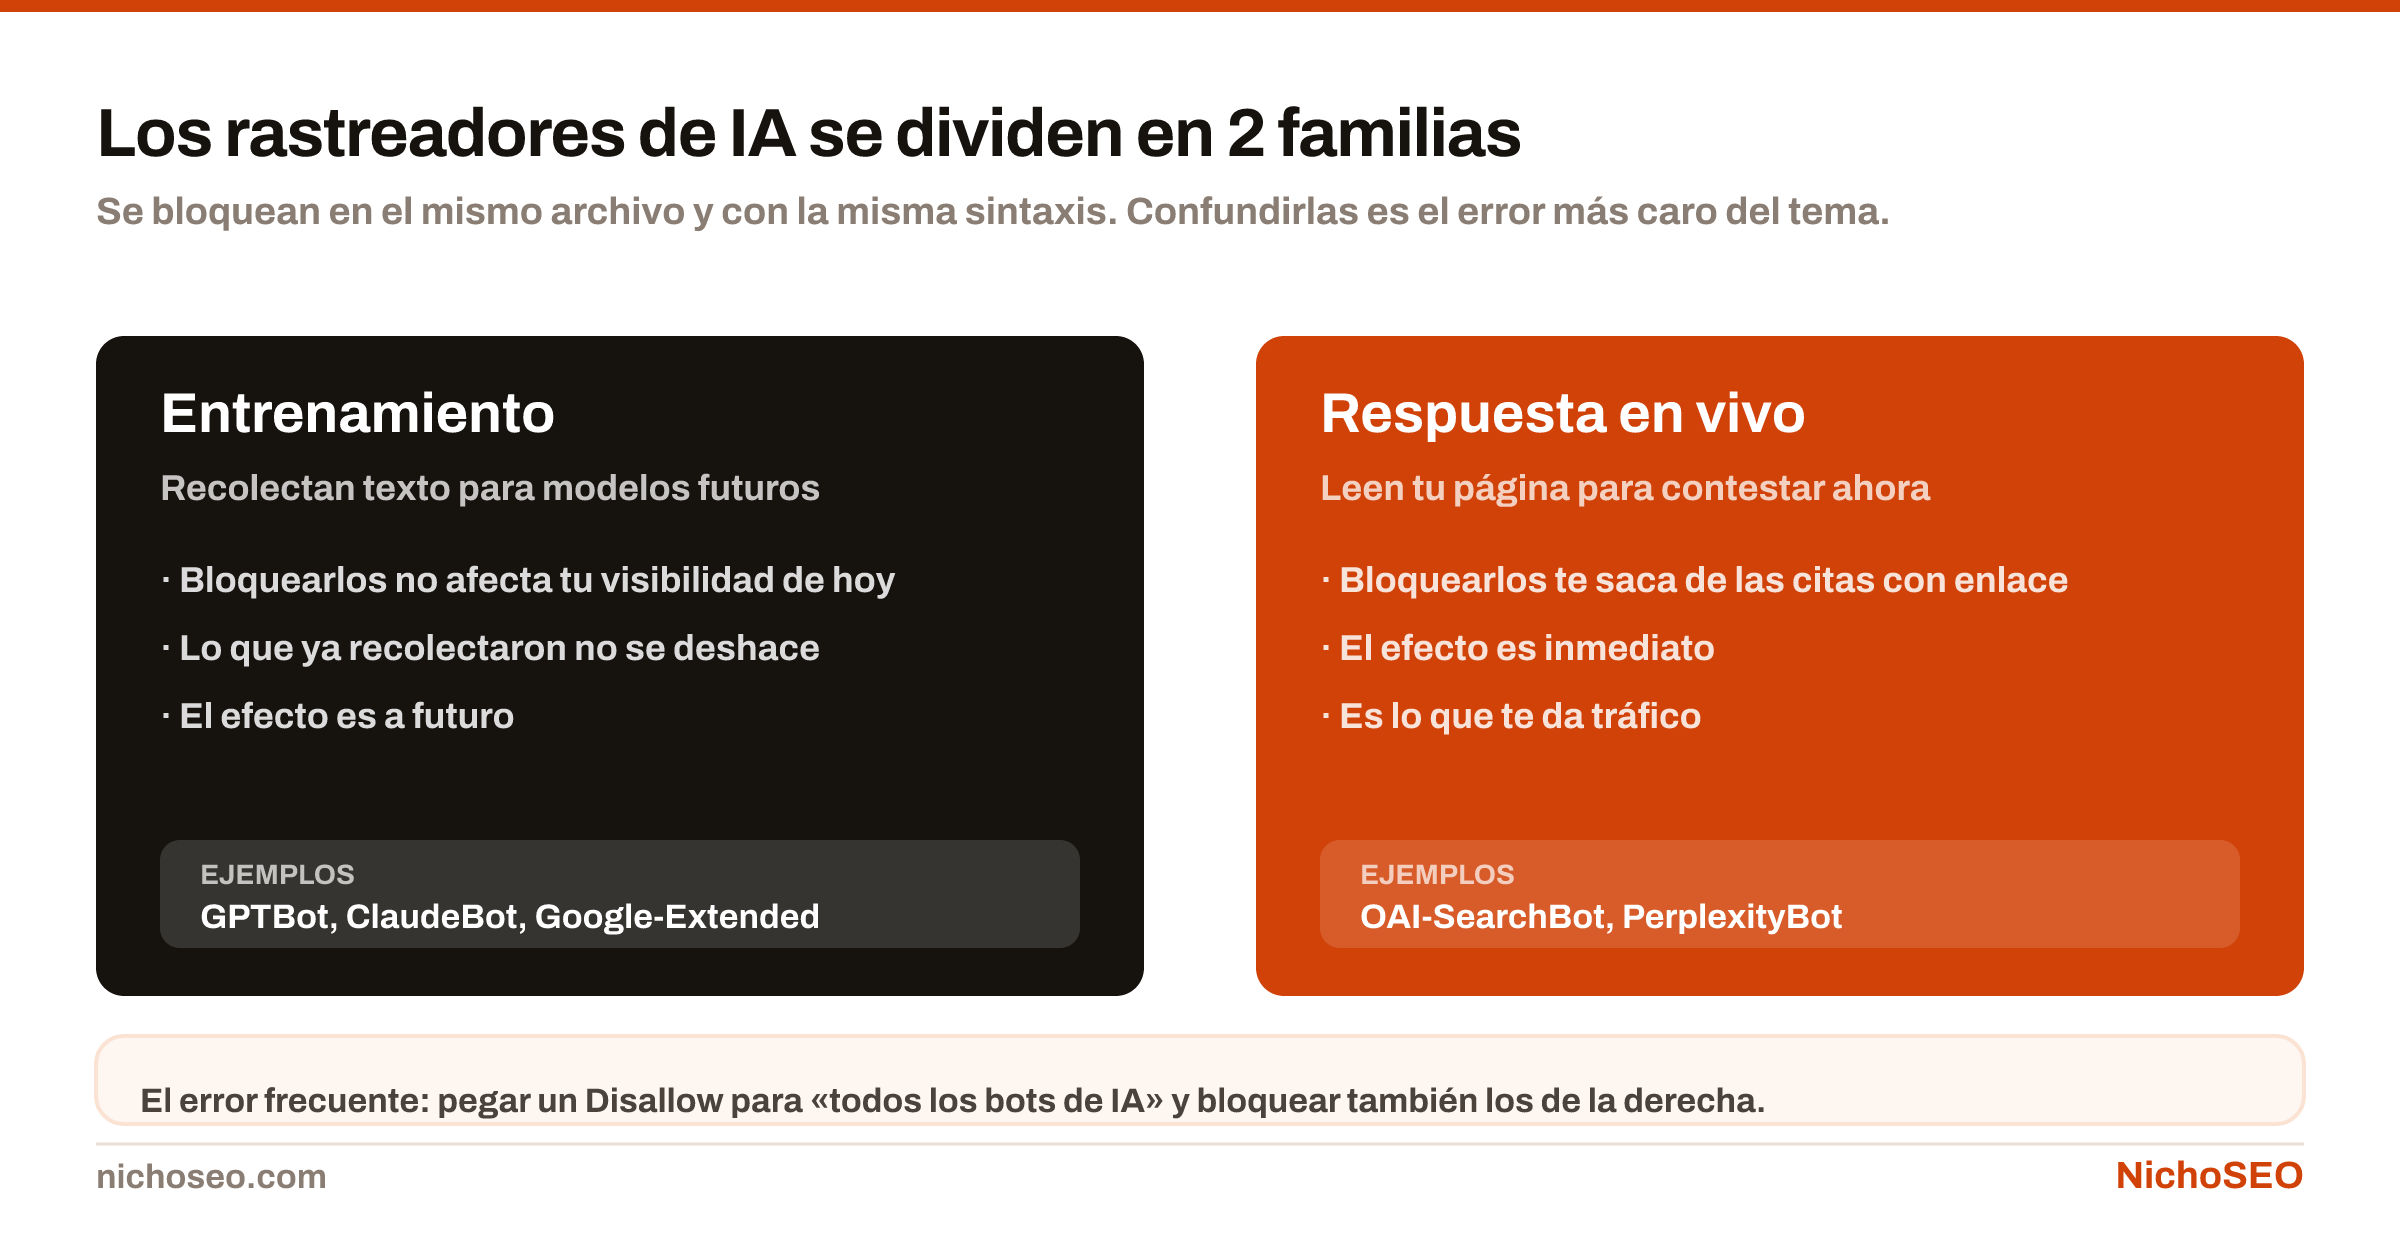
Es una propuesta abierta, publicada por un desarrollador y adoptada primero donde resolvía un problema concreto: la documentación técnica. Una biblioteca de software con cientos de páginas de referencia gana bastante si puede ofrecerle a un asistente de código un índice legible de su propia API, y ahí llms.txt tuvo adopción real.
Lo que pasó después es lo de siempre: la idea se trasladó al marketing de contenidos con expectativas que el caso original no respaldaba. Un asistente de código que lee la documentación de una biblioteca porque el programador se la señaló no se parece a un motor generativo que elige fuentes por su cuenta para responder una consulta pública.
llms.txt vs robots.txt vs sitemap: en qué se diferencian
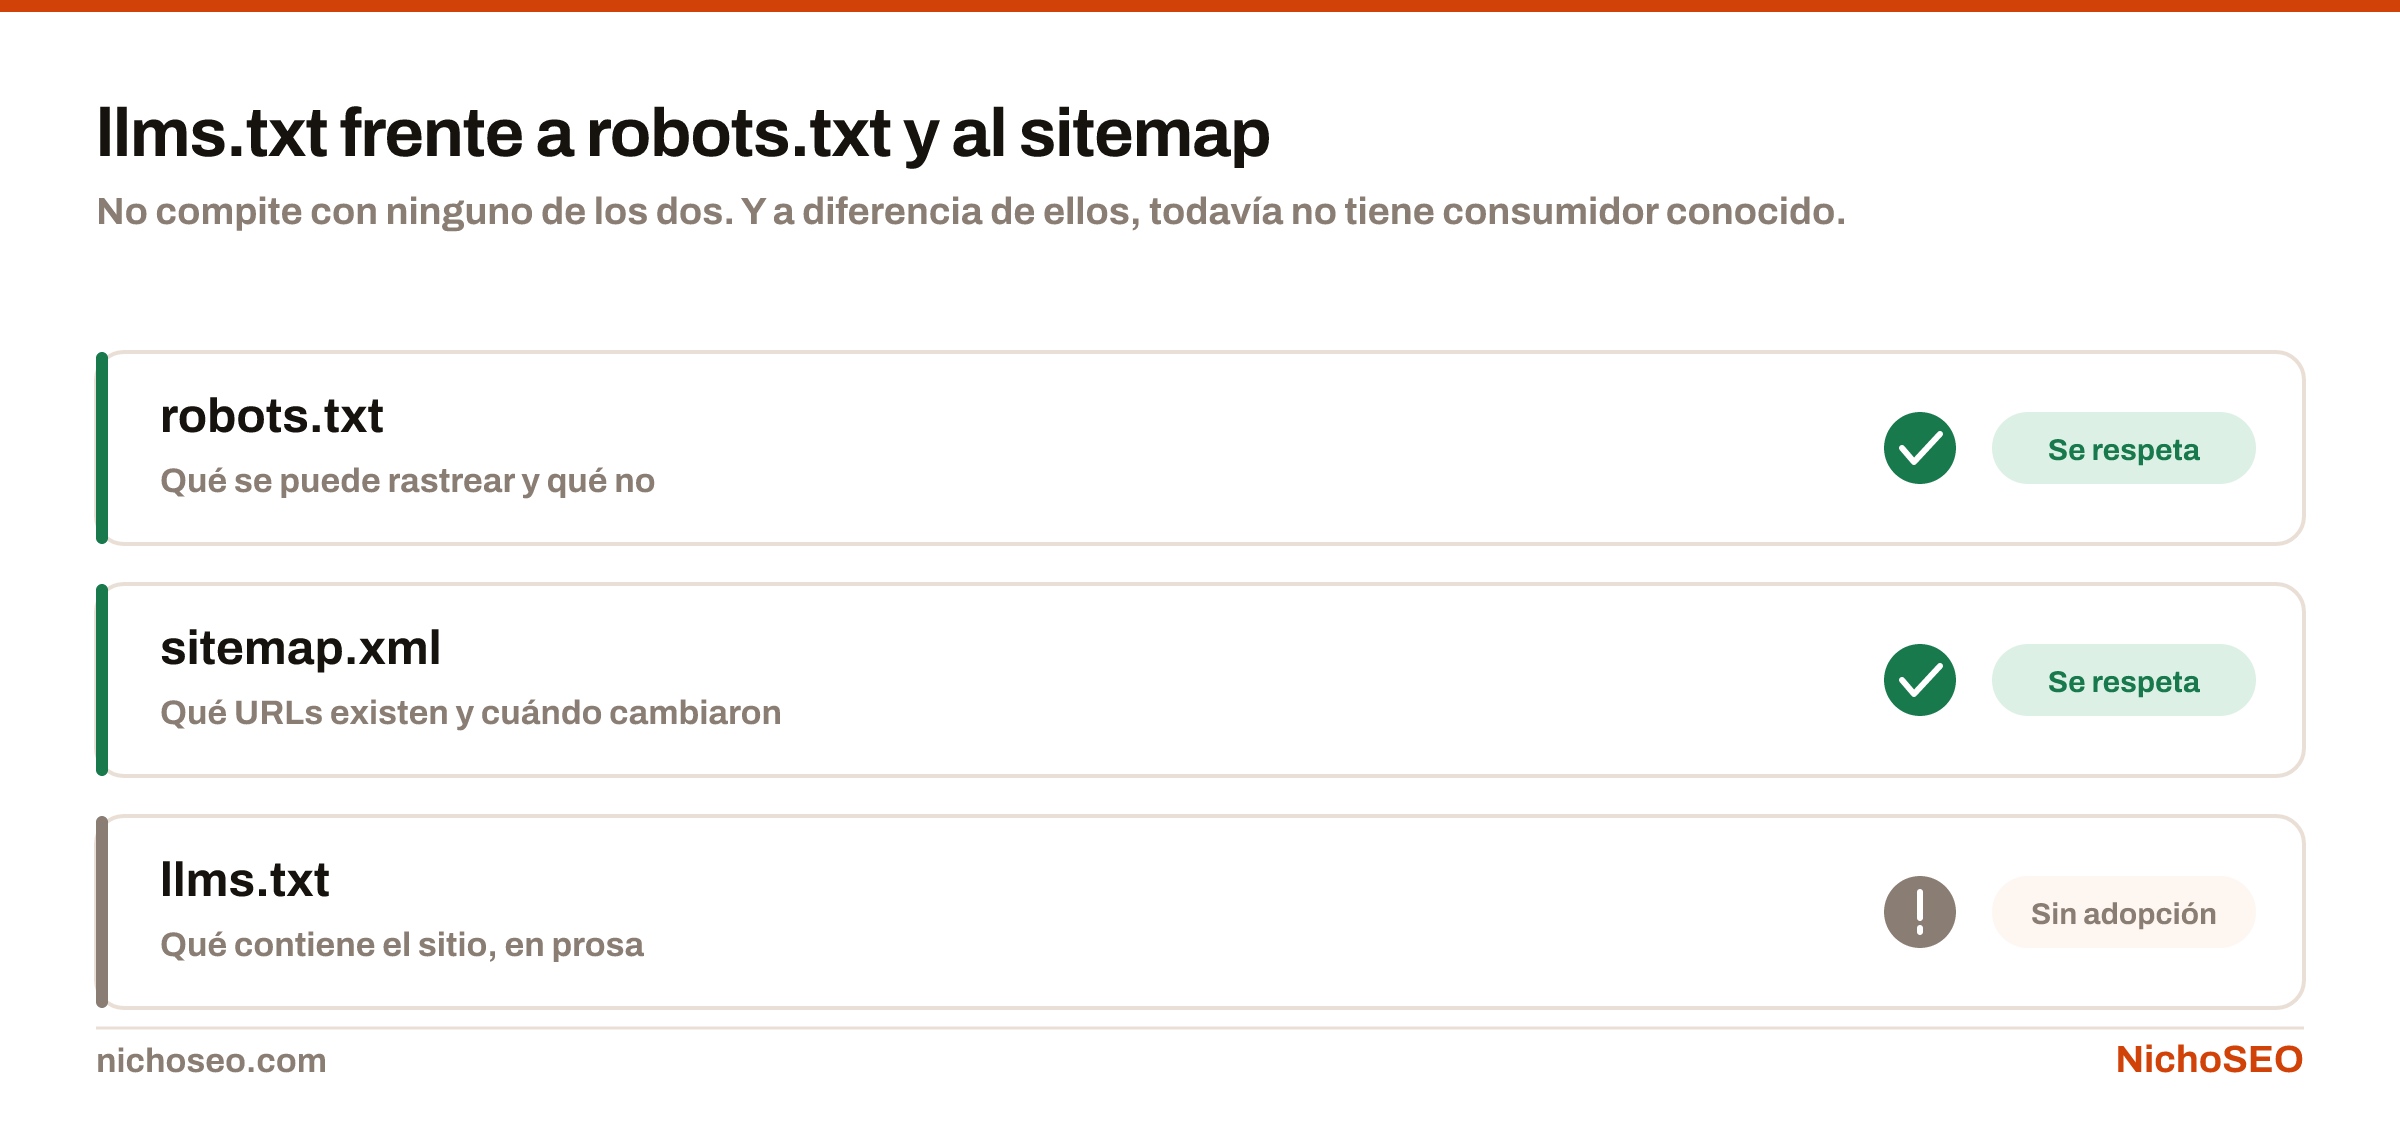
Conviene ubicarlo, porque se lo presenta como si viniera a reemplazar algo:
No compite con ninguno de los dos primeros. El sitemap enumera URLs para una máquina; llms.txt las describe para un lector que entiende lenguaje natural. Son propósitos distintos, y el segundo todavía no tiene consumidor conocido.
El problema: nadie confirmó que lo use
A la fecha de esta revisión, ningún motor generativo grande declaró públicamente que use llms.txt para decidir qué contenido leer o citar. Circula bastante contenido que da esto por hecho. No lo está.
Hay además una objeción razonable que conviene conocer antes de entusiasmarse: un archivo que el dueño del sitio escribe sobre su propio sitio, sin manera de contrastarlo con lo que el sitio realmente dice, es exactamente la clase de señal que históricamente se degradó por abuso. Es la misma razón por la que las palabras clave declaradas en una etiqueta dejaron de importar hace veinte años.
Eso no lo invalida, pero explica por qué la adopción no es automática.
La propuesta original está publicada en llmstxt.org. Para comparar, el estándar que sí se respeta es robots.txt.
¿Conviene poner llms.txt igual? Sí, con tres condiciones
Sí, con las expectativas en su lugar:
- Cuesta poco. Un archivo de texto que se genera en el build.
- No rompe nada. No interfiere con
robots.txt, con el sitemap ni con la indexación. - Si se adopta, ya estás. Y si no, perdiste una hora.
Lo que no hay que hacer es tratarlo como sustituto de lo que sí se sabe que funciona: que te puedan rastrear, que rankees, y que el contenido esté escrito de forma que se pueda recortar sin romperse.
Cómo hacer un llms.txt que no envejezca mal
Generalo en el build, no a mano. Es la única recomendación fuerte de esta entrada. Un índice escrito a mano queda desactualizado en la segunda página nueva, y un índice que miente sobre el contenido del sitio es peor que no tener ninguno.
Incluí solo lo que existe. Listar páginas planificadas, o secciones vacías, le entrega a un lector automático una colección de enlaces que no llevan a ningún texto.
Describí, no vendas. La línea que acompaña a cada enlace sirve para que alguien decida si la página le sirve. Un eslogan no cumple esa función.
Mantené la fecha visible. Si el archivo se genera solo, poner al final cuántas páginas hay y de cuándo es la generación cuesta nada y vuelve el archivo contrastable.
Cómo saber si algún bot lee tu llms.txt
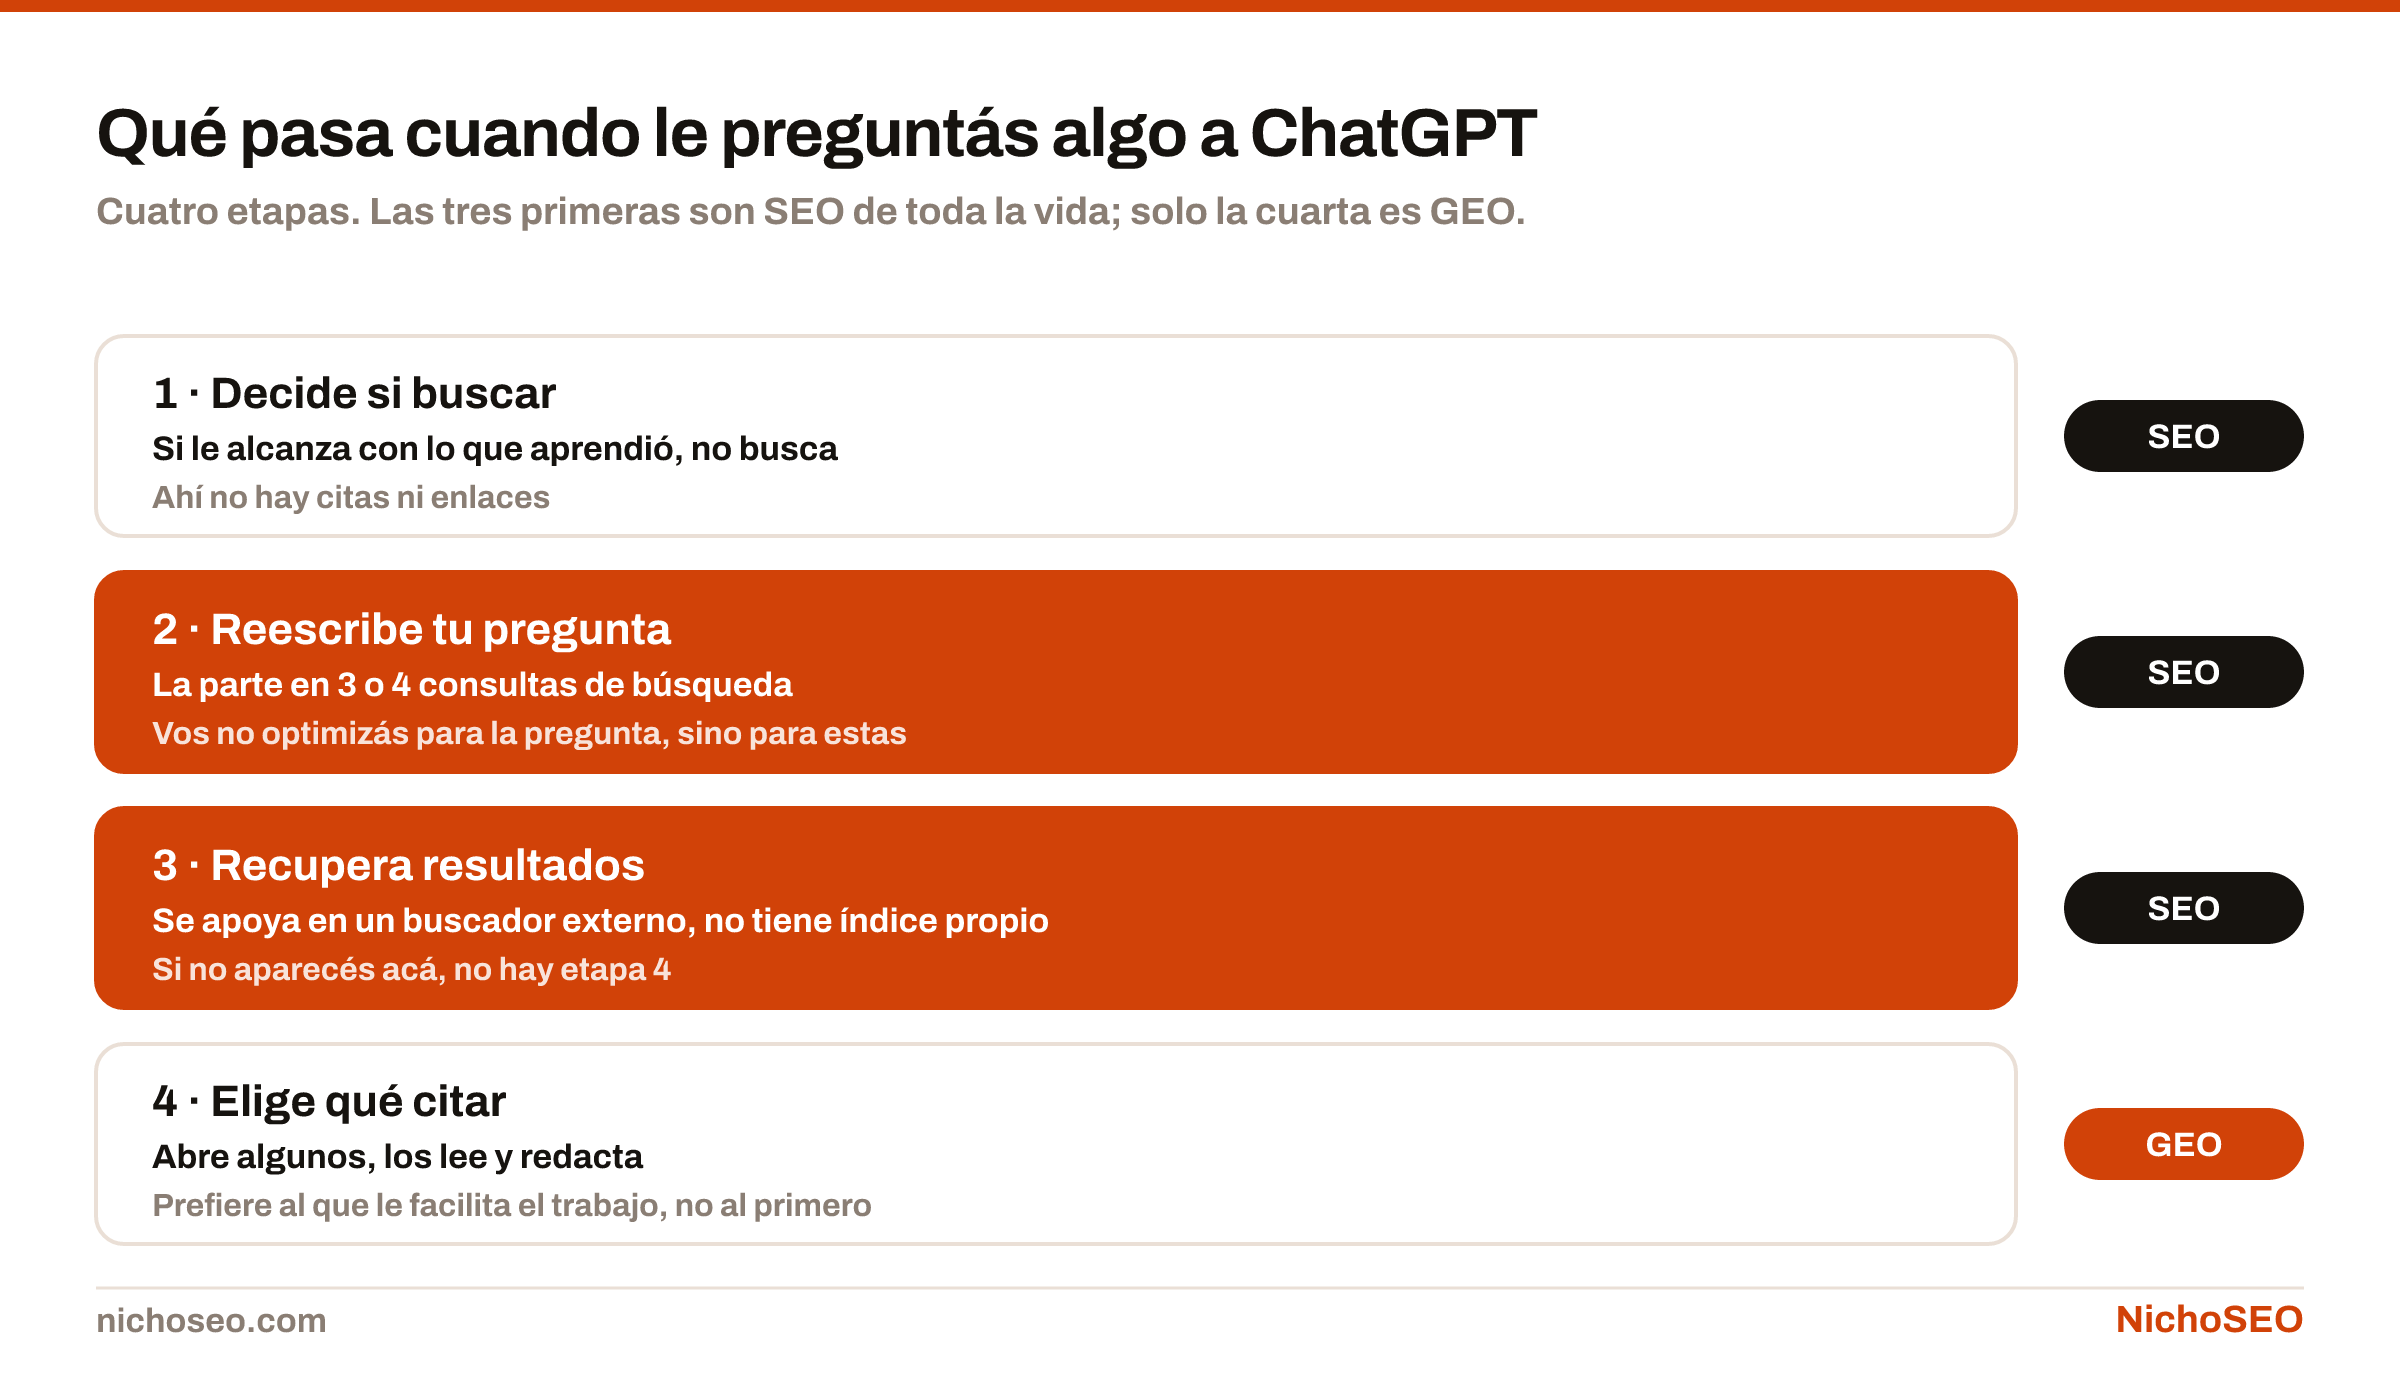
No hace falta especular: está en los registros del servidor. Filtrá las peticiones a /llms.txt y mirá qué agente de usuario las hizo y con qué frecuencia.
Es la única evidencia de primera mano disponible sobre este tema, vale para tu sitio y no para el de nadie más, y contradice o confirma cualquier cosa que hayas leído al respecto —incluida esta entrada—.
Estado de esta entradaRevisada por Sebastián Cardozo el 26 de sept de 2026. Si detectás algo que dejó de estar vigente, o directamente un error, escribinos: se corrige y el cambio queda anotado acá abajo con su fecha.
Historial de revisiones
- Se aplicó el playbook: título y encabezados descriptivos, tarjeta de definición y tres imágenes descargables.
- Se amplió: de dónde viene la propuesta, en qué se diferencia de robots.txt y del sitemap, cómo mantenerlo sin que se desactualice y cómo comprobar si alguien lo lee.
- Publicada.